先人工核查公司的官方页面。导出数据提供的是待调查的名称和说法。最终应形成一份公司关注名单,清楚列出各方角色、支持来源和未解决的问题。
开始前,先定义各方的公司角色
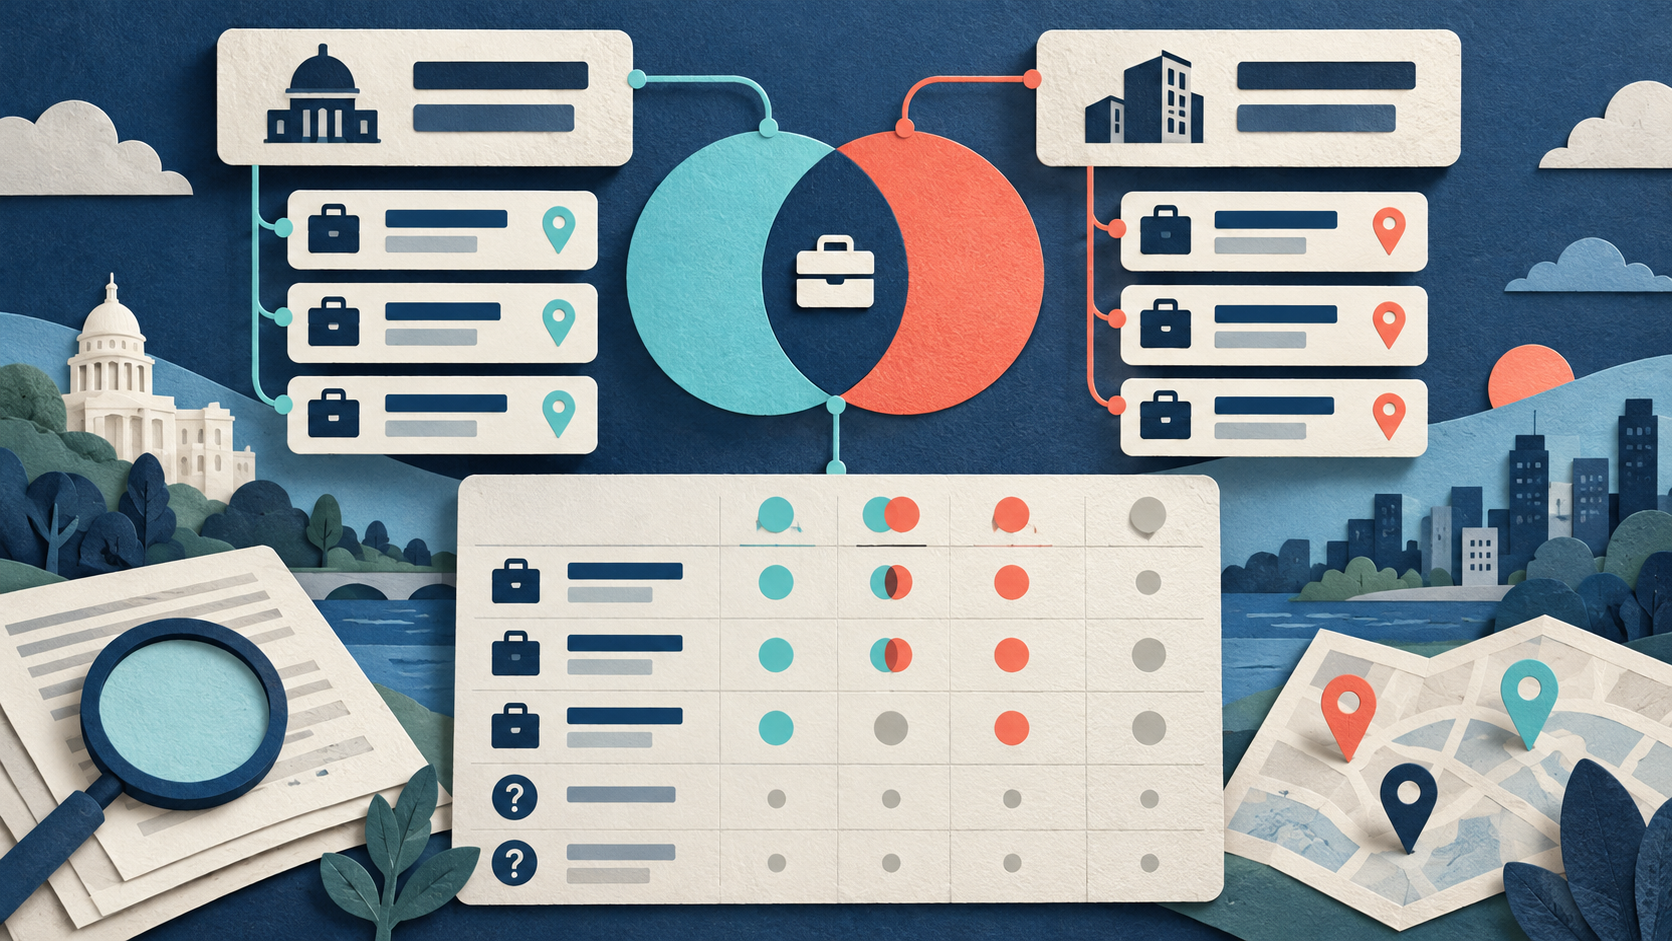
职位发布方是职位信息中显示的发布组织。招聘机构是为客户招聘的组织。职位中注明的最终雇主,是职位信息明确列为该岗位雇主的公司。这些角色可能属于不同组织。同一个组织也可能承担多种角色。
为每种角色保留单独的字段。不要用客户名称替换招聘机构名称。这样做会删去有关职位发布方的证据。
公司身份,是指经核查后确定某个名称所代表的公开经营主体。公司关系用于记录证据中两家企业的关联。核实招聘机构的身份,并不能确认它与某个特定客户的关系。
当多家招聘机构看似在发布同一个职位时,这种区分很重要。在一则发表于2023年12月7日、检索于2026年10月25日的公开讨论中;仅作提问背景,内容未经核实,一位读者描述了多家机构发布的职位信息,其薪酬、用工表述和合同期限各不相同。这一疑问说明有必要核查每项说法由谁提出。但它不能证明这些信息对应同一个空缺,也不能确定雇主身份。
关注名单只回答一个范围有限的问题:出现了哪些具名公司,它们分别承担什么角色,有什么证据?它不能确定这些公司计划招聘多少人。
分开保存源字段和复核字段
保留一份未经修改的导出数据。在单独的工作表中添加复核备注。为每个源数据行设置引用标识,方便其他读者再次找到它。
经核对的 Google Jobs Scraper 公开构建版本声明了以下字段。在数据来源或字段规则允许的情况下,已声明的字段仍可能缺值。
| 源字段 | 本次复核需保留的内容 |
|---|---|
| `companyName` | 原始公司标签,不用核查后的名称替换 |
| `title` | 原样保留职位名称 |
| `description` | 现有的职位描述,包括客户名称及其上下文 |
| `location` | 现有的地点文本 |
| `jobId` | 来源标识符,以文本形式保存 |
| `jobUrl` | 职位信息的网址,如有提供 |
| `observedAt` | 记录的观测时间 |
| `via` | 原始值,不假定它代表雇主 |
| `status` | 原始状态值 |
| `statusReason` | 原始原因值 |
URL 是网页地址。标识符是用于指代某条记录的值。将 `jobId` 与来源名称和观测记录的引用标识一同保存。不要将它用作公司标识符。
这些字段来自公开默认构建版本0.2.30,已于2026年10月25日核对;仅核对字段声明并进行静态验证,未实际运行。这次核查不能证明数据可用、覆盖完整或采集成功。
建立三张小型复核表。名录是保存下来的清单,其中各条目使用固定的引用标识。分别保留公司名录、关系表和源数据行复核表。
| 表 | 建议由分析人员创建的字段 | 用途 |
|---|---|---|
| 公司名录 | `entityRef`, `originalName`, `checkedName`, `aliases`, `officialUrl`, `identityEvidence`, `identityState` | 将公司身份与职位信息中的说法分开记录 |
| 关系表 | `relationshipRef`, `sourceRowRef`, `advertiserRef`, `recruiterRef`, `statedEmployerRef`, `clientState`, `relationshipEvidence` | 记录各方角色和所声称的客户关系 |
| 源数据行复核表 | `sourceRowRef`, `sourceName`, `importRef`, `jobId`, `jobUrl`, `observedAt`, `reviewState`, `reviewReason`, `reviewer`, `reviewedAt`, `nextCheck` | 让每项判断都能追溯到其来源 |
这些是建议的复核字段,不是 Actor 额外输出的字段。Actor 是在托管环境中运行的数据采集程序。
别名是公司使用的另一个名称。保存别名时,应同时保留将其与已核查身份关联起来的证据。拼写相似只能作为进一步调查的理由。
每条证据备注都应保留网页地址、核查日期、相关原文及其支持的结论。将身份证据与关系证据分开记录。一个页面可能只能支持其中一种结论。
按八个步骤建立关注名单
1. 保留每个原始公司标签
将 `companyName` 原样复制到源记录中。在旁边保留职位信息的网址、描述和观测时间。
如果字段缺值,应记录这一状态。不要用搜索词或刊载职位信息的网站名称填补缺失的公司名称。如果网址缺失,保留导入引用标识,并将网址标为不可用。
不要在本次复核中重新进行职位信息匹配。公司身份与职位身份需要分别判断。如需单独复核职位匹配,请参阅重复职位信息与疑似重新发布指南。
2. 根据明确表述确定角色
结合公司标签和职位描述阅读。记录哪个组织是职位发布方,哪个组织承担招聘机构角色,哪个组织被注明为最终雇主。
在每项角色判定旁保留证据原文。描述中注明客户名称,只能支持“职位信息声称存在这项客户关系”这一判断。它不能独立证实该关系。
如果描述只写“我们的客户”,应将雇主身份保留为未知。如果组织的角色不明确,将其标为待核实。不要把每个公司标签都强行填入雇主字段。
同时将 `via` 保留为来源信息。经核对的字段声明不足以支持将其值视为招聘机构或雇主角色的证据。
3. 查找可能对应的公司官方页面
手动搜索具名组织的官方网站。在页面内容支持其对应关系之前,将每个搜索结果视为候选。
核查网站上注明的企业名称和地点,并与职位信息比较。如有相关的公司介绍、联系或招聘页面,也应阅读。记录哪些事实一致,哪些信息仍然缺失。
熟悉的名称或看似合理的网址都不足以确认身份。不要将网址视为存在一家独立法律实体公司的证据。如果公开证据只支持商号或品牌身份,就只描述该公开身份,不添加法律身份方面的说法。
4. 分别核查公司身份和职位编号
招聘需求编号是雇主为某个空缺职位设置的代码。如果职位信息或公司官方页面中出现此编号,应将其保留在复核备注中。它不是本文使用的已声明输出字段之一。
综合比较名称、地点和已有的招聘需求编号。准确记录一致之处。同时记录冲突,例如地点不符,或官方页面显示对应的是另一家企业。
公司官方页面可能支持公司身份判断,却不支持所发布职位的相关说法。官方招聘页面如果列出了该空缺职位,可以为职位信息中的雇主说法提供更直接的证据。应将这两种结论分开记录。
如果找不到支持性的公开证据,应将该说法保留为待核实。没有找到相符的页面,并不能证明公司或职位是虚假的。
5. 仅合并有证据确认属于同一主体的身份记录
为每家已核查的公司设置一个固定的 `entityRef`。只有在证据支持关联时,才将名称变体关联到该引用标识。
不要因名称相同就合并公司。不要将招聘机构与其客户合并。不要将多个未知客户合并为一家未具名公司。
如果两个数据行中出现相同名称,但身份核查尚未完成,应保留各自的候选引用标识,并说明不确定之处。名称重复不能证明它们对应同一家公司。
确认别名后,保留原标签及其来源。其他复核人员应能看出你为何将这些标签关联起来。
6. 保留每项招聘机构与客户关系的说法
在关系表中,为招聘机构和所述客户分别保存引用标识。将这项关系关联到支持它的职位信息。
不要将一条职位信息中的客户说法套用于该机构的所有职位信息。数据行 A 中注明的客户,不能确定数据行 B 中未具名客户的身份。
使用少量含义明确的复核状态。例如,“仅据职位信息”表示关系由职位信息提出。“有公开证据支持”表示已为该关系另行保存公开证据。“待核实”表示现有证据不足以作出判断。
这些状态由分析人员自行设定,并非声称由 Actor 提供的分类。每个状态旁都应保留相应理由。
7. 按实际复核的单位计数
分别报告职位观测记录数、具名候选公司数、已核查的公司身份数,以及待核实的客户关系数。说明每项计数使用的单位。
精确统计已知的不重复雇主数量时,不要计入未具名客户。该客户可能已在关注名单的其他位置出现。现有证据不足以判断。
客户名称缺失不等于客户数量为零,而是客户身份未知。公开核查未能得出结果,也不等于雇主数量为零,而是此次核查未能解决问题。
职位信息数量也不能衡量招聘意向。重复观测和趋势分析应按单独的多次职位快照指南处理。
8. 对公司作出决策前,确定下一步核查
对公司作出决策,是指决定如何处理某家公司,例如是否将其加入研究名单。复核所有可能改变该决策的待核实身份或关系。
为每条待核实记录指定下一项具体核查。例如,检查官方招聘页面、解决地点冲突,或寻求具名客户关系的确认。
将研究候选对象与有公开证据支持的雇主关系分开记录。关注名单中的条目可以成为进一步研究的理由,即使其雇主说法仍待核实。
使用 Actor 采集源数据行
人工身份核查仍是主要方法。Google Jobs Scraper 文档中列出的输入和输出字段适合本流程中的采集环节。这种适用性不代表已测试身份识别的准确性,也不能证明它能完成整份关注名单。
Task 是为 Actor 保存的一组输入配置。Company Hiring Monitor with Google Jobs Task,已于2026年10月25日核查;仅确认页面存在,未验证已保存设置和实际运行情况可作为起点。其准确的 Task ID 为 `lc9Xg20bumfb452dl`。
使用以下建议的小规模输入:
{
  "market": "US-en",
  "maxItems": 3,
  "queries": ["data analyst"]
}将 `data analyst` 替换为要研究的职位。如果目标市场不同,将 `US-en` 替换为受支持的市场值。示例值包含在已核对的输入规则中。本次建议的小规模测试应将 `maxItems` 保持为3。
这组输入已通过静态检查。静态检查是将设置与已声明的输入规则比较,不采集数据。本文编写期间未运行 Actor。此示例是建议的替代输入,并非 Task 当前已保存设置的副本。上限为3,不保证返回三行数据或三家雇主。
自行采集后,先检查返回字段,再开始身份复核。原样保留 `status` 和 `statusReason`。不要自行编造其含义,也不要将保存下来的一行数据视为采集完整的证据。
本方法使用公开职位信息和公司的公开页面,无需使用仅记录所有者可访问的资料,例如非公开的应聘者状态、收件箱消息或内部招聘审批。后续如获得非公开确认,应与公开证据分开保存,并注明其受限的适用范围。
演练一个原创虚构示例
本例为教学用途的原创虚构内容,不是 Actor 运行记录、客户成果或实际观测到的公司发现。
三条虚构的职位观测记录包含以下说法。A、B 和 C 是教学标签,不是真实的来源标识符。
| 观测记录 | 职位发布方 | 招聘机构 | 职位中注明的最终雇主 | 虚构职位信息中的证据 |
|---|---|---|---|---|
| A | Birch Talent | Birch Talent | North Mill | 描述中注明 North Mill 为客户 |
| B | Birch Talent | Birch Talent | 未知客户 | 未注明客户名称 |
| C | North Mill | 未注明 | North Mill | 职位信息直接注明 North Mill |
在 A 和 B 中,保留 Birch Talent 的职位发布方和招聘机构角色。在 A 和 C 中,保留 North Mill 作为职位中注明的最终雇主。B 的客户继续保留为未知。
C 中的“未注明”不等于没有招聘机构,而是这份虚构证据未说明招聘机构是谁。同样,B 缺少客户名称,也不等于 B 没有客户。
关注名单包含两个承担不同角色的具名实体,以及一项待核实的客户关系。重复名称提供了可供核查的候选关联,不能替代官方身份核查。
计算使用以下单位:
- 职位观测记录:A 的1条 + B 的1条 + C 的1条 = 3条观测记录。
- 虚构内容中提供的不同名称:Birch Talent + North Mill = 2个具名实体。
- 注明 North Mill 为最终雇主的观测记录:A + C = 2条包含雇主说法的观测记录。
- 客户未具名的观测记录:B = 1项待核实的客户关系。
不要将2个具名实体与1项未知客户关系相加,报告为3家已确认雇主。这些数量描述的是不同事物。Birch Talent 承担招聘机构角色。未知客户可能是 North Mill,也可能是另一家组织。本例无法回答这个问题。
本例未提供官方身份核查。因此,已确认雇主的数量仍无法确定。不要用零填补这一空缺。这三条观测记录不能用于推算员工数、空缺职位数或已完成录用数。
下一次复核应核查 Birch Talent 和 North Mill 的公开身份。随后,应为 A 中的客户说法寻找单独的支持证据。在证据确定 B 的客户身份前,将 B 保留为待核实。仅核实 North Mill 的身份,不能确认上述任何一项招聘机构与客户的关系。
使用结果前,检查未成功核实的情况
将关注名单用于公司研究前,先复核整份名单。
| 复核情况 | 需要记录的内容 | 仍未解决的问题 |
|---|---|---|
| 公司标签缺失 | 源字段缺值的情况及数据行引用标识 | 公司身份 |
| 未注明客户名称 | 客户身份未知的关系 | 最终雇主身份 |
| 官方页面不可用 | 核查未成功的情况、网址及核查日期 | 正在复核的说法 |
| 名称相似,但没有证据支持关联 | 分别保留的候选对象及尚待回答的问题 | 这些名称是否指向同一家公司 |
| 公司身份有证据支持,关系无证据支持 | 已核查的身份,以及仅据职位信息记录的关系 | 招聘机构与客户的关联 |
| 公开证据相互冲突 | 双方来源及冲突内容 | 应采信哪项说法 |
| 采集失败,或返回的证据不明确 | 采集结果和可用的状态字段 | 是否采集到了预期样本 |
绝不要因核查未成功,就声称职位已关闭或公司已停止招聘。为旧证据保留日期。页面后续发生变化,也不能抹去所保留的职位信息在观测时的原有表述。
同时明确展示导出数据的范围。小规模搜索得到的是采集样本,不是完整的公司目录。如果以后比较不同采集来源,请使用单独的职位数据来源覆盖范围指南,不要将更长的文件视为更准确的雇主名单。
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑