核心区别与定义
职位列表是发布在某一招聘网站上的一条网站帖子。空缺是现实世界中雇主实际在招的一个职位。观察是在采集时捕获的一次数据读取。精确副本是同一条观察被两次导入你的文件。
来源键把平台来源和职位列表 ID 组合在一起,例如 `linkedin:L101`。职位 ID 必须严格作为文本保存。雇主参考编号是雇主提供的职位代码;若职位描述或雇主页面上有该代码,则公开可见。雇主可以重复使用这些公开代码。审核组保存可能的匹配,并记录理由。组是可能的匹配,不是已确认的空缺。
Actor 是托管的数据采集程序。
各招聘网站以不同方式处理帖子。LinkedIn 把已关闭、已过期或已更改后重新发布的职位视为一个新的帖子实例,见 LinkedIn 重新发布指南。这项政策并不能证明 ID 普遍会改变,也不能证明雇主的招聘意图。Indeed 把重复帖子与重新开放的职位分开,见 Indeed 帖子完整性规则。这些规则并不能证明所采集的重复职位列表是不当的。Google 结构化数据规则定义雇主职位标识符,并允许多个地点,详见 Google 职位发布文档。已检查的 Actor 约定(而不是 Google 规则)规定 `jobId` 如何标识网站帖子。
职位分析人员在合并导出数据时使用这些规则。读者询问 LinkedIn 上反复重新发布的职位是否为真实空缺,见 LinkedIn 职位重新发布提问。外部研究跟踪原始帖子、各自计一次的帖子和重复帖子,见 Indeed 数据集分析。这些总数是未经核实的外部背景。公开抓取程序把原始记录采集进数据集,见 Apify 数据集指南。分析人员用这些工具采集行、去除精确重复项,并归组可能的重新发布。
Task 设置与采集设置
Task 是为 Actor 保存的起始配置。Task 采集数据。它不对重新发布分类,也不安排运行。将 LinkedIn 职位导出为 CSV 或 Excel 的 Task 使用 LinkedIn Actor。默认配置请求 25 个职位。Indeed 重新发布职位证据数据集 Task 使用 Indeed Actor。其预设在 15 页中请求 500 个职位。两种工具都采集公开数据,不使用用户登录 Cookie。
在采集测试样本之前调整设置。设置你的搜索查询。将 `maxItems` 设为 3。将 `maxPagesPerSearch` 设为 1。将 `saveOnlyUniqueItems` 保持为 true。在 LinkedIn 上将 `fetchJobDetails` 设为 true,以采集完整描述。检查返回记录上的 `descriptionStatus`。摘要片段不能确立全文匹配。
`saveOnlyUniqueItems` 设置会去除单次运行内的重复职位列表。它不会跨运行归组职位列表,也不会匹配空缺。`maxItems` 设置充当共享的已保存行上限。运行后查看 OUTPUT 摘要。检查 `jobsSaved`、`duplicatesSkipped`、`candidateItemsSeen` 和 `stopReason`。从候选项目中减去已保存职位,并不会自动等于重复计数。
抓取程序把 `scrapedAt` 作为采集时间戳返回。它把 `postedAtRaw` 作为原始来源日期文本或相对时间标签返回。它通过解析精确的来源日期,或根据类似 "6 days ago" 的相对文本推算时间戳,来返回 `postedAt`。保留来源精度,并同时保留这两个字段。推算出的值不是精确的发布时间。审核人员从成功保留的观察中得出 `firstSeen` 和 `lastSeen` 的值,而不是从内置恢复的历史记录中得出。采集覆盖中的缺口并不能证明职位关闭、重新开放或职位已招满。
分析人员使用的 10 步方法
- 保留原始导出。在编辑数据之前,保存一份未更改的来源导出。在工作副本中加入导入文件名和行号,以便找到原始来源记录。
- 构成职位列表键。把来源名称和文本形式的职位 ID 组合起来,例如 `linkedin:L101`。将 ID 作为文本保存。不要仅凭不含来源名称的裸 ID 跨招聘网站关联记录,也不要合并空白 ID。
- 找出被复制的观察。通过比较来源键、`scrapedAt` 和所有保留的来源值,找出精确副本。相等性检查不包括导入文件名、行号和审核备注。来源值不同的记录必须保持为单独的行,以供审核。
- 保留较晚的读取。保留同一职位列表的较晚观察。跨运行保留已更改的职责、职位名称、地点和状态字段。不要把不同采集时间的字段合并成一行。
- 把缺失 ID 的记录单独放好。把没有职位 ID 的记录移到单独的审核表。已检查的来源 URL 可能提供身份线索。职位名称、公司名称、城市和空白字段不能确立自动匹配。
- 建立审核对。只在同一个已检查的雇主范围内比较职位列表。比较职位名称、地点、完整职责和采集时间。比较列只去除首尾空格,但保留原始来源文本不变。保留团队名称、资历级别、地点和雇主参考编号。共有的标准雇佣文本并不能证明职位列表身份相同。不要作出自动匹配的断言。
- 比较职位列表细节。比较完整职责、雇主参考编号、团队、资历、工作类型和地点。同一雇主、同一职位名称和同一城市可以属于各自独立的空缺。不同的雇主参考编号或不同的职责支持各自独立的空缺。相符的雇主参考编号有助于审核,但雇主可以重复使用代码。
- 记录审核选择。把配对标为 `same_listing`、`possible_same_vacancy`、`separate_listing` 或 `unresolved`。记录证据、理由、审核人员姓名和审核日期。`possible_repost` 分类要求有一个较晚的职位列表 ID,并且职责相符。在不同网站上同时发布的帖子是跨来源候选,不是自动认定的重新发布。
- 直接比较组成员。把每一个新加入的成员与组的主要参考职位列表比较。如果职位列表 A 与职位列表 B 匹配,且职位列表 B 与职位列表 C 匹配,职位列表 A 并不会自动与职位列表 C 匹配。把相互冲突的职位列表分开保存。
- 分别计数。把原始行、不同的观察、来源职位列表键和可能的审核组作为各自独立的数字来计数。没有固定的时间窗口或相似度分数能够证明匹配。
分步演算虚构示例:Northshore Tools
所有示例行都属于雇主 Northshore Tools,职位名称为 Data Engineer,地点为 Toronto。所有 ID 都是虚构标签。雇主参考编号是审核人员的备注,不是 Actor 的原生字段。该表显示来自导入文件的六条原始观察。
| 导入行 | 来源键 | 采集时间 | 保留的完整职责文本 |
|---|---|---|---|
| R1 | `linkedin:L101` | 2026-10-01T09:00:00Z | 报告团队,数据仓库中的批处理职责 |
| R2 | `linkedin:L101` | 2026-10-01T09:00:00Z | 报告团队,数据仓库中的批处理职责 |
| R3 | `linkedin:L101` | 2026-10-03T09:00:00Z | 报告团队,数据仓库中的批处理职责 |
| R4 | `linkedin:L202` | 2026-10-05T09:00:00Z | 报告团队,数据仓库中的批处理职责 |
| R5 | `linkedin:L303` | 2026-10-05T09:00:00Z | 产品团队,低延迟数据职责 |
| R6 | `indeed:I90` | 2026-10-05T09:00:00Z | 报告团队,数据仓库中的批处理职责 |
行 R2 中所有底层保留的来源值都与行 R1 相符,包括完整采集时间戳 `2026-10-01T09:00:00Z`。导入行标签不在来源值相等性之内。行 R2 是精确副本。
行 R3 与行 R1 共用同一来源键 `linkedin:L101`,并且包含在较晚时间 `2026-10-03T09:00:00Z` 采集的相同来源值。它是同一条职位列表的较晚读取。将行 R3 与行 R1 一起保留。
归组与计数步骤
- 原始导入行:6 行。
- 去除精确副本:删除行 R2,因为所有来源值都与行 R1 相符。
- 不同的观察:6 - 1 = 5 条有效观察(R1、R3、R4、R5、R6)。
- 来源职位列表键:4 个各自计一次的职位列表键(`linkedin:L101`、`linkedin:L202`、`linkedin:L303`、`indeed:I90`)。
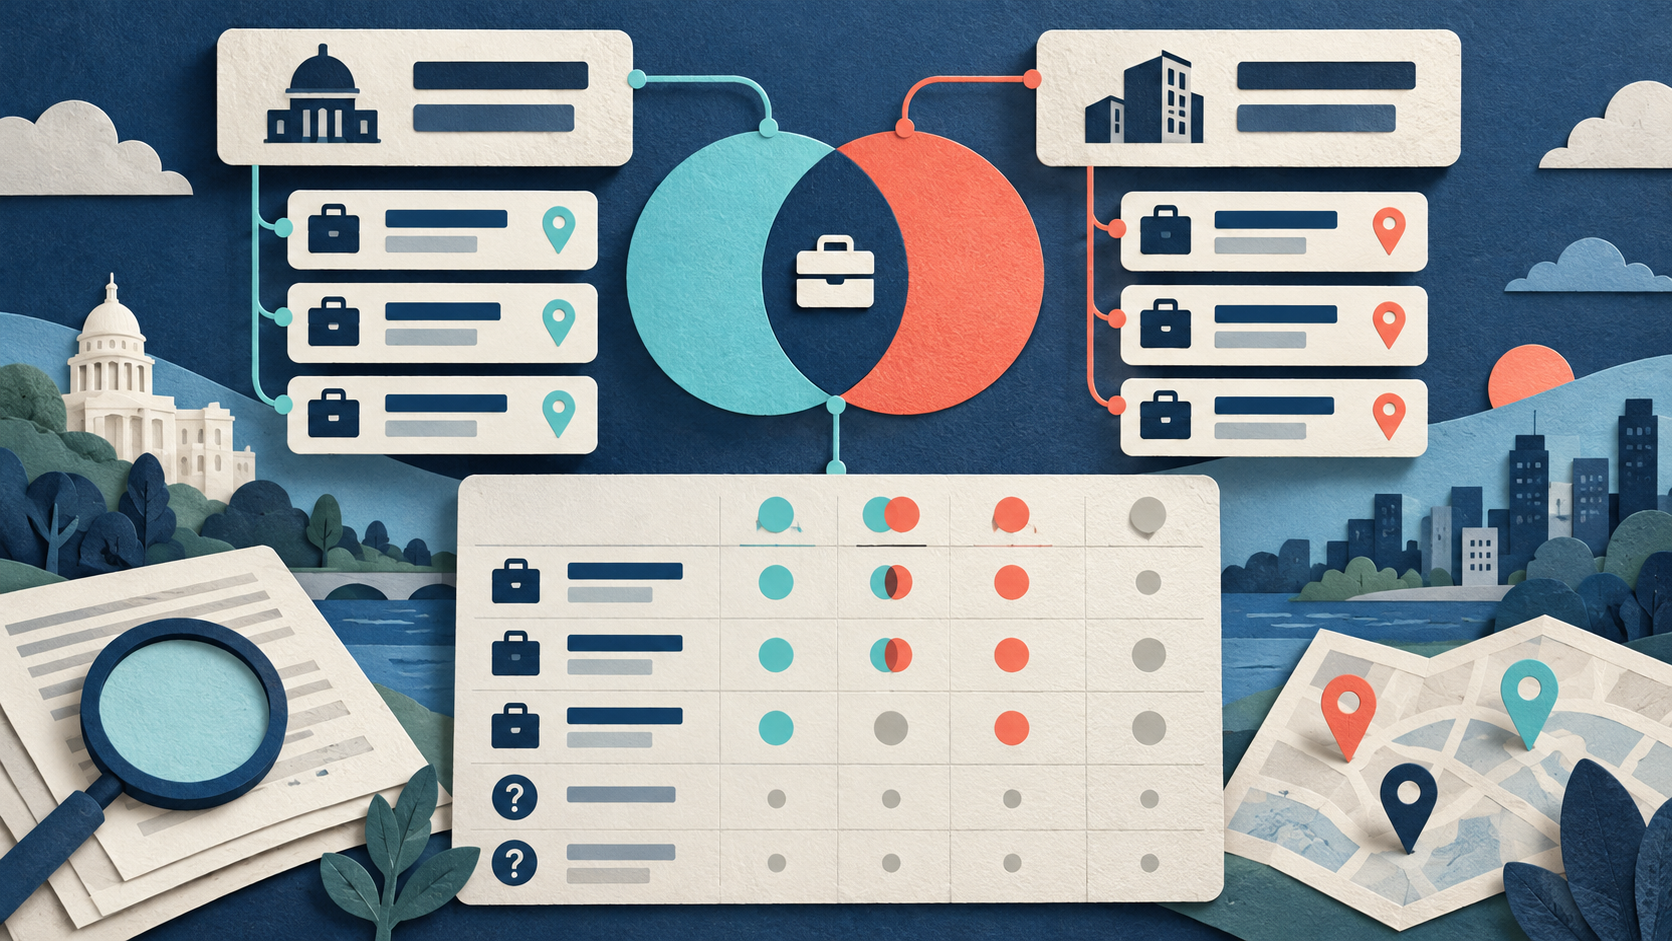
- 可能的审核组:建立了 2 个组。组 G1 包含 `linkedin:L101`、`linkedin:L202` 和 `indeed:I90`,依据是职责相符以及审核人员备注中的参考编号 NT-20。组 G2 包含 `linkedin:L303`,依据是产品团队职责以及审核人员备注中的参考编号 NT-21。
临时审核组决定表
| 审核组 | 职位列表键 | 审核分类 | 审核人员的证据和理由 |
|---|---|---|---|
| G1 | `linkedin:L101`、`linkedin:L202`、`indeed:I90` | `possible_same_vacancy` | 完整职责相符。审核人员记录了描述中出现的雇主参考编号 NT-20。L202 是 L101 的可能重新发布。I90 是跨来源候选。 |
| G2 | `linkedin:L303` | `separate_listing` | 职责指明产品团队和低延迟系统。审核人员注明雇主参考编号 NT-21。与 G1 为分开的职位列表。 |
已确认的空缺数量仍然未知。可能的审核组并不能确认这些帖子是否对应同一个实际空缺,也不能确认当前是否仍可申请。两个临时审核组并不是两个已证实的空缺。
可执行的限制与分析边界
在人工审核之前,把缺少全文的职位列表标为 unresolved。当同一 ID 显示已更改的职责时,在记录中保留这条新观察。当职位名称相符但团队或参考编号不同时,把职位列表分开保存。对于不同地点,审核这些职位列表是各自独立的空缺,还是一条多地点帖子。
如果来源 URL 在核对时失败,记录一次失败的检查。不要假定该职位已关闭或已招满。在备注中保持相互冲突的雇主参考编号可见。按原始格式保留相对时间文本。一次小规模测试运行中的重复计数为零,并不能证明更大规模的运行中没有重复项。
来源和延伸阅读
- LinkedIn 帮助:重新发布已关闭或已过期的职位
- Indeed 雇主帮助:职位帖子完整性与重复项
- Google Search Central:职位发布结构化数据标识符指南
- Apify 文档:数据集存储指南
- Apify Actor:LinkedIn Jobs Scraper
- Apify Actor:Indeed Jobs Scraper
- Apify Task 示例:将 LinkedIn 职位导出为 CSV 或 Excel
- Apify Task 示例:Indeed 重新发布职位证据数据集
- Reddit csMajors 讨论:LinkedIn 重新发布的职位
- Reddit Recruiting Hell 讨论:跟踪职位帖子
作者 Chronometrica · 更新日期
返回顶部 ↑