人们会问哪个职位来源给出最完整的数据。这个问题表明需要比较来源。它并不表明谁胜出。它也不表明市场规模。这个公开问题在 Reddit。
Actor 是一个托管程序,用来采集数据。Task 是为 Actor 保存的输入预设。Actor 保存来源行。比较由你自己完成。Task 不会替你比较来源。这个方法不会为每个用户给来源排名。它不给薪酬打分。它也不按成本给工具排名。
一次运行是用一份输入做的一次采集。一条原始行是审查前保存的一条职位信息。来源 id 是该来源上的职位信息编号。一条有用职位信息符合你的职位、市场和窗口,并且有已知的来源 id。重复项是同一条职位信息被保存了不止一次。重新发布是同一个职位空缺再次发布。一个机会是你把重复项和重新发布归组之后的一个职位空缺。字段覆盖是所需字段在有用职位信息中出现的频率。市场覆盖是这次测试采集到了哪些职位空缺。这是不同的事实。
采取八项行动
- 写下决策以及你需要的字段。
写下你必须做出的选择。做公开职位市场研究时,你通常需要四项事实。你需要来源名称、职位、地点,以及一份可用的描述。声明职位。声明市场。声明语言。声明发布窗口。声明你采集各行的日期和时间。声明纳入规则。纳入规则说明哪些行算作你想要的职位。
为这次小型测试选择两个来源。不要假定它们列出相同的职位空缺。一个面板是一个职位、一个市场、一个窗口和一个来源。在两个来源上使用相同的面板规则。如果职位或窗口改变,这些文件回答的是不同问题。你无法公平地比较它们。
当前的 LinkedIn 招聘趋势 Task 覆盖的职位范围较广。它不是你的比较面板。它的搜索词是分三行的三个职位:software engineer、data analyst 和 product manager。它的 startUrls 列表为空。startUrls 是可选的待打开页面列表。saveOnlyUniqueItems 为 true。该设置在保存时只保留重复职位信息的一份副本。把这三个职位换成你声明的一个职位。加上一个匹配的地点和一个窗口。让 startUrls 保持为空。这条路径是关键词搜索。不要用已知的职位页面地址替换搜索词。
- 设置可以比较的预算和筛选条件。
为每个来源写下搜索词、页面上限和行上限。上限是你允许该次运行保存的最多行数。上限限制你能看到的内容。它不是市场中的职位数量。如果一个来源达到上限,另一个来源提前停止,原始计数就不是对等的证据。达到上限的来源可能还有比你已保存数量更多的匹配职位。记录实际运行的输入。记录每次运行停止的原因。
使用 2026 年 10 月 13 日核对过的输入名称。更新的公开页面可能会改变它们。在依赖旧列表之前,先阅读当前名称。
LinkedIn Jobs Actor 的公开构建 0.2.19 支持 searchTerm、location、postedWithin、maxItems、maxPagesPerSearch、saveOnlyUniqueItems 和 fetchJobDetails。它也支持其当前输入列表中的其他筛选条件。fetchJobDetails 为 true 时,会让该次运行尝试保存完整的职位文本。一个小型 LinkedIn 示例可以使用职位 software engineer、一个市场、postedWithin 为 any、maxItems 为 3,以及 maxPagesPerSearch 为 1。同时设置 saveOnlyUniqueItems 为 true,fetchJobDetails 为 true。只有当你声明的窗口就是该控件所指的全部范围时,any 这个值才正确。
Indeed Jobs Task 对应 Indeed Jobs 公开构建 1.2.14。该构建支持 searchTerm、country、location、maxItems、maxPagesPerSearch、postedWithinDays 和 saveOnlyUniqueItems。它也支持其当前的可选筛选条件。使用一个匹配的国家、地点和职位。不要把最低薪酬设为大于零。薪酬筛选会隐藏职位信息。这会改变覆盖计数。一个小型 Indeed 示例可以使用 maxItems 为 2、maxPagesPerSearch 为 1,以及 saveOnlyUniqueItems 为 true。
3 行示例和 2 行示例不是一对匹配的预算。它们只说明一次极小的运行是有效输入。为了比较,在两个来源上设置相同的 maxItems。在两个来源上设置相同的 maxPagesPerSearch。如果一个来源不能接受该数字,写下这一差异。
LinkedIn 使用 postedWithin。Indeed 使用 postedWithinDays。这些控件不是同一输入。为你声明的窗口,在每个来源上选择最接近的允许值。如果窗口仍然不同,写下这一不匹配。不要把这些样本称为相等。
Indeed 有一个 country 输入。已核对的 LinkedIn 输入使用 location,而不是单独的国家字段。把 Indeed 的 country 和 location 设为你写入 LinkedIn location 的同一个已声明市场。如果地点控件仍然不同,写下这一差异。
这个 LinkedIn 块是一个小型示例输入结构。替换市场标记。如果你声明了不同的职位,就替换职位。SET_YOUR_MARKET 是提醒,不是真实地点。
{
  "searchTerm": "software engineer",
  "location": "SET_YOUR_MARKET",
  "postedWithin": "any",
  "maxItems": 3,
  "maxPagesPerSearch": 1,
  "saveOnlyUniqueItems": true,
  "fetchJobDetails": true,
  "startUrls": []
}这个 Indeed 块是一个小型示例输入结构。SET_THE_CLOSEST_ALLOWED_VALUE 是提醒,不是真实的 Indeed 设置。把最接近的允许天数填在那里。不要添加最低薪酬。
{
  "searchTerm": "software engineer",
  "country": "SET_YOUR_COUNTRY",
  "location": "SET_YOUR_MARKET",
  "postedWithinDays": "SET_THE_CLOSEST_ALLOWED_VALUE",
  "maxItems": 2,
  "maxPagesPerSearch": 1,
  "saveOnlyUniqueItems": true
}对这些控件做过核对的运行保存了四类值。它们保存了非空的来源职位信息 id。它们保存了来源页面地址。它们保存了采集时间。它们保存了完整描述。那些运行使用了不同地点和不同窗口。两者都在较小的行上限处停止。该核对表明,Actor 能在那些输入上保存这些字段。它不是匹配测试。它不是排名。没有核实过任何真实的共享职位对。没有核实过任何完整覆盖数字。把这些相同的输入约定复用到你自己的匹配面板。
- 分别采集每个来源,然后给各行分类。
在比较来源之前,把每条已保存的行分入一个组。让这些组保持分开。
- 有用行。
- 超出职位、市场或窗口的行。
- 同一保存文件内的重复项。
- 没有来源 id 的行。
- 被阻止或失败的请求。
- 达到上限的搜索。
交代你计划运行的每份输入。被拒绝的运行可以返回零行。这个零并不能证明没有职位。把失败与真正的空结果分开。如果你不知道某个计数,就让它保持未知。不要在它的位置写上零。混入的零会让被阻止的来源看起来像是空的。
- 对两个样本使用同一规则。
对每一行以相同方式阅读职位、地点和窗口。完整描述文本可以判定困难情形。仅有标题可能过于含糊。descriptionStatus 为 full 表示已保存完整描述。这并不表示你编造了一个短文本标签。
如果日期缺失而你的规则需要日期,就让该行保持未解决。如果市场缺失而你的规则需要市场,就让该行保持未解决。你发送的市场并不能证明每条职位信息都在该地点。职位信息文本可以写另一个地点。
有意映射各列。每个来源使用自己的字段名。在原始保存中保留那些原始名称。用它们填写比较列。URL 是一条职位信息的页面地址。
| 比较列 | 你存储的内容 |
|---|---|
| 来源与职位 id | 来源名称加上它自己的职位信息 id |
| title | 职位标题文本 |
| companyName | 雇主名称 |
| locationRaw | 按保存原样的地点文本 |
| jobUrl | 职位信息页面地址 |
| descriptionText | 描述文字 |
| descriptionStatus | 描述是否完整 |
| scrapedAt | 你采集该行的时间 |
| query | 你发送的搜索词 |
| searchLocation | 你发送的市场 |
| 运行上下文 | 你运行的输入以及它停止的原因 |
在每一列旁边写下原始来源字段。映射比较列时,原始字段名必须仍留在原始数据中。LinkedIn 的 postedAt 可以根据相对时间短语计算。相对时间短语说明该发布出现在多久以前。该值不是发布时间的精确证明。Indeed 的时间值保持该来源所陈述的含义。postedWithinDays 也保持该来源含义。可选字段可以缺失。职位信息 id 可以缺失。行数并不能证明你找到了每一个职位空缺。行数并不能证明一个职位是真实的。
- 比较审查后的机会,而不是原始 id 数字。
先在每个来源内部归组重复项和重新发布。然后审查两个来源之间可能的匹配。用这些审查后的组做比较。不要把一个职位空缺的两次保存计为两个职位空缺。
来源 id 只在该来源的命名空间内唯一。命名空间是该来源自己的 id 集合。绝不要因为数字相同就把 LinkedIn 职位 id 与 Indeed 职位 id 连接起来。相同的数字可以属于不同的职位信息。
为每一个待核对的职位配对保留两个来源 URL。来源 URL 是该职位信息的页面地址。保留 LinkedIn URL 和 Indeed URL。不要用一个 URL 替换另一个。
比较雇主。比较职位。职位是该职位信息要求一个人做的工作,不只是标题行。比较地点。比较可用的需求编号。需求编号是职位信息显示出一个编号时,雇主的空缺编号。比较完整措辞。比较观察时间的上下文。观察时间是你看到该职位信息的时间。上下文是该职位信息在那个时间所说的内容。
只有这些事实一致时,才确认一个职位配对。在每个已确认的职位配对上保留两个 URL。
仅有标题不是确认。仅有 id 不是确认。同一雇主和相似标题仍然需要这一审查。它们不是自动匹配。
证据不足的职位配对保持不确定。证据冲突的职位配对保持不确定。证据不足的职位配对缺少事实,或只有部分事实相同。证据冲突的职位配对中的事实并不一致。不同的需求编号不一致。描述另一个职位空缺的措辞不一致。显示两个不同职位空缺的观察时间不一致。把不确定的匹配留在已确认重叠之外。
- 建立已确认集合并计数四个组。
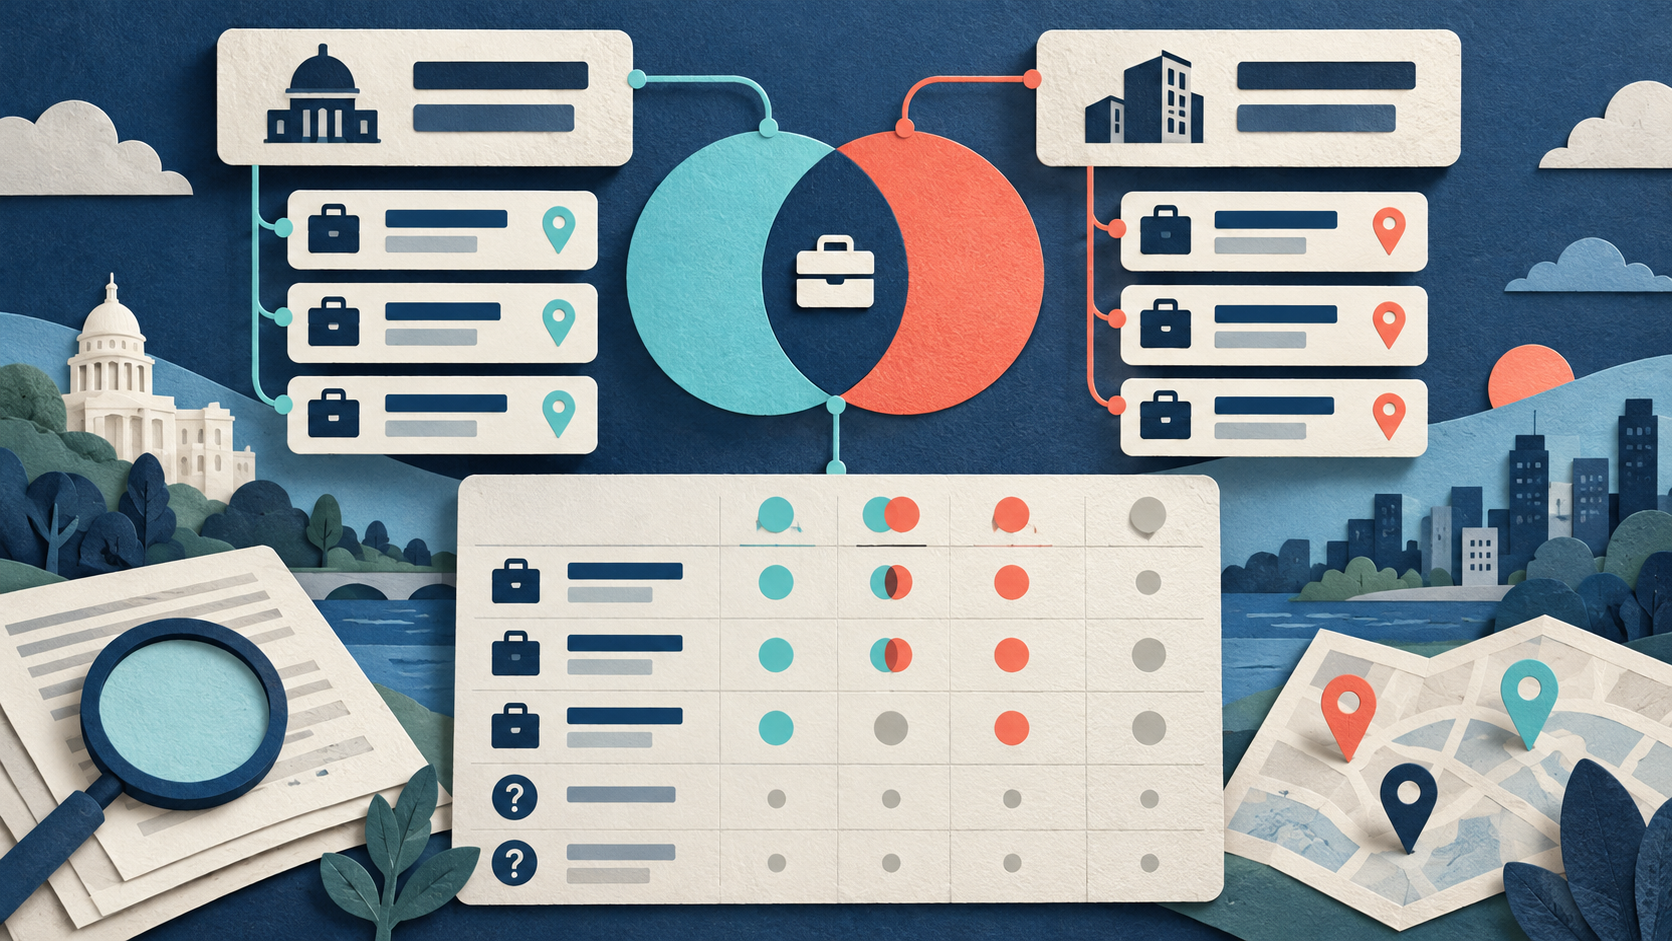
把第一个来源中已确认的有用机会称为集合 A。把第二个来源称为集合 B。计数四个组。并集是这次采集测试中每一个已确认的机会。交集是你确认的重叠。仅 A 的机会出现在 A 中而不在 B 中。仅 B 的机会出现在 B 中而不在 A 中。把不确定的匹配作为单独计数报告。不要把它们强行放入交集。
并集只覆盖这次采集的测试。它不是该市场中每一个在招职位。不要对这些计数使用捕获-再捕获。捕获-再捕获根据两个样本的重叠来猜测总体。它需要随机样本。它需要相互独立的样本。这些来源不是随机样本。同一职位可以因你没有测量的原因出现在两边。报告这四个计数。不要把它们变成整个市场的总数。
- 在每个有用样本内比较所需字段。
用完整描述的数量,除以有已知来源 id 的有用职位信息的数量。该份额是描述的字段覆盖。把缺失的来源 id 作为它们自己的计数报告。不要删除它们,然后说得好像每一条已保存的行都是有用的。没有来源 id 的行仍可以是真实的行,但它对匹配提供的支持更弱。
字段覆盖不是市场覆盖。一个来源可以只增加很少的新机会,但仍然重要。当它提供你需要的字段时,它就重要。只有在你测量过成本数字时才保留成本数字。只有在你测量过工作量数字时才保留工作量数字。不要编造一个最便宜的来源。不要编造一个最佳来源。
- 只为这一决策选择组合。
根据新增的已确认机会和所需字段来选择。增加很少的来源仍可以留在组合中。当它的行提供你无法从另一个来源得到的字段时,保留它。如果采集失败,重复同一个已声明的面板。如果不确定性大到无法决策,重复同一个面板。不要只为增加行数而重复。更多行并不能修复被阻止的运行。更多行并不能修复模糊匹配。不要把一个来源称为对所有职位和市场都最佳。
演算一次虚构的匹配测试
本节中的数字是虚构的。它们用来教算术。它们不是产品结果。它们不是上面那些核对过的运行。来源 A 和来源 B 只是标签。这个虚构示例不说明哪个标签是 LinkedIn。这个虚构示例不说明哪个标签是 Indeed。J1 到 J8 是机会标签。它们不是来源 id。
在这个虚构示例中,两个面板使用相同的职位、市场和窗口。来源 A 保存 8 条原始行。来源 B 保存 7 条原始行。审查后,A 中留下 6 条有用、且来源职位信息 id 已知的职位信息。审查后,B 中留下 5 条有用、且来源职位信息 id 已知的职位信息。减少的部分把不相关行和重复行合在一起交代。这个虚构示例不拆分这两个原因。不要编造这一拆分。缺失的来源 id 没有说明。让它们保持未知。不要用零填上。
| 指标 | 来源 A | 来源 B |
|---|---|---|
| 原始行 | 8 | 7 |
| 有已知来源 id 的有用职位信息 | 6 | 5 |
| 原始行中有用行的份额 | 6/8 = 75% | 5/7 = 71.4% |
| 有用职位信息上的完整描述 | 6 条中的 5 条 = 83.3% | 5 条中的 4 条 = 80% |
| 停止 | 达到其上限 | 在达到其上限之前结束 |
| 未解决的匹配 | 这个虚构示例中没有 | 这个虚构示例中没有 |
| 缺失的来源 id | 未说明 | 未说明 |
| 未使用原始行的拆分 | 未说明 | 未说明 |
75% 和 71.4% 这两个份额使用这个虚构示例的规则。它们不是某个来源的准确度分数。6 除以 8 得到 75%。5 除以 7 得到 71.4%。
审查后的集合是:
- A = {J1, J2, J3, J4, J5, J6}
- B = {J4, J5, J6, J7, J8}
| 机会 | 在 A 中 | 在 B 中 | 组 |
|---|---|---|---|
| J1 | 是 | 否 | 仅 A |
| J2 | 是 | 否 | 仅 A |
| J3 | 是 | 否 | 仅 A |
| J4 | 是 | 是 | 两者 |
| J5 | 是 | 是 | 两者 |
| J6 | 是 | 是 | 两者 |
| J7 | 否 | 是 | 仅 B |
| J8 | 否 | 是 | 仅 B |
交集是 {J4, J5, J6}。计数是 3。并集是 {J1, J2, J3, J4, J5, J6, J7, J8}。计数是 8。仅 A 是 {J1, J2, J3}。计数是 3。仅 B 是 {J7, J8}。计数是 2。这个虚构示例中每一个纳入的匹配都已解决。没有一个职位配对处在不确定组中。
把 B 加到 A 上会增加 2 个已确认机会。两个份额描述这一增加。它们回答不同的问题。使用与你的问题匹配的份额。
- 新机会除以 A 的 6:2/6 = 33.3%。当你问 B 为 A 增加了多少时,使用这个份额。
- 仅 B 的机会除以 8 个机会的并集:2/8 = 25%。当你问采集到的并集中有哪一部分只来自 B 时,使用这个份额。
不要互换这两个份额。第一个份额以 A 的有用集合为基数。第二个份额以采集到的并集为基数。
来源 A 在 6 条有用职位信息中的 5 条上有完整描述。5 除以 6 得到 83.3%。来源 B 在 5 条有用职位信息中的 4 条上有完整描述。4 除以 5 得到 80%。这些是字段份额。它们不测量整个市场。
在这个虚构示例中,A 达到了其上限。B 在达到其上限之前结束。两个集合都不是在招职位的完整计数。如果后来的运行使用更高的上限和相同规则,仅 A 的计数可以上升。这个虚构示例中的选择可以是:以 A 为主要来源,再加上 B 以获得那 2 个新增机会。该选择只适合这一已声明的测试。它不是普遍排名。展示字段、集合、停止情况和未知计数。
这个虚构示例没有给出发布日期。空白日期不是第 0 天。如果你的窗口规则需要日期,该行保持未解决。这个虚构示例没有那样的未解决行。一个真实的不确定匹配,在你选择之前需要它自己的计数。
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑