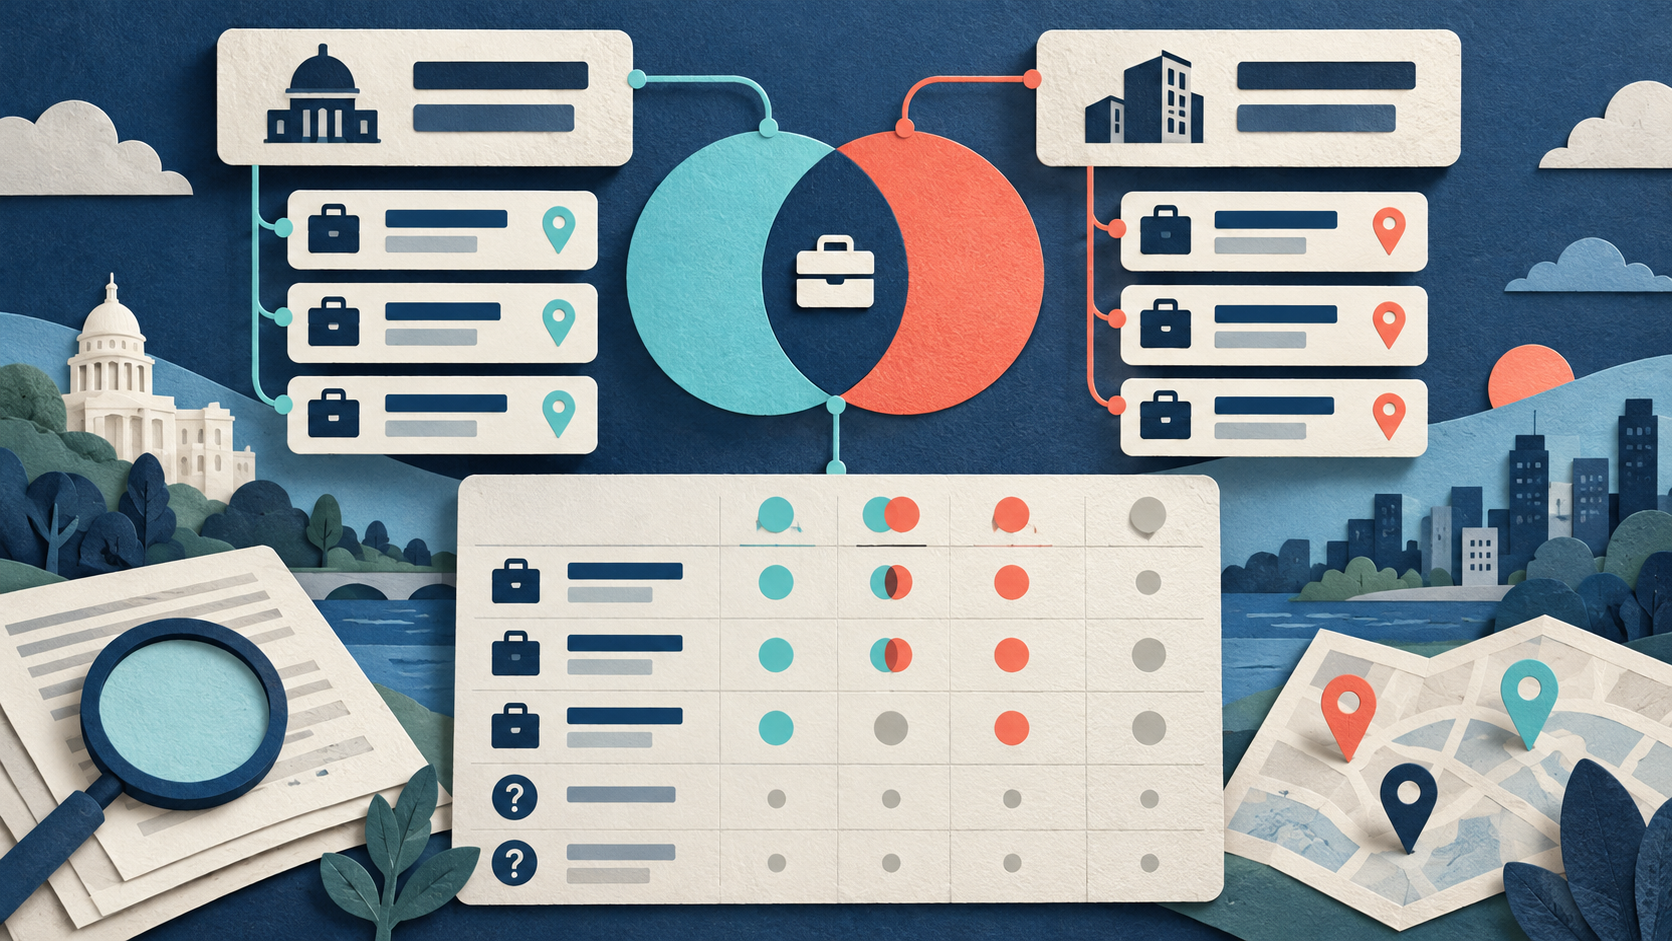
网页上的自动收集器称为 Actor。为 Actor 保存的一组设置称为 Task。当职位抓取器只导出 5 个职位,而网页上显示 50 个或更多时,人们常猜测是分页导致行缺失。分页是网站把一份长列表拆到多个页面的方式。猜测并不安全,因为筛选条件、行数限制或被拦截的页面也可能造成完全相同的结果。在更改设置之前,你必须用明确证据检验每一种原因。
+-----------------------------------------------------------------------+
|                       Check Output Summary                            |
+-----------------------------------------------------------------------+
                                   |
         +-------------------------+-------------------------+
         |                                                   |
         v                                                   v
[stopReason matches reported cap]                   [failedRequests > 0]
         |                                                   |
         v                                                   v
Row cap or page limit hit based                      Request failures recorded;
on actual stored stop evidence. cause remains unresolved.公开的 LinkedIn Jobs Scraper 及其 预设 Task 示例 规定了收集规则。当前已保存的输入把 `searchTerm` 设为 software engineer,把 `maxItems` 设为 100,把 `maxPagesPerSearch` 设为 2,把 `postedWithin` 设为 7d,把 `saveOnlyUniqueItems` 设为 true,并把 `fetchJobDetails` 设为 true。你的试点测试会替换查询,把 `maxItems` 设为 3,并把 `maxPagesPerSearch` 设为 1。不同的输入模式共用同一个行数上限。保留这些确切的输出字段:`jobId`、`jobUrl`、`title`、`companyName`、`locationRaw`、`descriptionStatus` 和 `scrapedAt`。检查这些确切可用的输出摘要键:`candidateItemsSeen`、`jobsSaved`、`duplicatesSkipped`、`stopReason`、`pagesParsed`、`pageLimitSearches`、`blockedRequests`、`failedRequests`、`detailRequests`、`detailPagesParsed`、`detailFailures`,以及各自独立的筛选计数器 `rowsExcludedByCompany`、`rowsExcludedByDate`、`rowsExcludedByJobType`、`rowsExcludedByWorkplace`、`rowsExcludedByExperience` 和 `rowsExcludedByTitle`。使用这些各自独立、确切存储的排除计数器;每一个只描述自己的类别。一次成功的三行对照运行只证明一个已知会返回职位的输入可以工作;它不能证明空的目标查询是什么原因造成的。
如何诊断减少的结果数量
按这些步骤找出职位数量低于预期的原因。
- 在更改任何内容之前,先保存确切的输入设置、运行时间、摘要输出和一小份行样本。确认你预期的数量是否来自完全相同的职位名称、国家、日期范围、排序方式和用户账户。
- 验证你的输入模式。关键词搜索、直接搜索网页链接和特定职位识别编号的工作方式不同。如果你混合这些模式,它们仍然共用一个总行数上限。残留的搜索词可能在你不知情的情况下扩大或改变搜索。
- 检查限制性筛选条件和单位。距离半径需要一个地点。与最近七天的筛选相比,最近一天的筛选可以缩小候选范围,但不保证保存的行更少,尤其是在存在上限时。比较相同的输入与来源范围,并检查实际证据。职位名称和公司排除可以去掉候选。每次只更改一个有依据的输入,并保存旧证据。
- 检查 `jobsSaved`、共享的 `maxItems` 上限、`maxPagesPerSearch` 和 `stopReason`。已保存行数等于当前生效上限,并不能自动证明是行数上限导致了停止,除非实际存储的停止证据这样说明。页数限制可以在所有可见页面被发现之前停止发现。除非实际摘要中的停止原因支持,否则不要断言二者中的任何一个造成了缺口。
- 检查候选数量、跳过的重复项和筛选计数。已找到项目总数的键是 `candidateItemsSeen`。跳过的重复项的键是 `duplicatesSkipped`。你可能看到 20 条候选职位信息,但只保存 5 行唯一记录,因为重复或被筛选掉的信息被忽略。用每个字段的确切定义,确认摘要数字能够加总一致。
- 分别检查来源访问错误和详情页结果。即使全文描述未能加载,搜索仍可能找到职位名称。全文状态的键是 `descriptionStatus`。缺少文本描述并不表示职位信息数量为零。失败的网页请求是错误,不是一次成功但职位数为零的搜索。
- 用同一构建运行一次小型对照,其输入已知会返回职位,以测试基本收集。一次成功的、已知会返回职位的对照只支持该对照本身有效;除非实际范围和来源证据能够确定,否则目标搜索仍然不确定。如果对照也失败,保持来源和运行时暂停,并带着安全的输入和摘要证据联系支持人员。
- 只根据你的发现运行一次有针对性的测试。不要持续提高限制,也不要反复运行已被拦截的抓取器。你的最终结果应当是一张指向一个明确下一步的诊断表。
诊断决策表
用实际存储的停止与页面证据,以及面向读者的说明,来诊断你的运行。
| 已保存数量与上限 | 停止原因证据 | 请求失败 | 筛选活动 | 诊断 |
|---|---|---|---|---|
| `jobsSaved` 与当前生效上限一致 | 已存储的停止原因报告已达到上限 | 0 | 0 | 收集因达到行数限制而停止,并由实际停止证据支持。 |
| `jobsSaved` 低于当前生效上限 | 已存储的停止原因报告已达到页数限制 | 0 | 0 | 收集因达到页面边界而停止,并由实际停止证据支持。 |
| `jobsSaved` 低于当前生效上限 | 已存储的停止原因报告正常耗尽 | 0 | 存在生效的筛选计数器 | 在正常的输入耗尽过程中,筛选规则去掉了匹配的候选行。 |
| 0 | 已存储的停止原因报告请求或拦截问题 | 大于 0 | 0 | 已记录请求失败;原因尚未确定。 |
虚构的演算示例
四次虚构运行,每一次都有自己的输入和摘要:
- A:`maxItems` 为 3,`jobsSaved` 为 3,并有明确报告的上限停止原因。诊断:根据明确的停止证据,已达到共享保存上限;不对市场职位总数作推断。
- B:`maxItems` 为 20,`maxPagesPerSearch` 为 1,`jobsSaved` 为 5,并有明确报告的页面停止原因。诊断:根据明确的停止证据,页面边界解释了该次运行的收集停止;如果来源允许,再试多一页,而不是无限制分页。
- C:`candidateItemsSeen` 为 10,`duplicatesSkipped` 为 3,`rowsExcludedByTitle` 为 2,`jobsSaved` 为 5,面向读者的说明中报告了正常的输入耗尽。在这些虚构且互不重叠的候选含义下,10 减 3 再减 2 等于 5。诊断:唯一性与筛选策略解释了已保存数量。注意,5 个已保存职位中有 3 个具备全文就绪状态,2 个缺失;这一详情状态不改变 5 条职位信息的数量。
- D:`jobsSaved` 为 0,1 次失败请求,1 次被拦截请求。诊断:请求失败已经确立,但原因是网络问题还是访问拦截尚未确定。没有已被证明的市场零结果。
诊断台账
把运行指标记入如下台账,以便比较设置并选择下一次检查。
| 运行 | 当前范围 | 当前上限 | 页面状态 | 候选 / 筛选证据 | 来源状态 | 诊断与下一次检查 |
|---|---|---|---|---|---|---|
| A | Software Engineer, US | 3 | 第 1 页,共 2 页 | 看到 3 / 筛选掉 0 | 正常 | 明确的上限停止。若有依据,提高 `maxItems`。 |
| B | Software Engineer, US | 20 | 第 1 页,共 1 页 | 看到 5 / 筛选掉 0 | 正常 | 明确的页面停止。若允许,把 `maxPagesPerSearch` 增加到 2。 |
| C | Software Engineer, US | 100 | 第 2 页,共 2 页 | 看到 10 / 3 个重复项,2 个职位名称排除 | 正常 | 正常的输入耗尽。复查职位名称排除设置。 |
| D | Software Engineer, US | 100 | 第 0 页,共 2 页 | 看到 0 / 筛选掉 0 | 1 次失败,1 次被拦截 | 除已报告的失败外,来源不确定。暂停运行并报告日志证据。 |
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑