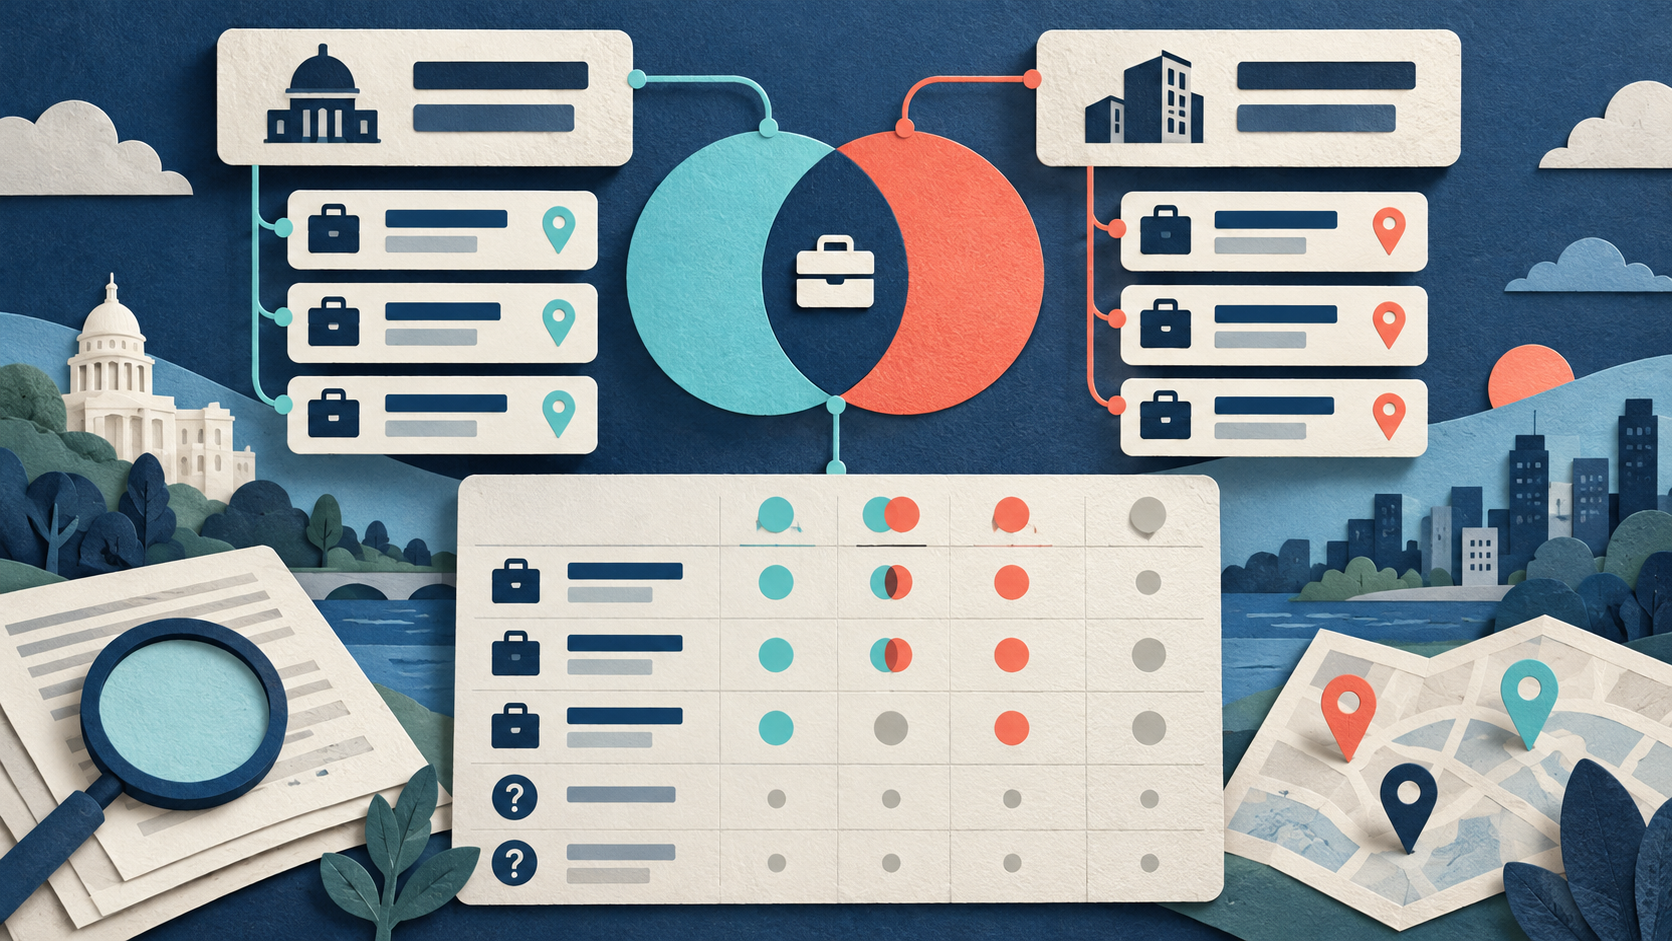
網頁上的自動收集程式稱為 Actor。為 Actor 儲存的一組設定稱為 Task。當職位抓取程式只匯出 5 個職位,但網頁顯示 50 個或更多時,人們常猜測缺少的列是分頁造成的。分頁是網站把長清單拆到多個頁面的方式。猜測並不安全,因為篩選、列數上限或被封鎖的頁面都可以造成完全相同的結果。在更改設定之前,你必須用清楚的證據測試每個原因。
+-----------------------------------------------------------------------+
|                       Check Output Summary                            |
+-----------------------------------------------------------------------+
                                   |
         +-------------------------+-------------------------+
         |                                                   |
         v                                                   v
[stopReason matches reported cap]                   [failedRequests > 0]
         |                                                   |
         v                                                   v
Row cap or page limit hit based                      Request failures recorded;
on actual stored stop evidence. cause remains unresolved.公開的 LinkedIn Jobs Scraper 及其 預設 Task 範例 定義收集規則。目前已儲存的輸入把 `searchTerm` 設為 software engineer,`maxItems` 設為 100,`maxPagesPerSearch` 設為 2,`postedWithin` 設為 7d,`saveOnlyUniqueItems` 設為 true,`fetchJobDetails` 設為 true。你的試驗測試會更換查詢,把 `maxItems` 設為 3,並把 `maxPagesPerSearch` 設為 1。不同的輸入模式共用同一個列數上限。保留這些確切的輸出欄位:`jobId`、`jobUrl`、`title`、`companyName`、`locationRaw`、`descriptionStatus` 和 `scrapedAt`。檢查這些確切可用的輸出摘要鍵:`candidateItemsSeen`、`jobsSaved`、`duplicatesSkipped`、`stopReason`、`pagesParsed`、`pageLimitSearches`、`blockedRequests`、`failedRequests`、`detailRequests`、`detailPagesParsed`、`detailFailures`,以及分開的篩選計數器 `rowsExcludedByCompany`、`rowsExcludedByDate`、`rowsExcludedByJobType`、`rowsExcludedByWorkplace`、`rowsExcludedByExperience` 和 `rowsExcludedByTitle`。使用分開且確切的已儲存排除計數器;每個計數器描述自己的類別。成功的三列對照執行只證明正向輸入可以運作;它不能確立目標搜尋沒有結果的原因。
如何診斷減少的結果數量
按這些步驟找出職位數量為何低於預期。
- 在更改任何設定之前,先儲存確切的輸入設定、執行時間、摘要輸出和一小份列樣本。確認你預期的數量是否來自完全相同的職稱、國家、日期範圍、排序方式和使用者帳戶。
- 驗證你的輸入模式。關鍵字搜尋、直接搜尋網頁連結和特定職位識別號碼的運作方式不同。如果你混合這些模式,它們仍然共用一個總列數上限。殘留的搜尋字可以在你不知情下擴大或改變搜尋。
- 檢查限制性篩選和單位。距離半徑需要一個地點。與最近一週相比,最近一天的篩選可以收窄候選範圍,但不保證已儲存列數較少,尤其在有上限時。比較相同的輸入與來源範圍,並檢查實際證據。職稱和公司排除可以移除候選項目。每次只更改一個有理由的輸入,並保存舊證據。
- 檢查 `jobsSaved`、共用的 `maxItems` 上限、`maxPagesPerSearch` 和 `stopReason`。已儲存列數等於有效上限,並不會自動證明是列數上限造成停止,除非實際儲存的停止證據如此說明。頁數上限可以在仍有可見頁面尚未處理時結束發現。除非實際摘要停止原因支持,否則不要斷言兩者之中任何一個造成了差距。
- 檢查候選數量、略過的重複項目和篩選計數。找到的項目總數鍵是 `candidateItemsSeen`。略過的重複項目鍵是 `duplicatesSkipped`。你可能看到 20 個候選刊登,但只儲存 5 個不重複列,因為重複或被篩選的刊登被忽略。請用每個欄位的確切定義,確認摘要數字可以相加吻合。
- 分開檢查來源存取錯誤和詳情頁結果。即使全文描述載入失敗,搜尋仍可以找到職稱。全文狀態的鍵是 `descriptionStatus`。缺少文字描述並不表示職位刊登數量為零。失敗的網頁要求是錯誤,不是成功但職位為零的搜尋。
- 用相同組建執行一個小型已知正向對照,以測試基本收集。成功的已知正向對照只支持該對照可以運作;除非實際範圍和來源證據能確定,否則目標搜尋仍然不確定。如果對照也失敗,請在來源和執行時檢查完成前暫停收集,並用安全的輸入和摘要證據聯絡支援。
- 只根據你的發現執行一個針對性測試。不要不斷提高上限,或重新執行已被封鎖的抓取程式。你的最終結果應是一份診斷表,指向一個清楚的下一步。
診斷決策表
使用實際儲存的停止與頁面證據,以及讀者說明,來診斷你的執行。
| 已儲存數量與上限 | 停止原因證據 | 要求失敗 | 篩選活動 | 診斷 |
|---|---|---|---|---|
| `jobsSaved` 等於有效上限 | 已儲存的停止原因報告已達到上限 | 0 | 0 | 收集因達到列數上限而停止,並有實際停止證據支持。 |
| `jobsSaved` 低於有效上限 | 已儲存的停止原因報告已達到頁數上限 | 0 | 0 | 收集因達到頁面邊界而停止,並有實際停止證據支持。 |
| `jobsSaved` 低於有效上限 | 已儲存的停止原因報告正常耗盡 | 0 | 存在有效的篩選計數器 | 篩選規則在正常輸入耗盡期間移除了符合的候選列。 |
| 0 | 已儲存的停止原因報告要求或封鎖問題 | 大於 0 | 0 | 已記錄要求失敗;原因尚未解決。 |
虛構的逐步範例
四個虛構執行,每個有自己的輸入和摘要:
- A:`maxItems` 為 3,`jobsSaved` 為 3,並有明確報告的上限停止原因。診斷:根據明確的停止證據,已達到共用儲存上限;不要推論市場職位總數。
- B:`maxItems` 為 20,`maxPagesPerSearch` 為 1,`jobsSaved` 為 5,並有明確報告的頁面停止原因。診斷:根據明確的停止證據,頁面邊界解釋了該次執行的收集停止;如果來源允許,可嘗試多一頁,而不是無限制分頁。
- C:`candidateItemsSeen` 為 10,`duplicatesSkipped` 為 3,`rowsExcludedByTitle` 為 2,`jobsSaved` 為 5,讀者說明報告正常輸入耗盡。在這些虛構且互不重疊的候選含義下,10 減 3 減 2 等於 5。診斷:不重複與篩選政策解釋了已儲存數量。注意 5 個已儲存職位中有 3 個全文就緒,2 個缺少全文;這個詳情狀態不會改變 5 這個刊登數量。
- D:`jobsSaved` 為 0,1 次失敗要求,1 次被封鎖要求。診斷:要求失敗已確立,但原因是網絡問題還是存取封鎖仍未解決。沒有已證明的市場零值。
診斷紀錄
把執行指標記錄在如下的紀錄中,以便比較設定並選擇下一次檢查。
| 執行 | 有效範圍 | 有效上限 | 頁面狀態 | 候選/篩選證據 | 來源狀態 | 診斷與下一次檢查 |
|---|---|---|---|---|---|---|
| A | 軟件工程師,美國 | 3 | 第 1 頁,共 2 頁 | 已見 3/已篩除 0 | 正常 | 明確的上限停止。如有理由,提高 `maxItems`。 |
| B | 軟件工程師,美國 | 20 | 第 1 頁,共 1 頁 | 已見 5/已篩除 0 | 正常 | 明確的頁面停止。如獲允許,把 `maxPagesPerSearch` 增至 2。 |
| C | 軟件工程師,美國 | 100 | 第 2 頁,共 2 頁 | 已見 10/3 個重複,2 個職稱排除 | 正常 | 正常輸入耗盡。檢視職稱排除設定。 |
| D | 軟件工程師,美國 | 100 | 第 0 頁,共 2 頁 | 已見 0/已篩除 0 | 1 次失敗,1 次封鎖 | 除已報告的失敗外,來源仍不確定。暫停執行並報告日誌證據。 |
來源與延伸閱讀
作者 Chronometrica · 更新日期
返回頂端 ↑