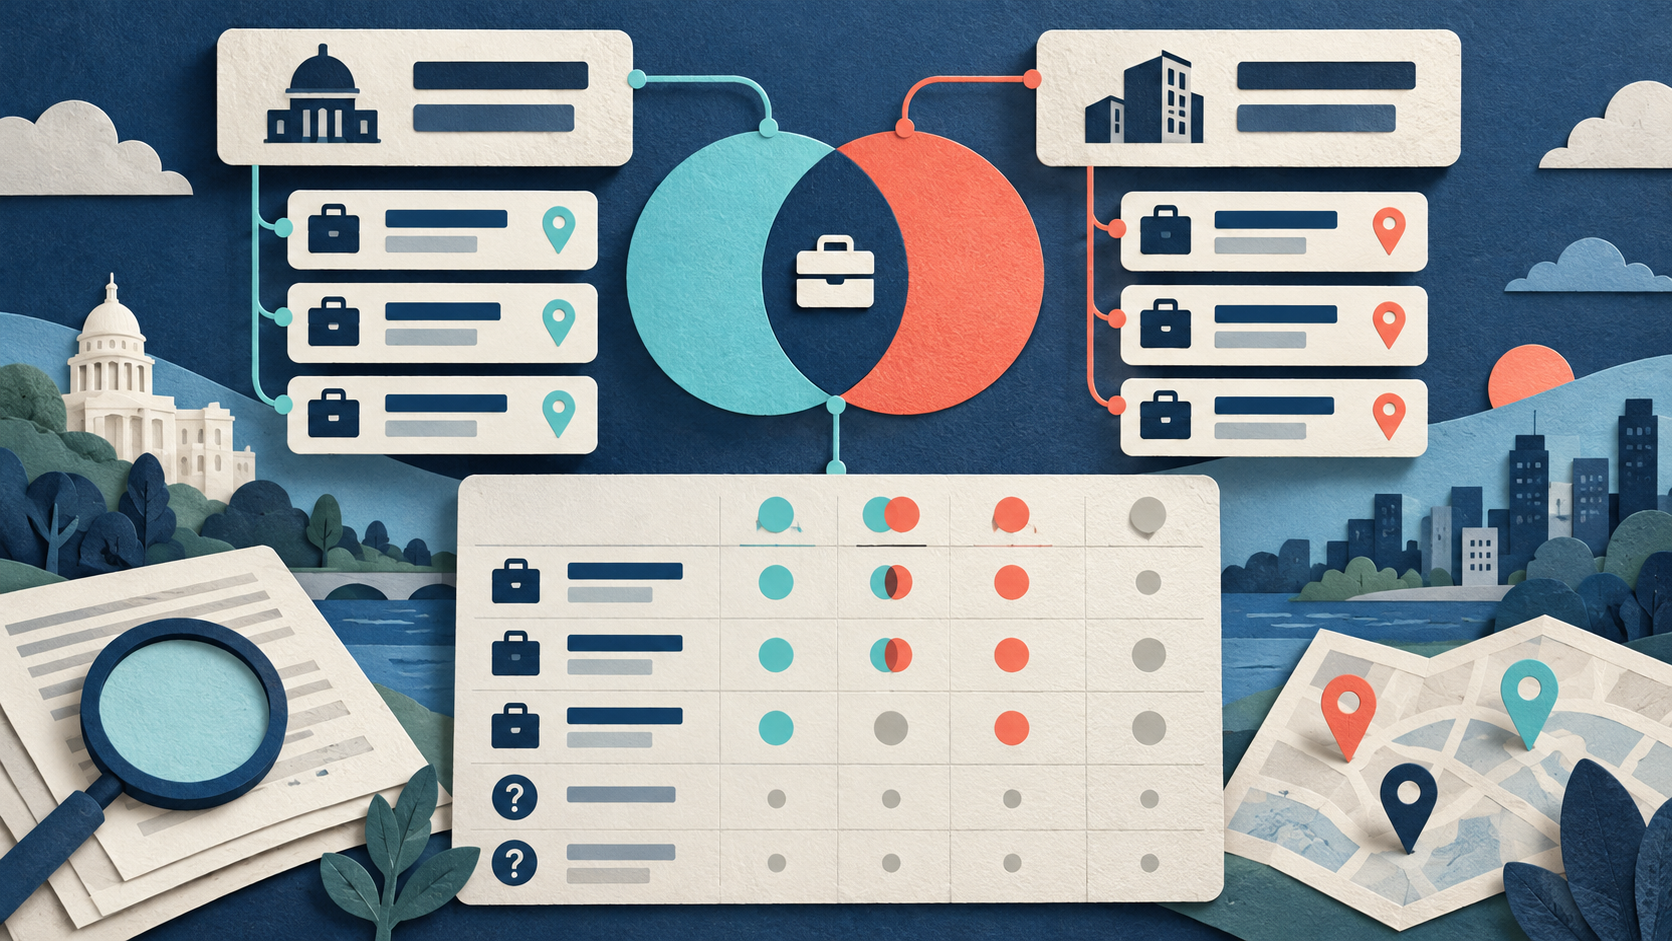
ウェブ上で自動的にデータを収集するプログラムをActorと呼びます。Actorの設定を保存したものをTaskと呼びます。ウェブページには50件以上の求人が表示されているのに、求人スクレイパーが5件しかエクスポートしない場合、ページ分割が原因で一部の行を取得できなかったと推測しがちです。ページ分割とは、ウェブサイトが長い一覧を複数のページに分ける仕組みです。しかし、フィルター、取得件数の制限、ページへのアクセスのブロックでも、まったく同じ結果が生じるため、推測だけで判断するのは危険です。設定を変更する前に、明確な証拠に基づいて各原因を検証する必要があります。
+-----------------------------------------------------------------------+
|                       Check Output Summary                            |
+-----------------------------------------------------------------------+
                                   |
         +-------------------------+-------------------------+
         |                                                   |
         v                                                   v
[stopReason matches reported cap]                   [failedRequests > 0]
         |                                                   |
         v                                                   v
Row cap or page limit hit based                      Request failures recorded;
on actual stored stop evidence. cause remains unresolved.公開されているLinkedIn Jobs Scraperと、その設定済みTaskの例に、収集ルールが定義されています。現在保存されている入力では、`searchTerm`はsoftware engineer、`maxItems`は100、`maxPagesPerSearch`は2、`postedWithin`は7d、`saveOnlyUniqueItems`はtrue、`fetchJobDetails`はtrueに設定されています。試験実行では、検索語を置き換え、`maxItems`を3、`maxPagesPerSearch`を1に設定します。異なる入力モードでも、取得件数上限は1つの共通上限として適用されます。出力では、次のフィールドを名前どおりに保持してください。`jobId`、`jobUrl`、`title`、`companyName`、`locationRaw`、`descriptionStatus`、`scrapedAt`です。利用できる出力サマリーでは、次のキーを名前どおりに確認してください。`candidateItemsSeen`、`jobsSaved`、`duplicatesSkipped`、`stopReason`、`pagesParsed`、`pageLimitSearches`、`blockedRequests`、`failedRequests`、`detailRequests`、`detailPagesParsed`、`detailFailures`に加え、フィルター別のカウンターである`rowsExcludedByCompany`、`rowsExcludedByDate`、`rowsExcludedByJobType`、`rowsExcludedByWorkplace`、`rowsExcludedByExperience`、`rowsExcludedByTitle`です。保存されている個別の除外カウンターを、正確な名前で使用してください。各カウンターは、それぞれ異なる除外区分を表します。対照として行う3行の取得に成功しても、結果が得られるはずの入力で収集できたことしか証明できません。対象の検索で結果が空になった原因は証明できません。
取得件数が少ない原因を診断する方法
次の手順で、求人の取得件数が想定より少ない理由を確認してください。
- 何かを変更する前に、正確な入力設定、実行時刻、サマリー出力、少数の行のサンプルを保存してください。想定件数が、職種名、国、日付範囲、並び順、ユーザーアカウントまで完全に同じ条件に基づくものかを確認してください。
- 入力モードが適切かを確認してください。キーワード検索、検索ページの直接リンク、個別の求人IDでは、動作が異なります。これらのモードを併用しても、全体で1つの取得件数上限を共有します。以前の検索語が残っていると、気づかないうちに検索範囲が広がったり、検索内容が変わったりすることがあります。
- 対象を絞り込むフィルターと単位を確認してください。距離の半径を指定するには、場所の指定が必要です。直近1日のフィルターは、直近1週間のフィルターより候補範囲を狭める可能性があります。ただし、特に取得件数上限がある場合、保存行数が必ず少なくなるとは限りません。入力条件と取得元の対象範囲をそろえて比較し、実際の証拠を確認してください。職種名や企業名による除外設定で、候補が除かれることもあります。根拠のある入力変更を1つずつ行い、変更前の証拠を保存してください。
- `jobsSaved`、共通の取得件数上限である`maxItems`、`maxPagesPerSearch`、`stopReason`を確認してください。保存行数が適用中の上限と一致しても、保存された実際の停止記録にその理由が示されていない限り、件数上限が停止の原因だったとは証明できません。ページ数上限によって、表示されている全ページを調べる前に探索が止まることもあります。実際のサマリーにある停止理由が裏付けていない限り、どちらかが件数差の原因だと断定しないでください。
- 候補数、スキップされた重複件数、フィルターによる除外件数を確認してください。見つかった項目の総数を示すキーは`candidateItemsSeen`です。スキップされた重複件数を示すキーは`duplicatesSkipped`です。候補の求人が20件あっても、重複する求人やフィルターで除外された求人を保存しないため、重複のない5行だけが保存されることがあります。各フィールドの正確な定義に基づき、サマリーの数値の計算が合うかを確認してください。
- 取得元へのアクセスエラーと、詳細ページの取得結果は分けて確認してください。求人説明の全文を読み込めなくても、検索で職種名が見つかることはあります。全文の取得状態を示すキーは`descriptionStatus`です。求人説明が欠損していても、求人件数が0件だったことにはなりません。ウェブリクエストの失敗はエラーであり、検索に成功して求人が0件だった状態とは異なります。
- 基本的な収集機能を検証するため、結果が得られることが分かっている条件を使い、同じビルドで小規模な対照テストを実行してください。その対照テストに成功しても、確認できるのは対照条件で動作したことだけです。実際の対象範囲と取得元の証拠によって判断できるまでは、対象の検索については不確かなままです。対照テストも失敗した場合は、取得元と実行環境の確認待ちとして実行を保留し、安全に共有できる入力情報とサマリーの証拠を添えてサポートに連絡してください。
- 確認結果に基づき、原因を絞ったテストを1つだけ実行してください。上限を繰り返し引き上げたり、ブロックされたスクレイパーを何度も実行したりしないでください。最終的には、次に行うことを1つ明確に示す診断表を作成してください。
診断判断表
実際に保存された停止理由とページに関する証拠を、読者向けの説明と併せて使い、実行結果を診断してください。
| 保存件数と上限の関係 | 停止理由の証拠 | リクエストの失敗 | フィルターの適用状況 | 診断 |
|---|---|---|---|---|
| `jobsSaved`が適用中の上限と一致 | 保存された停止理由に、件数上限への到達が記録されている | 0 | 0 | 取得件数上限に達したため収集が停止した。実際の停止記録がこれを裏付けている。 |
| `jobsSaved`が適用中の上限未満 | 保存された停止理由に、ページ数上限への到達が記録されている | 0 | 0 | ページ数上限に達したため収集が停止した。実際の停止記録がこれを裏付けている。 |
| `jobsSaved`が適用中の上限未満 | 保存された停止理由に、取得対象をすべて処理して正常終了したことが記録されている | 0 | 適用されたフィルターの除外件数が記録されている | 入力に対応する取得対象をすべて正常に処理する過程で、フィルタールールに該当する候補行が除外された。 |
| 0 | 保存された停止理由に、リクエストまたはアクセスのブロックに関する問題が記録されている | 0より大きい | 0 | リクエストの失敗が記録されている。原因は未解明。 |
架空の実行結果を使った診断例
入力とサマリーがそれぞれ異なる、4つの架空の実行例を示します。
- A:`maxItems`は3、`jobsSaved`は3で、件数上限による停止が停止理由として明示されています。診断:明示された停止記録に基づき、共通の保存件数上限に達したと判断できます。求人市場全体の件数については推測できません。
- B:`maxItems`は20、`maxPagesPerSearch`は1、`jobsSaved`は5で、ページ数上限による停止が停止理由として明示されています。診断:明示された停止記録に基づき、この実行の収集が停止した理由はページ数上限だと説明できます。取得元が許可する場合に限り、ページ数を1ページ増やして試してください。無制限にページを取得する設定にはしないでください。
- C:`candidateItemsSeen`は10、`duplicatesSkipped`は3、`rowsExcludedByTitle`は2、`jobsSaved`は5で、読者向けの説明には、入力に対応する取得対象をすべて処理して正常終了したと記載されています。この架空の例では、候補の各区分に重複がないという定義のため、10から3と2を引くと5になります。診断:重複排除とフィルターの方針によって、保存件数を説明できます。なお、保存された求人5件のうち3件は全文を利用できますが、2件は全文が欠損しています。この詳細情報の状態によって、求人件数の5件が変わることはありません。
- D:`jobsSaved`は0、失敗したリクエストが1件、ブロックされたリクエストが1件あります。診断:リクエストの失敗は確認できますが、原因がネットワークの問題なのか、アクセスのブロックなのかは未解明です。求人市場に該当求人が0件であることは証明されていません。
診断記録表
設定を比較し、次に確認する項目を選ぶために、次のような表に実行時の指標を記録してください。
| 実行 | 適用中の対象範囲 | 適用中の件数上限 | ページの処理状況 | 候補数とフィルターの証拠 | 取得元の状態 | 診断と次の確認 |
|---|---|---|---|---|---|---|
| A | Software Engineer, US | 3 | 全2ページ中1ページ目 | 候補3件/フィルターによる除外0件 | 正常 | 件数上限による停止が明示されている。妥当な理由があれば`maxItems`を引き上げる。 |
| B | Software Engineer, US | 20 | 全1ページ中1ページ目 | 候補5件/フィルターによる除外0件 | 正常 | ページ数上限による停止が明示されている。許可される場合は`maxPagesPerSearch`を2に増やす。 |
| C | Software Engineer, US | 100 | 全2ページ中2ページ目 | 候補10件/重複3件、職種名による除外2件 | 正常 | 入力に対応する取得対象をすべて処理して正常終了。職種名による除外設定を確認する。 |
| D | Software Engineer, US | 100 | 全2ページ中0ページ目 | 候補0件/フィルターによる除外0件 | 失敗1件、ブロック1件 | 報告された失敗以外に、取得元の状態は不明。実行を保留し、ログの証拠を報告する。 |
出典と参考資料
著者 Chronometrica · 更新日
ページの先頭へ ↑