どの求人ソースから最も完全なデータを得られるのか、という質問があります。この質問は、ソースを比較する必要性を示しています。どのソースが優れているかを示すものではありません。市場規模を示すものでもありません。この質問はRedditで公開されています。
Actorは、ホスティング環境で動作し、データを収集するプログラムです。Taskは、Actorの入力設定を保存したものです。Actorはソースの行を保存します。比較は自分で行います。Taskが代わりにソースを比較するわけではありません。この方法は、すべての利用者に向けてソースを順位付けするものではありません。給与を評価するものでもありません。費用でツールを順位付けするものでもありません。
実行とは、一つの入力設定で行う一回の収集です。生データ行とは、確認前の保存された求人情報一件です。ソースIDとは、そのソースが求人情報に付けた番号です。有用な求人情報とは、指定した職種、対象地域、掲載時期の範囲に合い、ソースIDが分かっているものです。重複とは、同じ求人情報が複数回保存されたものです。再掲載とは、同じ募集案件が再び掲載されたものです。募集案件とは、重複と再掲載をまとめた後の一件の募集です。フィールド充足率とは、有用な求人情報のうち、必要なフィールドが含まれている割合です。市場の網羅性とは、そのテストでどの募集案件を収集できたかということです。この二つは異なる事実を表します。
8つの手順を実施する
- 決めることと、必要なフィールドを書き出す。
何を選ぶ必要があるのかを書き出します。公開情報を使った求人市場調査では、多くの場合、4つの情報が必要です。ソース名、職種、場所、利用できる求人説明です。職種を明示します。対象地域を明示します。言語を明示します。掲載時期の範囲を明示します。行を収集する日時を明示します。採用基準を明示します。採用基準とは、どの行を目的の職種に該当すると判断するかを定めるルールです。
小規模なテストに使うソースを2つ選びます。同じ募集案件が掲載されているとは考えないでください。1つのパネルは、1つの職種、1つの対象地域、1つの掲載時期の範囲、1つのソースで構成します。両方のソースに同じパネルのルールを適用します。職種や掲載時期の範囲が異なれば、そのファイルが答える問いも異なります。公平な比較はできません。
現在のLinkedIn採用動向Taskは、広範囲のサンプルです。そのままでは比較用のパネルにはなりません。検索語には、software engineer、data analyst、product managerという3つの職種が、それぞれ別の行に設定されています。startUrlsのリストは空です。startUrlsは、開くページを指定する任意のリストです。saveOnlyUniqueItemsはtrueです。この設定では、同じ求人情報が繰り返し現れても、1件だけ保存します。3つの職種を、明示した1つの職種に置き換えます。条件に合う場所を1つ、掲載時期の範囲を1つ追加します。startUrlsは空のままにします。この方法はキーワード検索です。検索語を、既知の求人ページのアドレスに置き換えないでください。
- 比較できる収集上限とフィルターを設定する。
各ソースの検索語、ページ数の上限、行数の上限を書き出します。行数の上限とは、その実行で保存を許可する最大行数です。上限を設けると、確認できる範囲が限られます。これは市場に存在する求人数ではありません。一方のソースが上限に達し、もう一方が上限に達する前に終了した場合、生データの件数は同等の証拠にはなりません。上限に達したソースには、保存した件数よりも多くの条件に合う求人が存在する可能性があります。実際に実行した入力設定を記録します。各実行が停止した理由を記録します。
2026年10月13日に確認した入力項目名を使います。公開ページが更新されると、項目名が変わることがあります。古いリストを使う前に、現在の項目名を確認してください。
LinkedIn Jobs Actorの公開ビルド0.2.19は、searchTerm、location、postedWithin、maxItems、maxPagesPerSearch、saveOnlyUniqueItems、fetchJobDetailsに対応しています。現在の入力項目一覧にある、その他のフィルターにも対応しています。fetchJobDetailsをtrueにすると、求人全文の保存を試みます。LinkedInの小規模な例では、職種をsoftware engineer、対象地域を1つ、postedWithinをany、maxItemsを3、maxPagesPerSearchを1に設定できます。saveOnlyUniqueItemsとfetchJobDetailsもtrueに設定します。anyが適切なのは、明示した掲載時期の範囲が、その設定項目の意味する全範囲と一致する場合だけです。
Indeed Jobs Taskは、Indeed Jobsの公開ビルド1.2.14に対応しています。このビルドは、searchTerm、country、location、maxItems、maxPagesPerSearch、postedWithinDays、saveOnlyUniqueItemsに対応しています。現在利用できる任意のフィルターにも対応しています。条件に合う国、場所、職種をそれぞれ1つ使います。最低給与に0を超える値を設定しないでください。給与フィルターは一部の求人情報を表示対象から除外します。その結果、網羅性を示す件数が変わります。Indeedの小規模な例では、maxItemsを2、maxPagesPerSearchを1、saveOnlyUniqueItemsをtrueに設定できます。
3行の例と2行の例は、収集上限をそろえた組み合わせではありません。ごく小規模な実行でも入力が有効であることを示す例にすぎません。比較では、両方のソースに同じmaxItemsを設定します。maxPagesPerSearchも同じ値に設定します。一方のソースでその数値を指定できない場合は、違いを記録します。
LinkedInはpostedWithinを使います。IndeedはpostedWithinDaysを使います。この二つは同じ入力項目ではありません。明示した掲載時期の範囲に最も近い、各ソースで指定可能な値を選びます。それでも範囲が異なる場合は、不一致を記録します。サンプルが同等だと表現しないでください。
Indeedにはcountryという入力項目があります。確認したLinkedInの入力項目ではlocationを使い、独立した国のフィールドはありません。Indeedのcountryとlocationを、LinkedInのlocationに指定した対象地域と一致するように設定します。それでも場所の指定条件が異なる場合は、その違いを記録します。
このLinkedInのブロックは、小規模な入力設定の例です。対象地域の仮の値を置き換えます。別の職種を明示した場合は、職種も置き換えます。SET_YOUR_MARKETは入力を促す目印であり、実在する場所ではありません。
{
  "searchTerm": "software engineer",
  "location": "SET_YOUR_MARKET",
  "postedWithin": "any",
  "maxItems": 3,
  "maxPagesPerSearch": 1,
  "saveOnlyUniqueItems": true,
  "fetchJobDetails": true,
  "startUrls": []
}このIndeedのブロックは、小規模な入力設定の例です。SET_THE_CLOSEST_ALLOWED_VALUEは入力を促す目印であり、実際のIndeedの設定値ではありません。そこには、指定可能な日数のうち最も近い値を入れます。最低給与は追加しないでください。
{
  "searchTerm": "software engineer",
  "country": "SET_YOUR_COUNTRY",
  "location": "SET_YOUR_MARKET",
  "postedWithinDays": "SET_THE_CLOSEST_ALLOWED_VALUE",
  "maxItems": 2,
  "maxPagesPerSearch": 1,
  "saveOnlyUniqueItems": true
}これらの設定項目を使って確認した実行では、四種類の値が保存されました。空ではないソースの求人ID、ソースのページアドレス、収集時刻、求人説明の全文です。これらの実行では、場所と掲載時期の範囲が異なっていました。どちらも少ない行数の上限に達して停止しました。この確認で分かるのは、その入力設定でActorがこれらのフィールドを保存できることです。条件をそろえたテストではありません。順位付けでもありません。実際に両方のソースに共通する求人の組み合わせは、一組も検証していません。全体の網羅性を示す数値も検証していません。自分で条件をそろえたパネルを作る際は、これと同じ入力仕様を使ってください。
- 各ソースから収集し、行を分類する。
ソースを比較する前に、保存したすべての行をいずれか1つのグループに分類します。次のグループを分けて扱います。
- 有用な行。
- 職種、対象地域、掲載時期の範囲から外れる行。
- 1つの保存ファイル内の重複。
- ソースIDのない行。
- ブロックされたリクエスト、または失敗したリクエスト。
- 上限に達した検索。
実行を予定した各入力設定の結果を漏れなく記録します。実行が拒否された場合、返される行数が0になることがあります。この0は、求人が存在しない証拠ではありません。失敗と、本当に結果が空だった場合を分けて扱います。件数が分からない場合は、不明のままにします。代わりに0を記入しないでください。異なる意味の0を混在させると、ブロックされたソースに求人がないように見えることがあります。
- 両方のサンプルに同じルールを適用する。
すべての行で、職種、場所、掲載時期の範囲を同じ基準で判断します。判断が難しい場合は、求人説明の全文が決め手になることがあります。タイトルだけでは曖昧すぎる場合があります。descriptionStatusがfullであることは、求人説明の全文が保存されたことを意味します。短い文章を示すラベルを独自に作ったという意味ではありません。
日付が欠損していて、ルール上、日付が必要な場合、その行は未確定のままにします。対象地域が欠損していて、ルール上、対象地域が必要な場合も、その行は未確定のままにします。検索時に指定した対象地域は、すべての求人がその場所にあることを証明しません。求人本文に別の場所が記載されていることもあります。
列の対応関係を明確に決めます。各ソースは独自のフィールド名を使っています。生データの保存時には、元の名前を保持します。それらのフィールドから比較用の列に値を入れます。URLは求人情報のページアドレスです。
| 比較用の列 | 保存する内容 |
|---|---|
| ソースと求人ID | ソース名と、そのソース独自の求人ID |
| title | 求人タイトルのテキスト |
| companyName | 雇用主名 |
| locationRaw | 保存されたままの場所のテキスト |
| jobUrl | 求人情報のページアドレス |
| descriptionText | 求人説明の本文 |
| descriptionStatus | 求人説明が全文かどうか |
| scrapedAt | その行を収集した時刻 |
| query | 送信した検索語 |
| searchLocation | 送信した対象地域 |
| 実行の状況 | 実行した入力設定と停止理由 |
各列の横に、対応するソースの元のフィールド名を記入します。生データのフィールド名を変更して、元の名前を失わないでください。LinkedInのpostedAtは、相対的な時間表現から計算される場合があります。相対的な時間表現とは、その求人がどのくらい前に掲載されたかを示す表現です。その値は、正確な掲載時刻の証拠にはなりません。Indeedの時刻の値は、ソースが示す意味のまま扱います。postedWithinDaysも、そのソースでの意味を保持します。任意のフィールドは欠損することがあります。求人IDも欠損することがあります。行数は、すべての募集案件を見つけた証拠にはなりません。求人が実在する証拠にもなりません。
- IDの数字そのものではなく、確認済みの募集案件を比較する。
まず、各ソース内で重複と再掲載をまとめます。次に、2つのソース間で同じ案件の可能性がある組み合わせを確認します。比較には、確認を終えたグループを使います。1つの募集案件を2回保存したものを、2件の募集案件として数えないでください。
ソースIDが一意であるのは、そのソースの名前空間の中だけです。名前空間とは、そのソース独自のIDの集合です。数字が一致するという理由で、LinkedInの求人IDとIndeedの求人IDを結び付けてはいけません。同じ数字が、異なる求人情報に使われることがあります。
各組み合わせについて、両方のソースURLを保持します。ソースURLとは、その求人情報のページアドレスです。LinkedInのURLとIndeedのURLを両方保持します。一方のURLをもう一方で置き換えないでください。
雇用主を比較します。職種を比較します。ここでの職種とは、タイトル欄だけでなく、その求人で求められる仕事内容です。勤務地を比較します。募集番号があれば比較します。募集番号とは、求人情報に記載されている場合の、雇用主が付けた募集案件の番号です。全文の記述を比較します。観測時点の状況を比較します。観測時刻とは、その求人情報を確認した時刻です。状況とは、その時点で求人情報に何が記載されていたかを指します。
これらの事実が一致する場合に限り、同じ募集案件の組み合わせとして確定します。確定した各組み合わせには、両方のURLを保持します。
タイトルだけでは確定できません。IDだけでも確定できません。同じ雇用主でタイトルが似ていても、この確認が必要です。自動的に一致と判断してはいけません。
根拠の弱い組み合わせは、不確かなままにします。矛盾がある組み合わせも、不確かなままにします。根拠の弱い組み合わせでは、情報が欠けていたり、一部の事実しか一致していなかったりします。矛盾がある組み合わせには、一致しない事実があります。募集番号が異なれば一致しません。別の募集案件を説明する記述も一致しません。観測時点の情報から別々の募集案件だと分かる場合も一致しません。不確かな組み合わせは、確定した重複範囲に含めないでください。
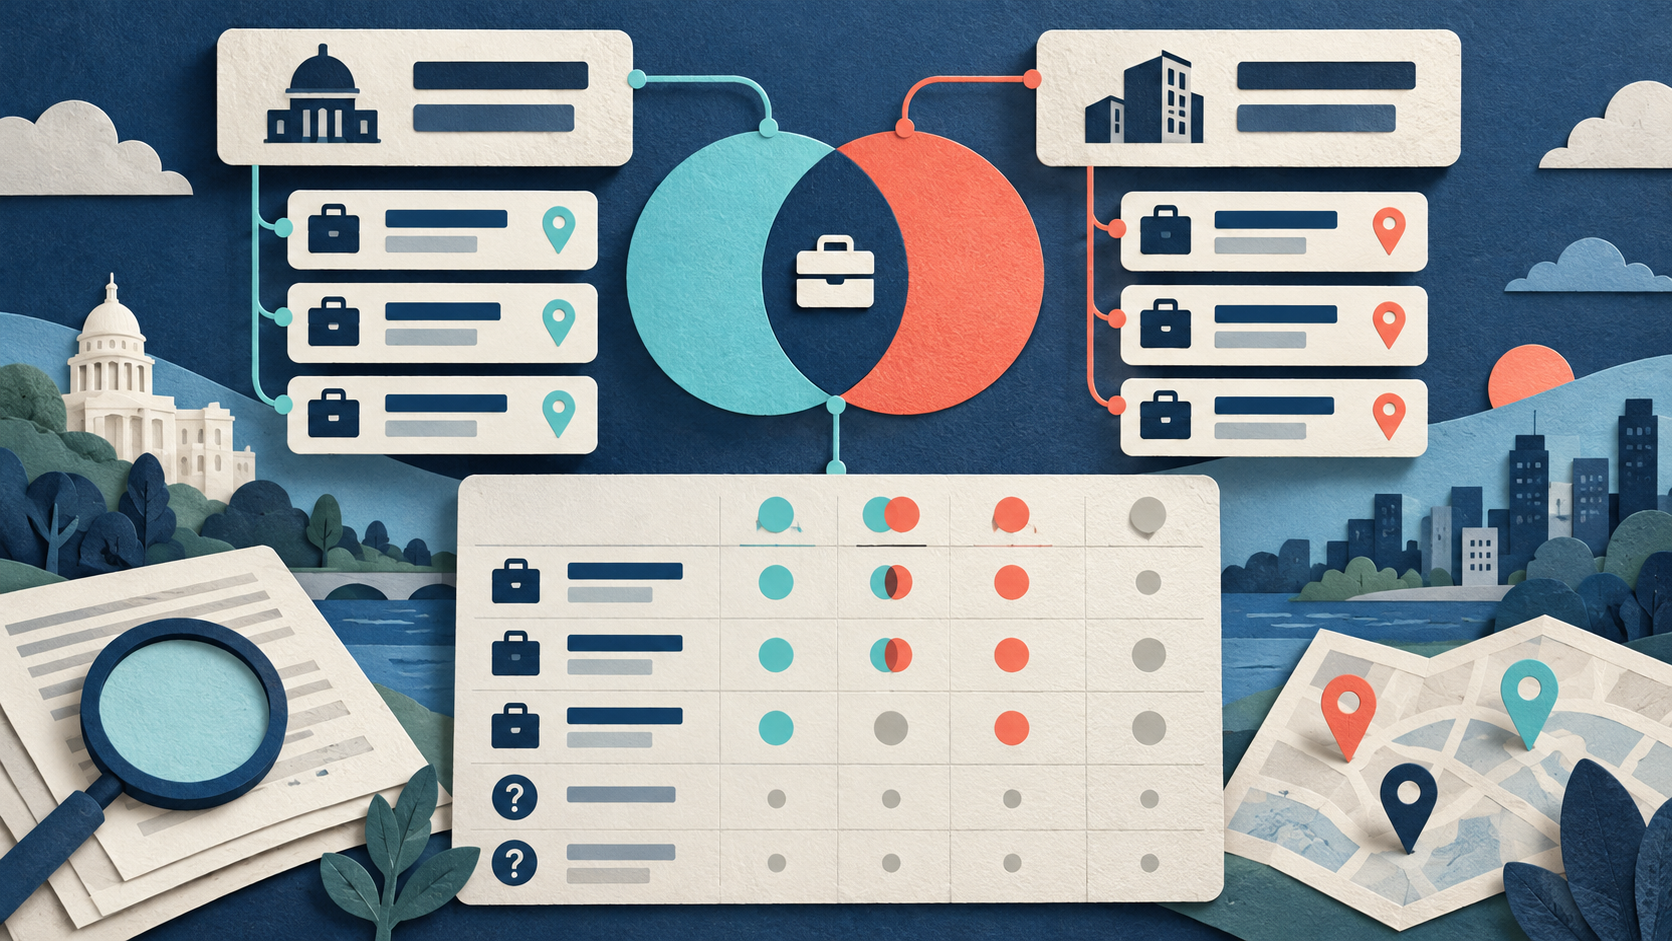
- 確定した集合を作り、4つのグループの件数を数える。
最初のソースで有用と確認した募集案件の集合をAとします。2つ目のソースの集合をBとします。4つのグループの件数を数えます。和集合は、収集したテスト内の、確認済みの募集案件すべてです。共通部分は、同じ募集案件だと確認した重複です。Aのみにある募集案件は、Aに含まれ、Bには含まれません。Bのみにある募集案件は、Bに含まれ、Aには含まれません。一致するかどうか不確かな組み合わせは、別の件数として報告します。無理に共通部分へ含めないでください。
和集合が表すのは、収集したテストの範囲だけです。その地域で募集中のすべての案件を含むわけではありません。これらの件数に捕獲再捕獲法を使わないでください。捕獲再捕獲法は、2つのサンプルの重複から母集団全体を推定する方法です。無作為に抽出したサンプルが必要です。互いに独立したサンプルも必要です。これらのソースは無作為標本ではありません。測定していない理由によって、同じ求人が両方に掲載されている可能性があります。4つの件数を報告してください。それらを市場全体の総数に換算しないでください。
- 各ソースの有用なサンプル内で、必要なフィールドを比較する。
求人説明の全文がある件数を、ソースIDが分かっている有用な求人情報の件数で割ります。その割合が、求人説明のフィールド充足率です。ソースIDが欠損している件数は、独立した件数として報告します。それらを削除したうえで、保存したすべての行が有用だったかのように説明しないでください。IDが欠損していても、実在する求人の行である可能性はあります。ただし、照合に使う根拠としては弱い行です。
フィールド充足率は、市場の網羅性とは異なります。新たに追加できる募集案件が少ないソースでも、重要な場合があります。必要なフィールドを提供する場合です。費用の数値は、測定したものだけを使います。作業量の数値も、測定したものだけを使います。根拠なく最安のソースを決めないでください。根拠なく最良のソースを決めないでください。
- 今回の判断に限って、ソースの組み合わせを選ぶ。
新たに確認できた募集案件と、必要なフィールドを基準に選びます。追加される案件が少ないソースでも、組み合わせに残すことができます。もう一方のソースから得られないフィールドを提供するなら、そのソースを残します。収集に失敗した場合は、明示したものと同じパネルで再実行します。不確かさが大きすぎて判断できない場合も、同じパネルで再実行します。行数を増やすことだけを目的に再実行しないでください。行数を増やしても、ブロックされた実行の問題は解決しません。曖昧な照合の問題も解決しません。1つのソースを、すべての職種と対象地域で最良だと表現しないでください。
条件をそろえた架空のテストで計算する
この節の数値は架空のものです。計算方法を説明するために使います。製品の実績ではありません。上で確認した実行の結果でもありません。ソースAとソースBは、単なるラベルです。この架空の例では、どちらのラベルがLinkedInかは指定していません。どちらがIndeedかも指定していません。J1からJ8は募集案件のラベルです。ソースIDではありません。
この架空の例では、両方のパネルで同じ職種、対象地域、掲載時期の範囲を使います。ソースAは8行の生データを保存します。ソースBは7行の生データを保存します。確認後、AにはソースIDが分かっている有用な求人情報が6件残ります。BにはソースIDが分かっている有用な求人情報が5件残ります。減少分には、対象外の行と重複行の両方が含まれます。この架空の例では、その2つの理由の内訳は示していません。内訳を作り出さないでください。ソースIDが欠損している件数は示していません。不明のままにします。0で埋めないでください。
| 指標 | ソースA | ソースB |
|---|---|---|
| 生データ行数 | 8 | 7 |
| ソースIDが分かっている有用な求人情報 | 6 | 5 |
| 生データ行のうち有用な行の割合 | 6/8 = 75パーセント | 5/7 = 71.4パーセント |
| 有用な求人情報のうち求人説明の全文がある割合 | 6件中5件 = 83.3パーセント | 5件中4件 = 80パーセント |
| 停止理由 | 上限に到達 | 上限に達する前に終了 |
| 一致するか未確定の組み合わせ | この架空の例にはなし | この架空の例にはなし |
| ソースIDの欠損件数 | 記載なし | 記載なし |
| 使用しなかった生データ行の内訳 | 記載なし | 記載なし |
75パーセントと71.4パーセントという割合は、この架空の例のルールに基づくものです。ソースの正確性を評価する点数ではありません。6を8で割ると75パーセントになります。5を7で割ると71.4パーセントになります。
確認後の集合は次のとおりです。
- A = {J1, J2, J3, J4, J5, J6}
- B = {J4, J5, J6, J7, J8}
| 募集案件 | Aに含まれる | Bに含まれる | グループ |
|---|---|---|---|
| J1 | はい | いいえ | Aのみ |
| J2 | はい | いいえ | Aのみ |
| J3 | はい | いいえ | Aのみ |
| J4 | はい | はい | 両方 |
| J5 | はい | はい | 両方 |
| J6 | はい | はい | 両方 |
| J7 | いいえ | はい | Bのみ |
| J8 | いいえ | はい | Bのみ |
共通部分は{J4, J5, J6}です。件数は3です。和集合は{J1, J2, J3, J4, J5, J6, J7, J8}です。件数は8です。Aのみの集合は{J1, J2, J3}です。件数は3です。Bのみの集合は{J7, J8}です。件数は2です。この架空の例に含まれる照合結果は、すべて確定しています。不確かなグループに入る組み合わせはありません。
AにBを加えると、確認済みの募集案件が2件増えます。この追加分は、2つの割合で表せます。それぞれが答える問いは異なります。自分の問いに合う割合を使ってください。
- 新たな募集案件数をAの6件で割る:2/6 = 33.3パーセント。Bを加えることでAがどれだけ増えるかを知りたい場合は、この割合を使います。
- Bのみの募集案件数を和集合の8件で割る:2/8 = 25パーセント。収集した和集合のうち、Bだけから得られた部分がどれだけあるかを知りたい場合は、この割合を使います。
この2つの割合を取り違えないでください。最初の割合は、Aの有用な案件の集合を分母にします。2つ目の割合は、収集した和集合を分母にします。
ソースAでは、有用な求人情報6件のうち5件に求人説明の全文があります。5を6で割ると83.3パーセントになります。ソースBでは、有用な求人情報5件のうち4件に求人説明の全文があります。4を5で割ると80パーセントになります。これらはフィールドの充足率です。市場全体を測るものではありません。
この架空の例では、Aは上限に達しました。Bは上限に達する前に終了しました。どちらの集合も、募集中の求人の全件数を表すものではありません。後の実行で同じルールを使い、上限を引き上げると、Aのみの件数が増える可能性があります。この架空の例では、Aを主なソースとし、追加の2件を得るためにBを併用する選択が考えられます。この選択が適用できるのは、条件を明示したこのテストだけです。普遍的な順位ではありません。フィールド、集合、停止理由、不明な件数を示してください。
この架空の例では、掲載日は示していません。日付が空欄でも、経過日数が0日という意味にはなりません。掲載時期の範囲に関するルールで日付が必要なら、その行は未確定のままです。この架空の例には、そのような未確定の行はありません。実際のデータに不確かな組み合わせがある場合は、選択する前に、その件数を別に数える必要があります。
出典と参考資料
著者 Chronometrica · 更新日
ページの先頭へ ↑