La gente pregunta qué fuente de empleos da los datos más completos. Esa pregunta muestra la necesidad de comparar fuentes. No muestra un ganador. No muestra el tamaño del mercado. La pregunta pública está en Reddit.
Un Actor es un programa alojado que recopila datos. Una Task es un ajuste de entrada guardado para un Actor. El Actor guarda filas de la fuente. Usted hace la comparación. La Task no compara las fuentes por usted. Este método no ordena las fuentes para cada usuario. No puntúa la paga. No ordena las herramientas por costo.
Una ejecución es una recopilación con una entrada. Una fila bruta es un aviso guardado antes de la revisión. Un id de fuente es el número de aviso de esa fuente. Un aviso útil coincide con su puesto, su mercado y su ventana, y tiene un id de fuente conocido. Un duplicado es el mismo aviso guardado más de una vez. Una republicación es la misma vacante publicada de nuevo. Una oportunidad es una vacante después de agrupar duplicados y republicaciones. La cobertura de campos es la frecuencia con la que un campo necesario está presente en los avisos útiles. La cobertura de mercado es qué vacantes recopiló la prueba. Son hechos distintos.
Realice ocho acciones
- Escriba la decisión y los campos que necesita.
Escriba la elección que debe hacer. Para una investigación pública del mercado laboral, a menudo necesita cuatro hechos. Necesita el nombre de la fuente, el puesto, el lugar y una descripción utilizable. Declare el puesto. Declare el mercado. Declare el idioma. Declare la ventana de publicación. Declare la fecha y la hora en que recopila las filas. Declare la regla de inclusión. La regla de inclusión dice qué filas cuentan como el puesto que usted quiere.
Elija dos fuentes para la prueba pequeña. No suponga que listan las mismas vacantes. Un panel es un puesto, un mercado, una ventana y una fuente. Use las mismas reglas de panel en ambas fuentes. Si el puesto o la ventana cambian, los archivos responden preguntas distintas. No puede compararlos de forma justa.
La Task actual de tendencias de contratación de LinkedIn es una muestra amplia. No es su panel de comparación. Sus palabras de búsqueda son tres puestos en líneas separadas: software engineer, data analyst y product manager. Su lista startUrls está vacía. startUrls es una lista opcional de páginas para abrir. saveOnlyUniqueItems es true. Ese ajuste conserva una copia de un aviso repetido en el guardado. Reemplace los tres puestos por un puesto que usted declare. Agregue una ubicación coincidente y una ventana. Deje startUrls vacío. Esta ruta es una búsqueda por palabras clave. No reemplace las palabras de búsqueda por direcciones conocidas de páginas de empleo.
- Defina presupuestos y filtros que pueda comparar.
Escriba las palabras de búsqueda, el límite de páginas y el tope de filas de cada fuente. Un tope es la cantidad máxima de filas que deja guardar a esa ejecución. Un tope limita lo que puede ver. No es la cantidad de empleos del mercado. Si una fuente llega a su tope y la otra se detiene antes, los recuentos brutos no son evidencia equivalente. La fuente con tope puede tener más empleos coincidentes que los que usted guardó. Registre la entrada que realmente se ejecutó. Registre por qué se detuvo cada ejecución.
Use los nombres de entrada comprobados el 13 de octubre de 2026. Una página pública más nueva puede cambiarlos. Lea los nombres actuales antes de confiar en una lista vieja.
La build pública 0.2.19 del Actor de LinkedIn Jobs admite searchTerm, location, postedWithin, maxItems, maxPagesPerSearch, saveOnlyUniqueItems y fetchJobDetails. También admite los otros filtros de su lista de entrada actual. fetchJobDetails true indica a la ejecución que intente guardar el texto completo del empleo. Un ejemplo pequeño de LinkedIn puede usar el puesto software engineer, un mercado, postedWithin any, maxItems 3 y maxPagesPerSearch 1. También defina saveOnlyUniqueItems true y fetchJobDetails true. El valor any solo es correcto cuando su ventana declarada es el rango completo que ese control significa.
La Task de Indeed Jobs coincide con la build pública 1.2.14 de Indeed Jobs. Esa build admite searchTerm, country, location, maxItems, maxPagesPerSearch, postedWithinDays y saveOnlyUniqueItems. También admite sus filtros opcionales actuales. Use un país, una ubicación y un puesto que coincidan. No defina un salario mínimo mayor que cero. Un filtro de paga oculta avisos. Eso cambia el recuento de cobertura. Un ejemplo pequeño de Indeed puede usar maxItems 2, maxPagesPerSearch 1 y saveOnlyUniqueItems true.
El ejemplo de 3 filas y el ejemplo de 2 filas no son un par emparejado de presupuestos. Solo muestran que una ejecución muy pequeña es una entrada válida. Para la comparación, defina el mismo maxItems en ambas fuentes. Defina el mismo maxPagesPerSearch en ambas fuentes. Si una fuente no puede aceptar ese número, escriba la diferencia.
LinkedIn usa postedWithin. Indeed usa postedWithinDays. Estos controles no son la misma entrada. Elija el valor permitido más cercano en cada fuente para su ventana declarada. Si las ventanas siguen siendo distintas, escriba la diferencia. No diga que las muestras son iguales.
Indeed tiene una entrada country. Las entradas de LinkedIn comprobadas usan location, no un campo country separado. Defina country y location de Indeed con el mismo mercado declarado que puso en location de LinkedIn. Si los controles de lugar siguen siendo distintos, escriba la diferencia.
Este bloque de LinkedIn es una forma pequeña de entrada. Reemplace el token de mercado. Reemplace el puesto si declaró un puesto distinto. SET_YOUR_MARKET es un recordatorio, no un lugar real.
{
  "searchTerm": "software engineer",
  "location": "SET_YOUR_MARKET",
  "postedWithin": "any",
  "maxItems": 3,
  "maxPagesPerSearch": 1,
  "saveOnlyUniqueItems": true,
  "fetchJobDetails": true,
  "startUrls": []
}Este bloque de Indeed es una forma pequeña de entrada. SET_THE_CLOSEST_ALLOWED_VALUE es un recordatorio, no un ajuste real de Indeed. Ponga allí el valor de días permitido más cercano. No agregue un salario mínimo.
{
  "searchTerm": "software engineer",
  "country": "SET_YOUR_COUNTRY",
  "location": "SET_YOUR_MARKET",
  "postedWithinDays": "SET_THE_CLOSEST_ALLOWED_VALUE",
  "maxItems": 2,
  "maxPagesPerSearch": 1,
  "saveOnlyUniqueItems": true
}Las ejecuciones comprobadas de estos controles guardaron cuatro clases de valores. Guardaron ids de avisos de la fuente que no estaban vacíos. Guardaron direcciones de páginas de la fuente. Guardaron horas de recopilación. Guardaron descripciones completas. Esas ejecuciones usaron lugares distintos y ventanas distintas. Ambas se detuvieron en topes pequeños de filas. Esa comprobación muestra que los Actors pueden guardar esos campos con esas entradas. No es una prueba emparejada. No es un ranking. No se verificó ningún par real de empleos compartidos. No se verificó ningún número de cobertura completa. Reutilice estos mismos contratos de entrada para su propio panel emparejado.
- Recopile cada fuente y después clasifique las filas.
Clasifique cada fila guardada en un grupo antes de comparar las fuentes. Mantenga estos grupos separados.
- Filas útiles.
- Filas fuera del puesto, del mercado o de la ventana.
- Duplicados dentro de un archivo guardado.
- Filas sin id de fuente.
- Solicitudes bloqueadas o fallidas.
- Búsquedas que llegaron al tope.
Dé cuenta de cada entrada que planeó ejecutar. Una ejecución rechazada puede devolver cero filas. Ese cero no prueba que no existan empleos. Mantenga una falla separada de un resultado verdaderamente vacío. Si no conoce un recuento, déjelo desconocido. No escriba cero en su lugar. Un cero mezclado puede hacer que una fuente bloqueada parezca vacía.
- Use la misma regla en ambas muestras.
Lea el puesto, el lugar y la ventana de la misma manera para cada fila. El texto completo de la descripción puede decidir un caso difícil. Un título solo puede ser demasiado vago. descriptionStatus full significa que se guardó la descripción completa. No significa que usted inventó una etiqueta de texto corto.
Si falta una fecha y su regla necesita una fecha, deje esa fila sin resolver. Si falta el mercado y su regla necesita un mercado, deje esa fila sin resolver. El mercado que usted envió no prueba que cada aviso esté en ese lugar. El texto del aviso puede nombrar otro lugar.
Mapee las columnas a propósito. Cada fuente usa sus propios nombres de campo. Conserve esos nombres originales en el guardado bruto. Complete las columnas de comparación a partir de ellos. Una URL es la dirección de página de un aviso.
| Columna de comparación | Qué guarda |
|---|---|
| fuente e id del empleo | Nombre de la fuente más su propio id de aviso |
| title | Texto del título del empleo |
| companyName | Nombre del empleador |
| locationRaw | Texto del lugar tal como se guardó |
| jobUrl | Dirección de la página del aviso |
| descriptionText | Palabras de la descripción |
| descriptionStatus | Si la descripción está completa |
| scrapedAt | Hora en que recopiló la fila |
| query | Palabras de búsqueda que envió |
| searchLocation | Mercado que envió |
| contexto de la ejecución | Entrada que ejecutó y por qué se detuvo |
Escriba el campo original de la fuente junto a cada columna. Conserve los nombres originales de los campos brutos; no los reemplace con otros nombres. postedAt de LinkedIn puede calcularse a partir de una frase de tiempo relativo. Una frase de tiempo relativo dice hace cuánto apareció la publicación. Ese valor no es una prueba exacta de la hora de publicación. Los valores de tiempo de Indeed conservan el significado que indica esa fuente. postedWithinDays también conserva ese significado de la fuente. Los campos opcionales pueden faltar. Los ids de aviso pueden faltar. Un recuento de filas no prueba que encontró todas las vacantes. Un recuento de filas no prueba que un empleo sea genuino.
- Compare oportunidades revisadas, no los dígitos brutos de los ids.
Agrupe duplicados y republicaciones dentro de cada fuente primero. Después revise posibles coincidencias entre las dos fuentes. Use esos grupos revisados para la comparación. No cuente dos guardados de una vacante como dos vacantes.
Un id de fuente es único solo dentro del espacio de nombres de esa fuente. Un espacio de nombres es el propio conjunto de ids de esa fuente. Nunca una un id de empleo de LinkedIn con un id de empleo de Indeed porque los dígitos coinciden. Los mismos dígitos pueden pertenecer a avisos distintos.
Conserve ambas URL de fuente para cada par. Una URL de fuente es la dirección de página de ese aviso. Conserve la URL de LinkedIn y la URL de Indeed. No reemplace una URL por la otra.
Compare el empleador. Compare el puesto. Un puesto es el trabajo que el aviso pide que haga una persona, no solo la línea del título. Compare la ubicación. Compare la requisición disponible. Una requisición es el número de vacante del empleador cuando el aviso muestra uno. Compare la redacción completa. Compare el contexto del momento de observación. El momento de observación es cuándo vio el aviso. El contexto es lo que ese aviso decía en ese momento.
Confirme un par solo cuando estos hechos coinciden. Conserve ambas URL en cada par confirmado.
Un título solo no es una confirmación. Un id solo no es una confirmación. El mismo empleador y un título similar igual necesitan esta revisión. No son una coincidencia automática.
Un par débil permanece incierto. Un par contradictorio permanece incierto. Un par débil tiene hechos faltantes o solo algunos de los mismos hechos. Un par contradictorio tiene hechos que no coinciden. Requisiciones distintas no coinciden. Una redacción que describe una vacante distinta no coincide. Momentos de observación que muestran dos vacantes distintas no coinciden. Mantenga los pares inciertos fuera de la superposición confirmada.
- Arme conjuntos confirmados y cuente cuatro grupos.
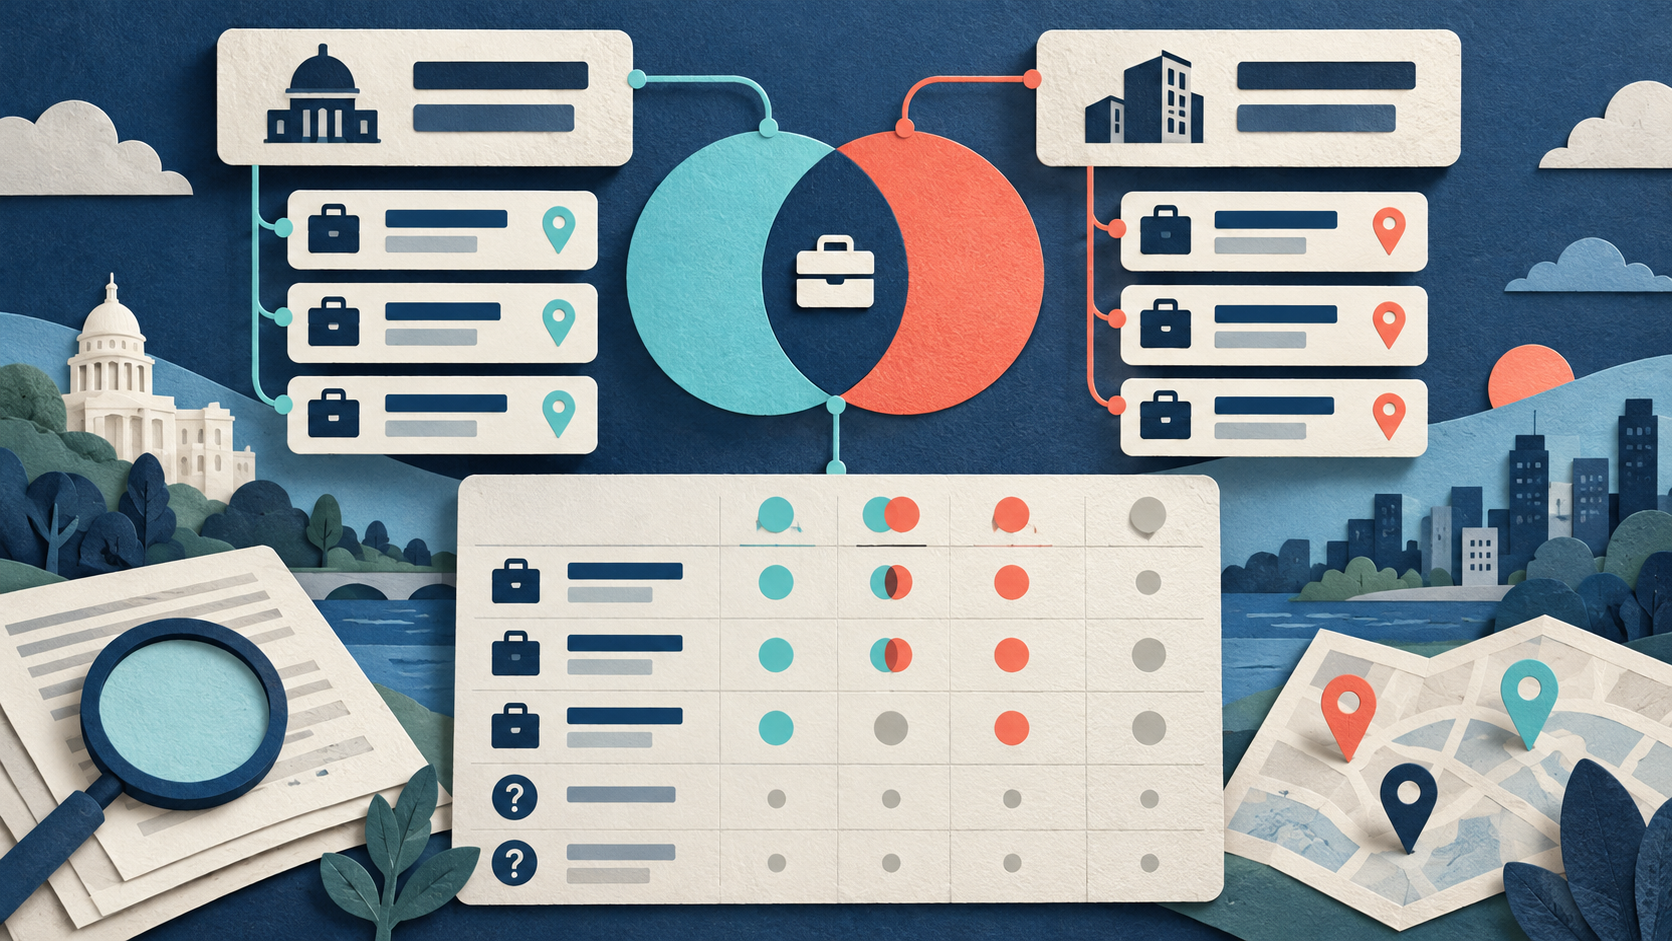
Llame A al conjunto de oportunidades útiles confirmadas de la primera fuente. Llame B al conjunto de la segunda fuente. Cuente cuatro grupos. La unión es cada oportunidad confirmada en la prueba recopilada. La intersección es la superposición que usted confirmó. Las oportunidades solo A aparecen en A y no en B. Las oportunidades solo B aparecen en B y no en A. Informe las coincidencias inciertas como un recuento separado. No las fuerce dentro de la intersección.
La unión cubre solo la prueba recopilada. No es cada puesto abierto en ese mercado. No use captura-recaptura con estos recuentos. La captura-recaptura estima una población completa a partir de la superposición de dos muestras. Necesita muestras aleatorias. Necesita muestras separadas. Estas fuentes no son muestras aleatorias. El mismo empleo puede aparecer en ambas por razones que usted no midió. Informe los cuatro recuentos. No los convierta en un total de todo el mercado.
- Compare los campos necesarios dentro de cada muestra útil.
Divida el recuento de descripciones completas por el recuento de avisos útiles con un id de fuente conocido. Esa proporción es la cobertura de campos para las descripciones. Informe los ids de fuente faltantes como su propio recuento. No los borre y después hable como si cada fila guardada fuera útil. Un id faltante puede seguir siendo una fila real. Es una fila débil para el emparejamiento.
La cobertura de campos no es la cobertura de mercado. Una fuente puede agregar pocas oportunidades nuevas y seguir importando. Importa cuando aporta un campo que usted requiere. Conserve los números de costo solo cuando los midió. Conserve los números de esfuerzo solo cuando los midió. No invente una fuente más barata. No invente una mejor fuente.
- Elija la mezcla solo para esta decisión.
Elija a partir de las oportunidades confirmadas nuevas y de los campos requeridos. Una fuente que agrega poco puede seguir en la mezcla. Consérvela cuando sus filas aportan un campo que no puede obtener de la otra fuente. Si la recopilación falló, repita el mismo panel declarado. Si la incertidumbre es demasiado grande para decidir, repita el mismo panel. No repita solo para aumentar el recuento de filas. Más filas no reparan una ejecución bloqueada. Más filas no reparan una coincidencia imprecisa. No llame a una fuente la mejor para todos los puestos y mercados.
Desarrolle una prueba emparejada ficticia
Los números de esta sección son ficción. Enseñan la aritmética. No son un resultado del producto. No son las ejecuciones comprobadas de arriba. Fuente A y Fuente B son solo etiquetas. Esta ficción no dice qué etiqueta es LinkedIn. Esta ficción no dice qué etiqueta es Indeed. J1 a J8 son etiquetas de oportunidades. No son ids de fuente.
En esta ficción, ambos paneles usan el mismo puesto, el mismo mercado y la misma ventana. La Fuente A guarda 8 filas brutas. La Fuente B guarda 7 filas brutas. La revisión deja 6 avisos útiles con id de fuente conocido en A. La revisión deja 5 avisos útiles con id de fuente conocido en B. La baja da cuenta, juntas, de las filas irrelevantes y de las filas duplicadas. Esta ficción no separa esas dos razones. No invente la separación. Los ids de fuente faltantes no están indicados. Déjelos desconocidos. No los complete con cero.
| Medida | Fuente A | Fuente B |
|---|---|---|
| Filas brutas | 8 | 7 |
| Avisos útiles con un id de fuente conocido | 6 | 5 |
| Proporción de filas brutas que son útiles | 6/8 = 75 por ciento | 5/7 = 71.4 por ciento |
| Descripciones completas en avisos útiles | 5 de 6 = 83.3 por ciento | 4 de 5 = 80 por ciento |
| Detención | Alcanzó su tope | Terminó antes de su tope |
| Coincidencias sin resolver | ninguna en esta ficción | ninguna en esta ficción |
| Ids de fuente faltantes | no indicado | no indicado |
| Separación de las filas brutas no usadas | no indicado | no indicado |
Las proporciones de 75 por ciento y de 71.4 por ciento usan la regla de esta ficción. No son puntajes de exactitud de una fuente. Divida 6 por 8 para obtener 75 por ciento. Divida 5 por 7 para obtener 71.4 por ciento.
Los conjuntos revisados son:
- A = {J1, J2, J3, J4, J5, J6}
- B = {J4, J5, J6, J7, J8}
| Oportunidad | En A | En B | Grupo |
|---|---|---|---|
| J1 | sí | no | solo A |
| J2 | sí | no | solo A |
| J3 | sí | no | solo A |
| J4 | sí | sí | ambas |
| J5 | sí | sí | ambas |
| J6 | sí | sí | ambas |
| J7 | no | sí | solo B |
| J8 | no | sí | solo B |
La intersección es {J4, J5, J6}. El recuento es 3. La unión es {J1, J2, J3, J4, J5, J6, J7, J8}. El recuento es 8. Solo A es {J1, J2, J3}. El recuento es 3. Solo B es {J7, J8}. El recuento es 2. Cada coincidencia incluida en esta ficción está resuelta. Ningún par queda en un grupo incierto.
Agregar B a A agrega 2 oportunidades confirmadas. Dos proporciones describen ese agregado. Responden preguntas distintas. Use la proporción que coincide con su pregunta.
- Oportunidades nuevas divididas por las seis de A: 2/6 = 33.3 por ciento. Use esta proporción cuando pregunte cuánto agrega B a A.
- Oportunidades solo B divididas por la unión de ocho: 2/8 = 25 por ciento. Use esta proporción cuando pregunte qué parte de la unión recopilada proviene solo de B.
No intercambie estas proporciones. La primera proporción usa el conjunto útil de A como base. La segunda proporción usa la unión recopilada como base.
La Fuente A tiene descripciones completas en 5 de 6 avisos útiles. Divida 5 por 6 para obtener 83.3 por ciento. La Fuente B tiene descripciones completas en 4 de 5 avisos útiles. Divida 4 por 5 para obtener 80 por ciento. Estas son proporciones de campos. No miden todo el mercado.
En esta ficción, A alcanzó su tope. B terminó antes de su tope. Ningún conjunto es un recuento completo de empleos abiertos. El recuento solo A puede subir si una ejecución posterior usa un tope más alto y las mismas reglas. La elección ficticia puede ser A como fuente principal, más B por las 2 oportunidades agregadas. Esa elección solo se ajusta a esta prueba declarada. No es un ranking universal. Muestre los campos, los conjuntos, las detenciones y los recuentos desconocidos.
En esta ficción no se dan fechas de publicación. Una fecha en blanco no es el día cero. Si su regla de ventana necesita una fecha, esa fila permanece sin resolver. Esta ficción no tiene esa fila sin resolver. Un par incierto real necesita su propio recuento antes de que usted elija.
Fuentes y lecturas adicionales
Por Chronometrica · Actualizado
Volver arriba ↑