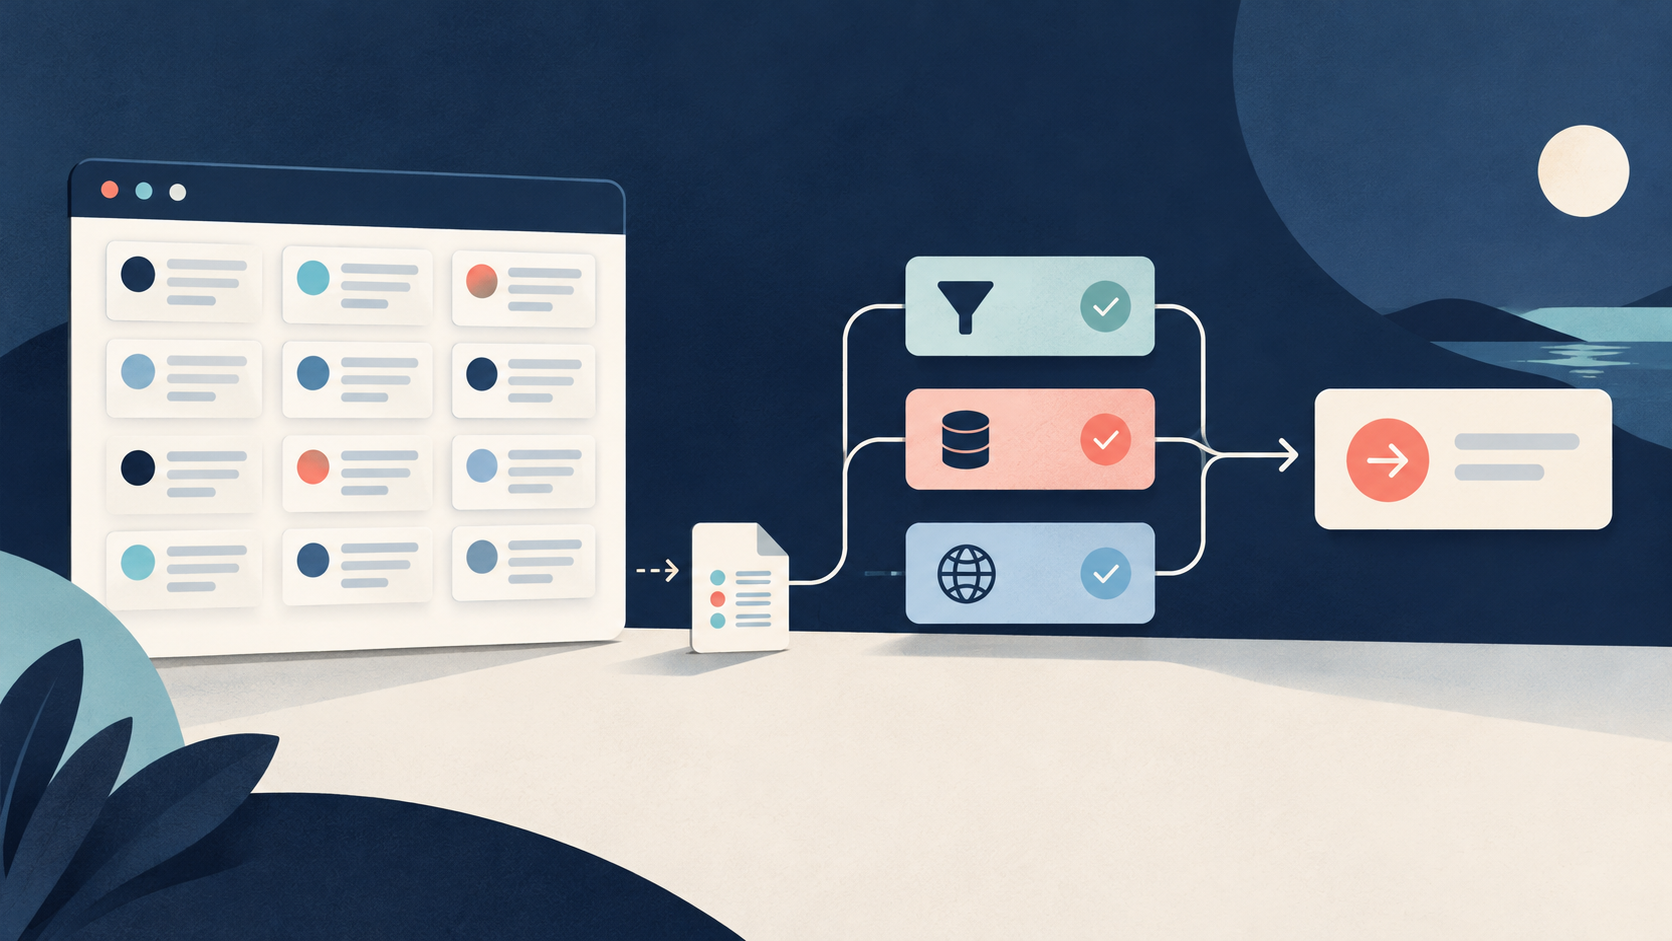
一次采集运行会汇集已采集的公开职位,但日期筛选并不能证明存在在招职位。不同的职位 ID 也可能指向同一个底层空缺。此方法不提供防止重复的能力,也不提供恰好一次保证。投递结果未知时,必须先审阅再重试。
New Collection Batch
   |
   +---> New Nonblank Platform + Job ID? ---> Create Pending Notice Work (Once)
   |
+---> Existing Eligible Pending/Failed ID? ---> Retry Notice Work基本术语
理解这些基本术语,有助于让职位跟踪在数据质量上保持准确:
- 职位:招聘网站上发布的一条公开职位广告,由称为职位 ID 的文本字符串标识。
- Actor:一个托管的采集程序,从公开网页获取职位数据。
- 任务:一组已保存的搜索输入,例如目标关键词和地点,供 Actor 使用。
- 首次见到时间:跟踪系统第一次记录某个具体职位 ID 的精确时间。这与招聘网站上的原始发布时间不同。
- 提醒状态:一条记录,表明某职位的通知是待处理、已成功发送,还是失败。
设置来源采集
在跟踪新发布的职位之前,你需要稳定的每日职位数据流。你可以使用 LinkedIn Jobs Scraper 采集原始职位。
先使用范围较窄的搜索预设,以便轻松测试跟踪账本。默认任务使用多个关键词,但你应先把输入改为只针对一个关键词。
{
  "searchTerm": "software engineer",
  "location": "United States",
  "maxItems": 3,
  "postedWithin": "7d", "distance": 25,
  "sortBy": "date",
  "jobType": "any",
  "workplaceType": "any",
  "experienceLevel": "any",
  "maxPagesPerSearch": 5,
  "saveOnlyUniqueItems": true,
  "balanceKeywordCoverage": true,
  "fetchJobDetails": true,
  "requestDelayMillis": 500
}将 `saveOnlyUniqueItems` 设为 `true` 会去掉单次运行内的重复职位。但它不能阻止不同日期之间的重复。`maxItems` 限制作用于一次运行中的全部搜索词。如果某次运行达到数量上限或遇到来源失败,有些职位可能会被漏掉。把漏采或失败的采集当作未知数据,不要假定新发布的职位为零。
当一次运行成功时,为跟踪流水线提取这些关键字段:
采集器为每条职位输出特定字段。
| 字段名 | 说明 |
|---|---|
| `jobId` | 来源平台职位标识符 |
| `jobUrl` | 来源平台职位链接 |
| `title` | 职位名称 |
| `companyName` | 招聘公司名称 |
| `locationRaw` | 原始地点文本 |
| `postedAt` | 推导或解析得到的发布时间 |
| `postedAtRaw` | 来源上的原始发布标签 |
| `scrapedAt` | 采集时间 |
| `descriptionStatus` | 职位描述获取状态 |
原始标签与已解析或推导的时间一起保留。相对时间长度不是精确的原始发布时间。读取方的首次见到、最后见到和操作字段是分开的。已知的三行当前验收检查只作为来源身份与时间形态,不是已部署的多日提醒证明。
8 步每日跟踪方法
按这八步处理进入的职位并管理提醒,从而不发送重复通知。
- 界定符合条件的提醒:符合条件的提醒是一条已采集的职位 ID,它满足你的基本条件(例如职位名称或地点),并且此前未被处理过。把筛选规则与运行记录放在一起。
- 保留来源行并检查运行输出:保存原始批次输出。在处理各行之前,检查采集错误、条目上限或警告。失败的批次意味着市场状况未知,而不是新职位为零。
- 创建以非空平台和文本形式的 jobId 为键的跟踪表。缺失的 ID 保持为各自独立、尚未解决的观察,绝不合并空白值。保留读取方字段 `first_seen_at`、`last_seen_at`、`jobUrl`、`review_status`、`alert_state`、`alert_attempt_at` 和 `error_note`。来源采集的 `scrapedAt` 与工作流操作时间不同。
- 处理进入的批次 ID:对当前批次中的每个唯一键,检查跟踪表中是否已存在。若已存在,只更新 `last_seen_at`。若不存在,新建一行,将 `review_status` 设为 pending,将 `alert_state` 设为 pending。绝不覆盖 `first_seen_at`。
- 在发送前审阅是否符合条件:核实必要条件,例如地点或远程工作状态。如果某个必要条件无法核实,将 `review_status` 保持为 pending。如果某个职位不符合你的规则,将其标为已排除,并写明原因,以便以后的运行不再审阅它。
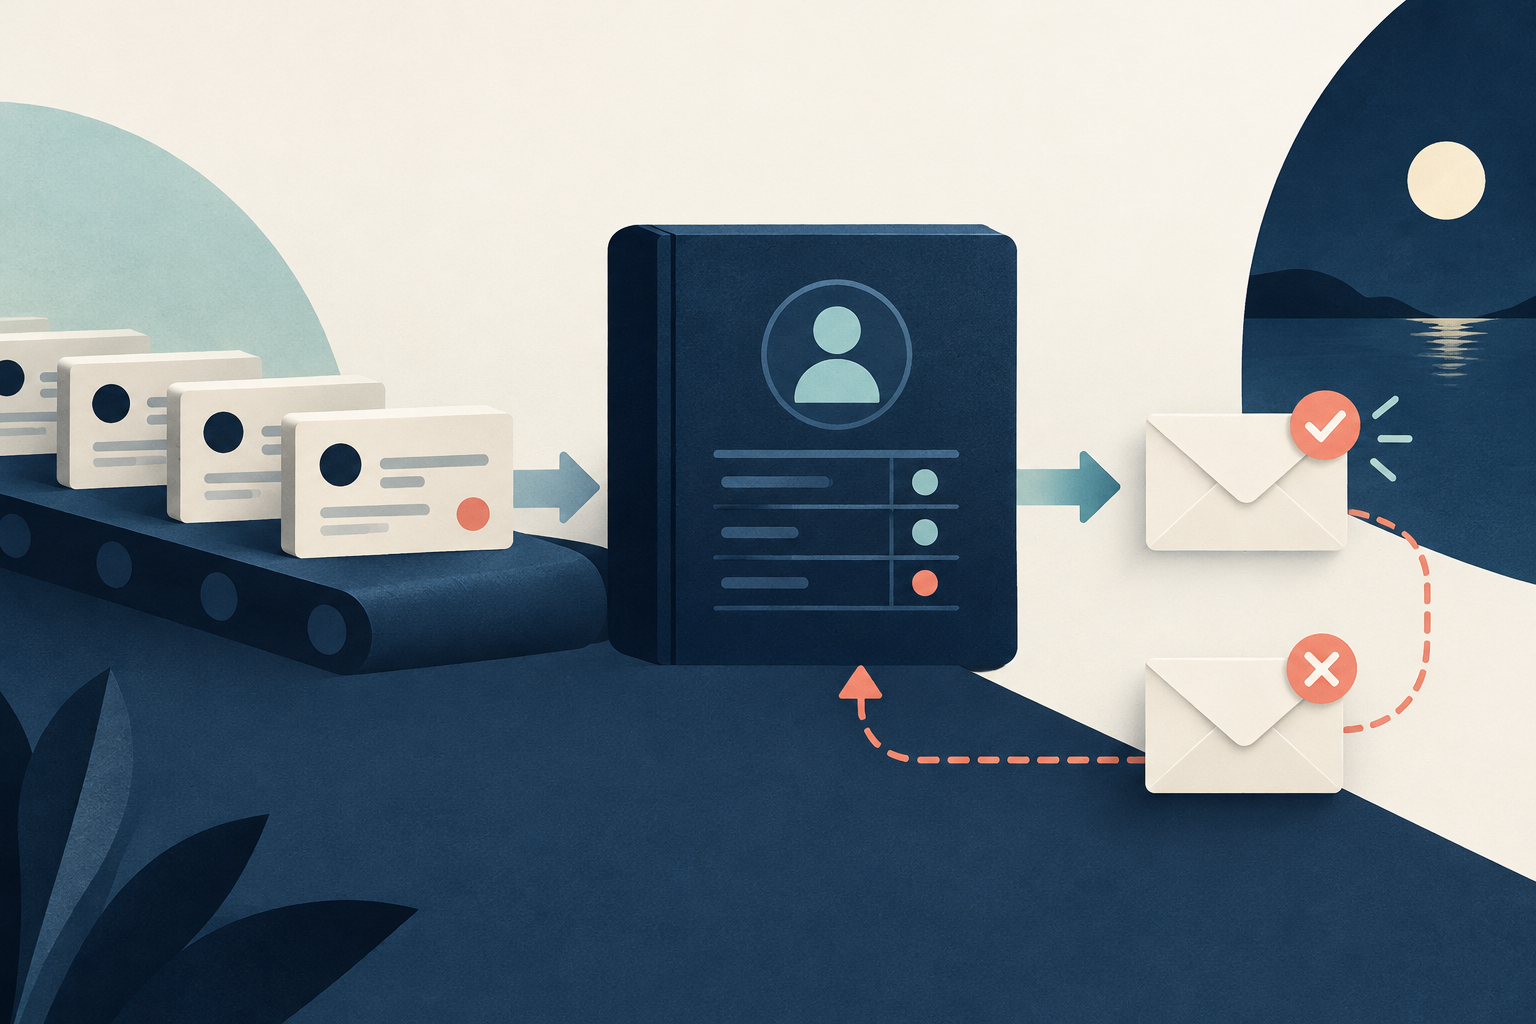
- 给通知一个与平台加职位 ID 绑定的稳定键。只发送符合条件且处于 pending 的通知。仅在提供方服务确认其操作之后,才标为已发送。已发送表示提供方已确认提交,并不证明已到达收件箱。仅有 HTTP 200 接受并不是投递确认。确认结果未知意味着投递未知,必须在重试前检查。不存在恰好一次的投递保证。
- 安全处理投递失败:如果通知发送失败,稍后重试投递,不要清除 `first_seen_at`,也不要从来源重新采集职位。把采集错误与投递错误分开。每一步之后保存状态,以便可以安全地重新开始。
- 清楚地报告指标:把指标分成已采集的不重复职位、新观察到的 ID、符合条件的通知、已确认发送的通知,以及待处理或失败的通知。没有新通知意味着今天没有发现新的已接受匹配,而不是整个就业市场已经停止招聘。
虚构的分步演算示例
所有 ID、日期和事件都是虚构的。10 月 3 日之前的基线只包含两个键:`J1` 于 10 月 1 日首次见到并已发送,`J2` 于 10 月 2 日首次见到并已发送。最终账本包含四个键,而不是该基线。
10 月 3 日,采集返回四条原始/导入行,包含键 `J1`、`J2`、`J3` 和 `J3`。这表示 4 次观察、3 个不同的键、2 个已有键,以及 1 个未见过的键(`J3`)。`J3` 的审阅通过。其第一次通知尝试被确认未接受,因此在这个虚构情形中,稍后重试是安全的。
10 月 4 日,采集返回 3 个键:`J2`、`J3` 和 `J4`。这表示 3 个不同的键、2 个已有键,以及 1 个未见过的键(`J4`)。`J4` 缺少地点,审阅为待处理,且没有通知。10 月 4 日有一次经提供方确认的提交,这并不是收件箱投递。
10 月 5 日,一次失败的采集不改变任何历史,也不构成没有职位的断言。
主跟踪表:
| 键 | 首次见到 | 最后见到 | 审阅状态 | 提醒状态 | 尝试时间 | 错误备注 |
|---|---|---|---|---|---|---|
| linkedin:J1 | 2026-10-01T08:00:00Z | 2026-10-03T08:00:00Z | 已通过 | 已发送 | 2026-10-01T08:05:00Z | 无 |
| linkedin:J2 | 2026-10-02T08:00:00Z | 2026-10-04T08:00:00Z | 已通过 | 已发送 | 2026-10-02T08:05:00Z | 无 |
| linkedin:J3 | 2026-10-03T08:00:00Z | 2026-10-04T08:00:00Z | 已通过 | 已发送 | 2026-10-04T08:05:00Z | 10 月 4 日重试成功 |
| linkedin:J4 | 2026-10-04T08:00:00Z | 2026-10-04T08:00:00Z | 待处理 | 待处理 | 无 | 缺少地点 |
分开的已尝试与已确认通知日志:
| 键 | 尝试时间 | 事件类型 | 服务响应 | 结果状态 |
|---|---|---|---|---|
| linkedin:J3 | 2026-10-03T08:05:00Z | 投递尝试 | 500 Rejected | 失败 |
| linkedin:J3 | 2026-10-04T08:05:00Z | 投递重试 | 200 Accepted | 已发送 |
活动摘要:
- 10 月 3 日未见过的 ID:1(`J3`)
- 10 月 4 日未见过的 ID:1(`J4`)
- 这些日期内经确认的提供方操作:1(`J3` 重试)
- 已跟踪键的总数:4
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑