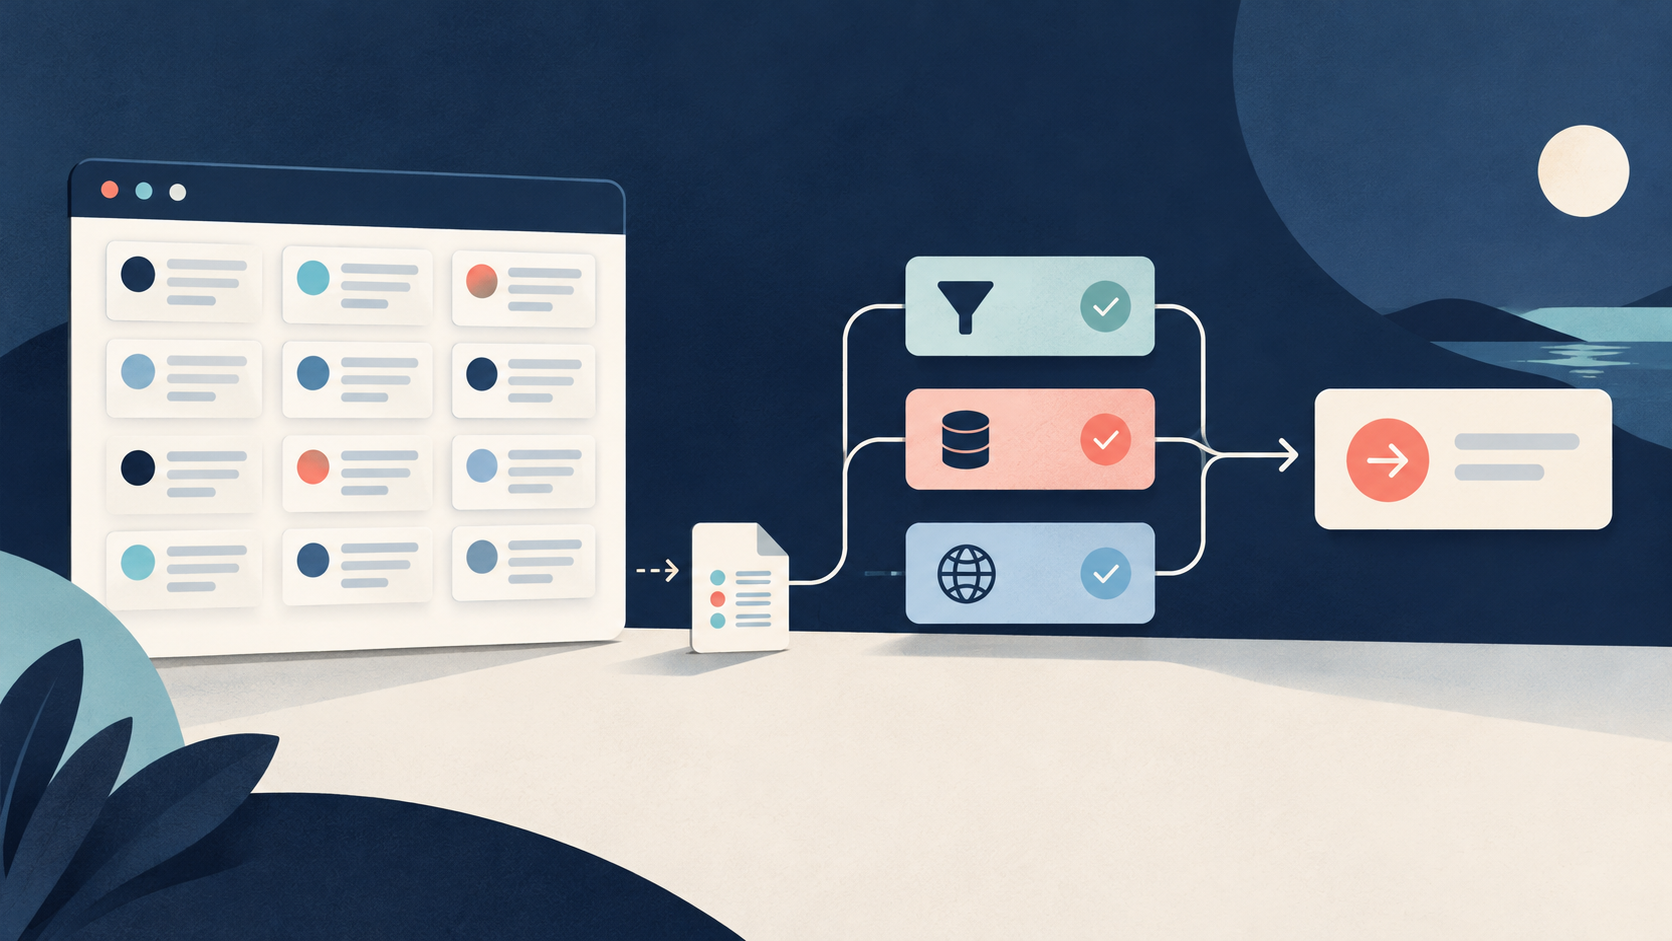
一次收集運行會匯集已收集的公開招聘,但日期篩選並不能證明有在招空缺。不同的招聘編號也可能指向同一個底層空缺。此方法不提供重複預防,也不保證恰好一次。未知的送達須在重試前審視。
New Collection Batch
   |
   +---> New Nonblank Platform + Job ID? ---> Create Pending Notice Work (Once)
   |
+---> Existing Eligible Pending/Failed ID? ---> Retry Notice Work基本用語
明白這些基本用語,有助保持職位追蹤的資料質素與準確:
- 招聘:在網上職位平台刊登的一則公開職位廣告,以稱為職位編號的文字字串識別。
- Actor:一個託管的收集程式,從公開網頁擷取職位資料。
- Task:一組已儲存的搜尋輸入,例如目標關鍵字與地點,供 Actor 使用。
- 首次見到時間:你的追蹤系統第一次記錄某個招聘編號的確實時間。這與網上職位平台上的原始刊登時間不同。
- 通知狀態:一項紀錄,顯示某職位的通知是待處理、已成功送出,還是失敗。
設定來源收集
在追蹤新刊登之前,你需要穩定的每日職位資料流。你可以使用 LinkedIn Jobs Scraper 收集原始職位招聘。
先用範圍較窄的搜尋預設,以便容易測試追蹤帳本。預設 Task 使用多個關鍵字,但你應先把輸入改為只針對一個關鍵字。
{
  "searchTerm": "software engineer",
  "location": "United States",
  "maxItems": 3,
  "postedWithin": "7d", "distance": 25,
  "sortBy": "date",
  "jobType": "any",
  "workplaceType": "any",
  "experienceLevel": "any",
  "maxPagesPerSearch": 5,
  "saveOnlyUniqueItems": true,
  "balanceKeywordCoverage": true,
  "fetchJobDetails": true,
  "requestDelayMillis": 500
}把 `saveOnlyUniqueItems` 設為 `true`,會移除單次運行內的重複招聘。不過,它不會阻止不同日子之間的重複。`maxItems` 上限適用於一次運行中的所有搜尋詞。如果一次運行達到數值上限,或遇到來源失敗,部分職位可能會遺漏。請把遺漏或失敗的收集視為未知資料,不要假設新刊登的職位為零。
當一次運行成功時,為追蹤管道擷取這些關鍵欄位:
收集器為每則招聘輸出指定欄位。
| 欄位名稱 | 說明 |
|---|---|
| `jobId` | 來源平台的職位識別碼 |
| `jobUrl` | 來源平台的職位連結 |
| `title` | 職位名稱 |
| `companyName` | 招聘公司名稱 |
| `locationRaw` | 原始地點文字 |
| `postedAt` | 推導或解析得出的刊登時間 |
| `postedAtRaw` | 來源的原始刊登標籤 |
| `scrapedAt` | 收集時間 |
| `descriptionStatus` | 職位描述擷取狀態 |
原始標籤與已解析或推導的時間一併保留。相對的距今時間並非確實的原始刊登時間。讀者追蹤工作流程所維護的首次見到、最後見到及動作欄位是分開的。已知的三列現行驗收檢查只作為來源身份與時間形態,並非已部署、跨多日的通知證明。
8 步每日追蹤方法
依照以下八步處理傳入的招聘,並管理通知,以免重複送出通知。
- 界定符合條件的通知:符合條件的通知,是一則已收集的招聘編號,符合你的基本條件(例如職位名稱或地點),而且此前未曾處理。把篩選規則放在運行紀錄旁邊。
- 保留來源列並檢查運行輸出:儲存原始批次輸出。在處理各列之前,先檢查收集錯誤、項目上限或警告。失敗的批次表示市況未知,而不是新招聘為零。
- 建立追蹤表,以非空白的平台,以及作為文字的 jobId 作為鍵。缺少的編號保持為分開、尚未解決的觀察,永不合併空白。保留讀者追蹤工作流程的欄位 `first_seen_at`、`last_seen_at`、`jobUrl`、`review_status`、`alert_state`、`alert_attempt_at` 及 `error_note`。來源收集的 `scrapedAt` 與工作流程的動作時間不同。
- 處理傳入批次的編號:對目前批次中每個唯一鍵,檢查它是否已在追蹤表中。如果已存在,只更新 `last_seen_at`。如果缺少,建立新列,把 `review_status` 設為待處理,並把 `alert_state` 設為待處理。永不覆寫 `first_seen_at`。
- 送出前先審視是否符合條件:核對必要條件,例如地點或遙距工作狀態。如果某項必要條件無法核對,保持 `review_status` 為待處理。如果職位不符合你的規則,把它標為已排除,並寫明原因,以免日後的運行再次審視。
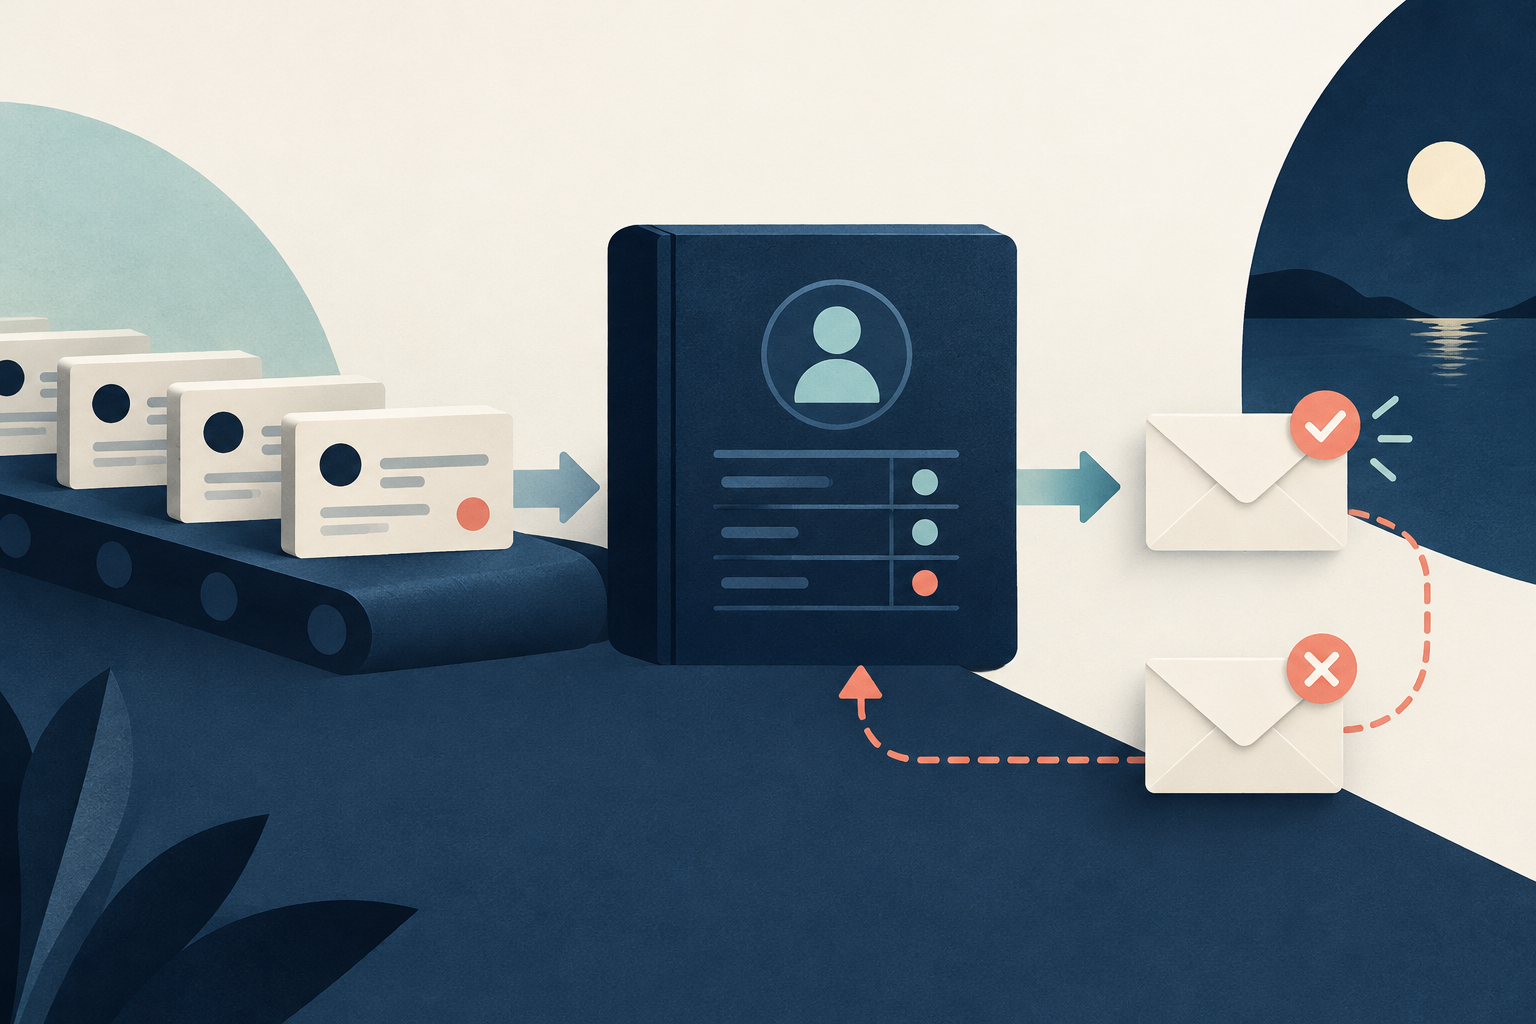
- 為通知設定一個穩定鍵,綁定平台加職位編號。只送出符合條件且待處理的通知。只有在提供者服務確認其動作之後,才標為已送出。已送出是指提供者的提交已獲確認,並非證明已到達收件匣。單憑 HTTP 200 的接受並非送達確認。確認結果未知,即表示送達情況未知,必須在重試前先檢查。沒有恰好一次的送達保證。
- 安全處理送達失敗:如果通知送出失敗,稍後重試送達,不要清除 `first_seen_at`,也不要從來源重新收集職位。把收集錯誤與送達錯誤分開。每一步之後儲存狀態,以便可以安全地重新開始。
- 清楚報告指標:把指標分開為已收集、每則只計一次的不同招聘、新觀察到的編號、符合條件的通知、已確認送出的通知,以及待處理或失敗的通知。沒有新通知,表示今日沒有找到新的、已通過檢查的相符項目,並不是整體職位市場已停止招聘。
虛構的逐步演算示例
所有編號、日期及事件都是虛構的。10 月 3 日之前的基線只包含兩個鍵:`J1` 於 10 月 1 日首次見到並已送出,以及 `J2` 於 10 月 2 日首次見到並已送出。最終帳本包含四個鍵,而不是該基線。
10 月 3 日,收集返回四列原始/匯入資料,包含鍵 `J1`、`J2`、`J3` 及 `J3`。這代表 4 次觀察、3 個不同的鍵、2 個已有的鍵,以及 1 個未見過的鍵(`J3`)。`J3` 的審視通過。其首次通知嘗試已確認為未獲接受,因此在這個虛構例子中,稍後重試是安全的。
10 月 4 日,收集返回 3 個鍵:`J2`、`J3` 及 `J4`。這代表 3 個不同的鍵、2 個已有的鍵,以及 1 個未見過的鍵(`J4`)。`J4` 缺少地點,審視為待處理,並且沒有通知。10 月 4 日有一次已獲提供者確認的提交,但這並非收件匣送達。
10 月 5 日,一次失敗的收集不會更改任何過往紀錄,也不構成任何關於空缺不存在的說法。
主追蹤表:
| 鍵 | 首次見到 | 最後見到 | 審視狀態 | 通知狀態 | 嘗試時間 | 錯誤備註 |
|---|---|---|---|---|---|---|
| linkedin:J1 | 2026-10-01T08:00:00Z | 2026-10-03T08:00:00Z | 已通過 | 已送出 | 2026-10-01T08:05:00Z | 無 |
| linkedin:J2 | 2026-10-02T08:00:00Z | 2026-10-04T08:00:00Z | 已通過 | 已送出 | 2026-10-02T08:05:00Z | 無 |
| linkedin:J3 | 2026-10-03T08:00:00Z | 2026-10-04T08:00:00Z | 已通過 | 已送出 | 2026-10-04T08:05:00Z | 10 月 4 日重試成功 |
| linkedin:J4 | 2026-10-04T08:00:00Z | 2026-10-04T08:00:00Z | 待處理 | 待處理 | 無 | 缺少地點 |
分開的已嘗試與已確認通知紀錄:
| 鍵 | 嘗試時間 | 事件類型 | 服務回應 | 結果狀態 |
|---|---|---|---|---|
| linkedin:J3 | 2026-10-03T08:05:00Z | 送達嘗試 | 500 Rejected | 失敗 |
| linkedin:J3 | 2026-10-04T08:05:00Z | 送達重試 | 200 Accepted | 已送出 |
活動摘要:
- 10 月 3 日未見過的編號:1(`J3`)
- 10 月 4 日未見過的編號:1(`J4`)
- 該數日內已確認的提供者動作:1(`J3` 重試)
- 已追蹤的鍵總數:4
來源與延伸閱讀
作者 Chronometrica · 更新日期
返回頂端 ↑