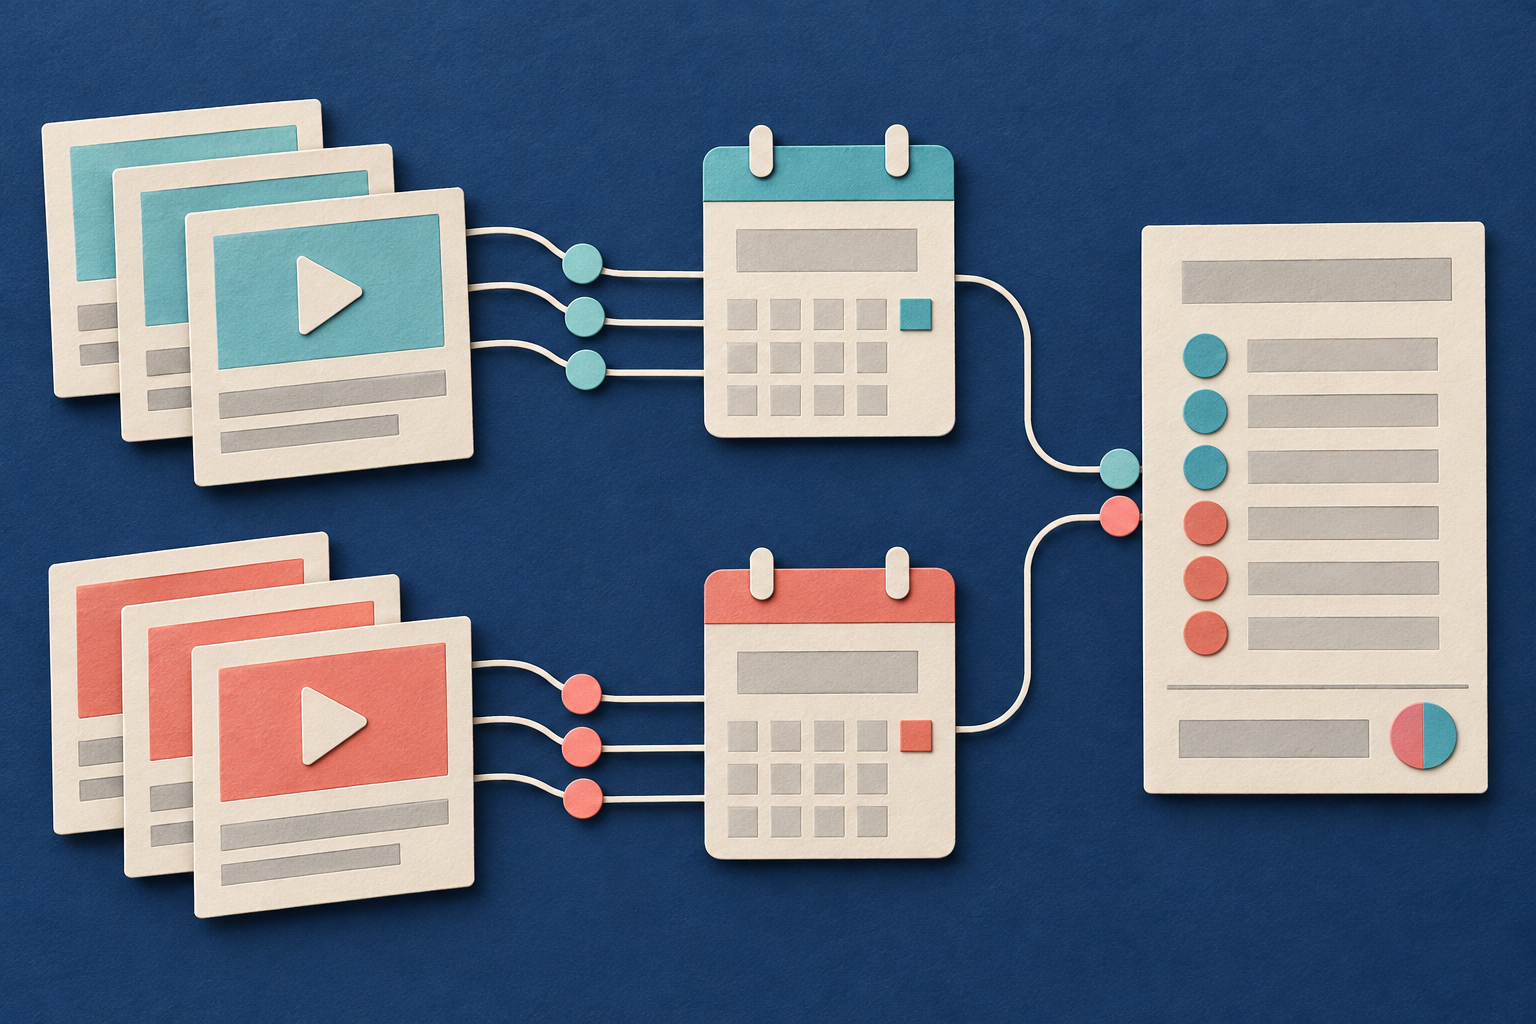
登錄表是一份儲存的清單,每個已知留言 ID 各有一筆資料。匯出檔是存有收集紀錄的檔案。本指南說明如何為已知的公開 Instagram 貼文與 Reels 建立登錄表。Reel 是 Instagram 的一種影片格式。收集範圍是頂層留言,也就是直接留在貼文下的留言,不包含其他留言下的回覆。
一位讀者曾公開提問,是否能只收集最新的留言,例如過去一小時內的留言。這個問題包含兩種不同需求:找出最近發布的留言,以及找出現有登錄表尚未收錄的紀錄。下列方法處理第二種需求。單一公開提問不能證明有多少人有這項需求。讀者提問,發布於 2021 年 6 月 22 日;於 2026 年 8 月 11 日擷取;僅一則提問,未證實曾使用產品。
1. 定義貼文範圍與收集限制
先列出已知公開貼文的 URL。URL 就是網址。比對不同次執行的結果時,請使用同一份清單,或記錄清單的每次變更。一次執行,是指收集程式使用一組輸入資料執行一次。
收集前,先寫下以下設定:
- 列出要檢查的公開貼文。
- 選定檢查間隔。
- 說明你的用途可接受多少延遲或遺漏。
- 設定每則貼文最多儲存幾則留言。
- 選擇留言排序方式。
- 記錄所有發布日期篩選條件。
- 為每次收集指定參照代號,並與匯出檔一同保留。
上限是你要求儲存的最大紀錄數,並非保證會取得的結果數。收集間隔說明你計畫何時再次檢查,但不能證明兩次檢查之間的每則留言都會出現在結果中。
如果你的用途需要證明每則新留言都已收集到,這個方法無法提供該證明。它只能提供已觀察到的留言紀錄,以及可確認的收集限制。
Chronometrica 的 Instagram Comments Scraper 是一個 Actor,也就是託管的收集程式。經查核的公開規格說明了已知公開貼文的輸入方式、頂層留言紀錄、日期篩選條件,以及每則貼文的收集上限。文件未記載「自上次執行以來」或「僅限新留言」的輸入設定。你必須自行透過比對程序找出尚未見過的 ID。Instagram Comments Scraper,於 2026 年 10 月 25 日查核;文件顯示符合公開資料收集用途,本指南未進行實際執行測試。
本指南使用公開紀錄,不會取得私人帳號紀錄,或僅限帳號擁有者查看的報表。請勿將登錄表描述為完整的帳號通知紀錄,或使用者的完整 Instagram 留言紀錄。
2. 分開保留登錄表與觀察紀錄
使用兩份儲存的資料表。資料表以列儲存紀錄,並以具名的欄位儲存各項數值。鍵值是用來識別單筆紀錄的一個值或一組值。
留言登錄表使用 `commentId` 作為鍵值。文件規格將此欄位定義為頂層留言的穩定 Instagram ID。請將 ID 儲存為文字,以保留完全相同的字元。
觀察紀錄會記下每次出現該 ID 的收集。請以 `commentId` 與收集參照代號的組合作為鍵值。這樣,同一則留言可以出現在多次收集中,卻不會被當成多則不同留言。
下表建議了你可以儲存的欄位。`first_seen_at` 與 `collection_ref` 等欄位屬於你自己的處理程序,並非 Actor 額外提供的輸出欄位。
| 登錄表欄位 | 儲存內容 | 規則 |
|---|---|---|
| `commentId` | 來源提供的穩定留言 ID | 每個已知 ID 各有一筆登錄資料 |
| `postUrl` | 公開貼文的標準網址 | 保留來源值 |
| `postId` | 來源貼文 ID,如有提供 | 缺失值保持缺失 |
| `postShortCode` | 貼文網址中的短碼 | 用於確認是否為目標貼文 |
| `createdAt` | 來源記載的留言發布時間 | 與觀察時間分開保留 |
| `first_seen_at` | 你的程序首次接納該 ID 的時間 | 只設定一次,重新處理時保持不變 |
| `first_seen_collection_ref` | 首次接納該 ID 時所屬收集的參照代號 | 保留與來源證據的連結 |
| `original_text` | 首次接納紀錄中的文字 | 不得在未註明的情況下替換 |
| 觀察紀錄欄位 | 儲存內容 | 規則 |
|---|---|---|
| `commentId` | 與登錄表比對的留言 ID | 不得依文字內容配對 |
| `collection_ref` | 本次收集的參照代號 | 匯入同一份匯出檔時,使用相同代號 |
| `collectedAt` | 該列記載的 Actor 收集時間 | 不得以匯入時間替換 |
| `text` | 本次收集傳回的文字 | 保留附有日期的版本 |
| `raw_export_ref` | 指向未經變更匯出檔的參照資訊 | 確保能追溯到來源資料列 |
| `text_change` | 你的比對結果 | 標記與先前儲存文字的差異 |
也請保留完整的原始匯出檔。JSON 是一種用來儲存結構化紀錄的文字格式。保留原始 JSON,有助於在建立資料表後核對各項值。
區分三種時間
`createdAt` 記錄來源所述的留言發布時間。此值可以是 null,表示無法取得。
`collectedAt` 記錄 Actor 收集留言的時間,以 UTC 表示。UTC 是通用的時間標準。請保留來源資料列中的這個時間。
`first_seen_at` 記錄登錄表首次接納留言 ID 的時間。請在方法說明中寫明此規則。如果你今天匯入較早的匯出檔,其收集時間仍是較早的時間,而登錄表首次接納它的時間則是今天。除非依你明定的規則,兩個時間確實相同,否則請勿將它們記為相同時間。
經查核的輸出規格也記載了作者資訊、按讚數與回覆數。回覆數不是回覆文字。請區分數量為零與數量無法取得的情況。請區分 `ownerVerified` 為 false 與 null 的情況。缺少作者 ID 不代表作者 ID 為零,也不會使有效的留言 ID 失效。公開版本 0.1.21,於 2026 年 10 月 25 日查核;文件記載欄位與 null 規則,並非目前實際執行的結果。
此登錄表計算的是以 ID 區分的留言數量,不是不同帳號或人數。如果你也需要一份經檢查的工作檔案,公開留言樣本指南 說明了另一套匯出與匯入流程。請將該流程與判斷 ID 是否首次被觀察到的工作分開處理。
3. 使用小規模輸入檢查一則貼文
先從一則已知的公開貼文開始,將上限設為 10。使用提供的輸入資料:
{"collectAllAvailable":false,"commentSortMode":"default","maxCommentsPerPost":10,"postUrls":["https://www.instagram.com/reel/DZu6dkVyImf/"]}將範例 Reel 網址替換為你要收集的公開貼文或 Reel 網址。請替換範例網址,不要將你的網址加在它旁邊。
`postUrls` 包含目標網址。`maxCommentsPerPost` 限制每則貼文可儲存的不重複頂層留言數量。`commentSortMode` 用於選擇排序方式。`default` 值會保留 Instagram 的預設排序。`collectAllAvailable` 為 false 時,數量上限仍會生效。
提供的輸入資料已通過靜態結構規格檢查。結構規格定義可接受的輸入欄位與值的類型。此檢查只確認輸入格式。本指南未實際執行收集,此檢查也不能確認目前是否能取得資料。公開輸入規格,於 2026 年 10 月 25 日查核;僅進行靜態驗證,未付費執行。
自行執行收集後,請依序完成以下步驟:
- 儲存實際使用的完整輸入資料與收集參照代號。
- 保留未經變更的匯出檔。
- 將每個傳回的貼文網址與短碼,和要求收集的貼文比對。
- 對照原始紀錄,核對留言 ID、文字與時間。
- 將無法確認留言身分或無法確認是否屬於目標貼文的紀錄分開保留。
- 將已接納的 ID 加入初始登錄表。
文件所述的輸出允許 `postId` 為 null。請核對可取得的貼文網址與短碼,不要自行編造貼文 ID。缺少 `commentId` 時,無法可靠地與登錄表配對。請將該列保留為待確認,表示接納前仍需審查。即使文字相同,也不能補足缺失的 ID。
以第一次收集的結果建立初始登錄表。這些 ID 對登錄表而言都是新收錄的 ID,但它們出現在結果中,並不能證明留言是最近發布的。
4. 依 ID 比對下一份匯出檔
後續每次收集時,請將已接納的留言 ID,與本次更新前的登錄表比對。
- 如果登錄表中沒有某個 ID,新增一筆留言資料。
- 依你明定的首次接納規則,設定其 `first_seen_at`。
- 保留來源的 `createdAt`;無法取得時,保留 null。
- 新增觀察紀錄,並附上收集參照代號與 `collectedAt`。
- 如果 ID 已存在,保留登錄表中的資料,並新增本次觀察紀錄。
- 將其文字與先前儲存的文字比對。
- 將變更後的文字另存為附有日期的版本,並標記差異。
「首次觀察到」表示登錄表先前不知道這個 ID。「重複出現」表示在本次收集的更新之前,登錄表已知道這個 ID。這兩種標記都不取決於留言的發布日期。
兩則留言可能文字相同,ID 卻不同。請保留兩者。同一個 ID 也可能出現在多次收集中。請保留一筆登錄資料,以及多筆觀察參照資訊。
如果已知 ID 的文字不同,請保留先前報告使用過的舊文字。比對只能確認儲存紀錄之間有差異,不能單憑差異判定是誰修改文字,或為何修改。
請維持更新結果與收集參照代號的關聯。重新處理時,請沿用該結果,不要將原先的新 ID 再次呈現為新發現。重新處理是指再次處理同一份已儲存的匯出檔。
指標歷史紀錄的計量單位不同:它記錄的是一次儲存的數量讀值。Instagram 快照指南 處理的是這個不同的問題。在本指南中,後續再次觀察到同一則留言,只是增加該則留言的證據,不會增加另一則不同的留言。
5. 演練較晚才發現留言的情況
以下操作範例為原創虛構情境,不是 Actor 輸出、客戶成果或測試結果。所有時間均指同一個虛構日期,並使用 UTC。假設登錄表在所述檢查時間接納每份匯出檔。
10:00 時,第一份設有上限的匯出檔包含 C1 與 C2。兩個 ID 都加入原本空白的登錄表。
11:00 時,第二份匯出檔包含 C2 與 C3。來源記載 C3 的發布時間為 09:30。它在第一次檢查前就已發布,但第一份匯出檔未包含它。
| 收集 | 匯出的 ID | 首次觀察到的 ID | 重複出現的 ID |
|---|---|---|---|
| 第一次,10:00 | C1, C2 | C1, C2 | 無 |
| 第二次,11:00 | C2, C3 | C3 | C2 |
登錄表的計算如下:
- 第一次更新後:0 則已知留言 + 2 則新收錄留言 = 2 則已知留言,均以 ID 區分。
- 第二次更新:2 則已知留言 + 1 則新收錄留言 = 3 則已知留言,均以 ID 區分。
- 第二份匯出檔:1 個重複出現的 ID + 1 個首次觀察到的 ID = 2 個不同的匯出 ID。
登錄表現在包含 C1、C2 與 C3。這是 3 則以 ID 區分的已知留言,不代表 3 個人。
| 留言 ID | 首次觀察時間 | 本範例使用的發布時間 | 第二次收集結果 |
|---|---|---|---|
| C1 | 10:00 | 未指定 | 未觀察到 |
| C2 | 10:00 | 未指定 | 重複出現的 ID |
| C3 | 11:00 | 09:30 | 首次觀察到的 ID |
C3 的 `createdAt` 保持為 09:30,`first_seen_at` 保持為 11:00。請勿將它描述為在 10:00 之後發布。C1 與 C2 的「未指定」表示此虛構範例沒有提供發布時間,不代表午夜或零。
C1 仍保留在登錄表中。它未出現在第二份匯出檔,並不能證明它已遭刪除或受到內容管理處置。此範例未說明它缺席的原因。
兩次收集共有 4 筆觀察紀錄:2 筆觀察紀錄 + 2 筆觀察紀錄 = 4 筆觀察紀錄。登錄表則有 3 則以 ID 區分的留言。這兩個總數計算的是不同項目。
現在使用相同的收集參照代號,重新處理第二份匯出檔。登錄表的預期結果如下:
- 3 則現有留言 + 0 則新收錄留言 = 3 則已知留言,均以 ID 區分。
- 新增的首次觀察資料為 0 筆。
- 相同留言與收集組合鍵值新增的觀察紀錄為 0 筆。
C3 的首次觀察時間仍為 11:00。重新處理檔案不會產生另一次新發現。
6. 使用日期篩選,並明定重疊範圍
Actor 文件將 `commentsFrom` 與 `commentsUntil` 定義為留言日期的篩選條件。它們不會依登錄表的首次觀察時間篩選。公開輸入規格,於 2026 年 10 月 25 日查核;文件記載日期輸入,未記載「自上次執行以來」的開關,亦未進行實際執行測試。
如果使用日期篩選,請明定相鄰收集時段的重疊範圍。重疊是指下一個日期範圍包含前一個範圍的一部分。請透過比對 ID,避免將這些重複紀錄新增為登錄資料。
請依你的用途選定並記錄重疊範圍。這份已凍結的來源證據無法確立適用於所有情況的安全重疊長度。
虛構的 C3 顯示了仍然存在的風險。如果後續請求排除 10:00 之前的發布時間,也會排除發布於 09:30 的 C3。即使登錄表從未見過這則留言,它仍會無法被發現。
重疊範圍可以涵蓋較早的發布日期,但不能證明已找到所有留言。所選範圍以外的留言仍可能不出現在結果中。
排序設定也有限制。`newest` 與 `oldest` 會依日期排序已收集的頂層留言樣本,但不能證明所有符合條件的留言都已納入樣本。預設排序也不代表收集是按時間順序進行。
將 `collectAllAvailable` 設為 true,會取消數量上限。但依文件所述,執行仍可能因公開資料串流結束、時間用盡或來源發生錯誤而停止。因此,取消上限不能證明已完整涵蓋來源,且費用可能高出許多。檢查登錄表方法時,請維持設有上限的設定。
7. 記錄每則要求收集貼文的缺口
為每次收集一併保留涵蓋範圍註記。涵蓋範圍是指儲存結果能支持確認的來源部分。請將要求收集的貼文清單與每份匯出檔比對,也要納入未產生任何已接納資料列的請求。
| 涵蓋範圍項目 | 記錄內容 |
|---|---|
| 收集參照代號 | 使用的執行紀錄與未經變更的匯出檔 |
| 要求收集的貼文 | 完整且確切的目標貼文清單 |
| 輸入限制 | 上限、排序、日期篩選條件與結果上限設定 |
| 傳回的紀錄 | 原始資料列與已接納的不重複留言 ID |
| 待確認紀錄 | 缺少留言識別資訊,或尚未確認是否屬於目標貼文 |
| 失敗情況 | 已記錄的收集失敗情況與受影響貼文 |
| 涵蓋範圍限制 | 已知的上限影響,以及其他缺失的相關資訊 |
請勿將未知狀態記為成功結果。如果無法確認收集停止的原因,請記錄為原因不明。
請分別記錄以下失敗狀態:
- 未傳回資料列:本次結果中未觀察到留言。這不能證明貼文的留言數為零。
- 缺少留言識別資訊:保留原始資料列供審查。請勿依文字或作者名稱配對。
- 尚未確認是否屬於目標貼文:在確認目標之前,將該列保留為待確認。
- 已確認達到上限:將上限列為涵蓋範圍限制。請勿將其視為貼文的留言總數。
- 已知 ID 後來未出現:保留登錄資料。請勿斷言留言已遭刪除或受到內容管理處置。
- 無法取得時間:維持缺失狀態。請勿以發布時間或首次觀察時間代替。
- 輸入變更:記錄變更內容。上限、排序或日期範圍不同,都會改變比對範圍。
輸出文件記載了公開的按讚數與回覆數。零表示已知數量為零。Null 表示無法取得。無論回覆數缺失或不為零,都不會因此提供回覆文字。保留原始紀錄時,請維持這些含義。
8. 使用更新結果前先檢查
每次收集請分別提供四項結果:首次觀察到的 ID、重複出現的 ID、文字變更案例,以及尚未釐清的涵蓋範圍。文字變更案例也可能屬於重複出現的 ID。請勿將重疊群組相加,當作互不重複的留言總數。
完成以下檢查後,才接納更新:
- 確認每個已接納 ID 都能追溯到來源貼文與原始匯出檔。
- 確認新 ID 在更新前不在登錄表中。
- 確認較早的發布時間保持不變。
- 確認已知 ID 保留原本的首次觀察時間。
- 確認變更的文字保留了附有日期的各個版本。
- 使用相同的收集參照代號,重新處理同一份匯出檔。
- 確認重新處理時,新增的留言 ID 與首次觀察資料均為零。
- 檢查每則要求收集的貼文是否都有結果,或有明確記錄的缺口。
這些是供你的程序採用的建議檢查項目,不是為本文實際執行收集所得的結果。
來源與延伸閱讀
- Instagram Comments Scraper 公開頁面,於 2026 年 10 月 25 日查核規格;僅依文件確認用途適合,未付費執行,也未測量可靠性
- 公開預設版本 0.1.21,於 2026 年 10 月 25 日查核;靜態輸入與輸出規格及 README,無實際執行結果
- Export Instagram Comments to CSV Task,於 2026 年 10 月 25 日查核;僅確認公開頁面存在,未透過已登入帳號查核儲存的輸入設定,也未執行此 Task
- 關於收集最新留言的提問,發布於 2021 年 6 月 22 日;於 2026 年 8 月 11 日擷取;僅一則公開提問,無需求量估計,也未證實曾使用產品
作者 Chronometrica · 更新日期
返回頂端 ↑