快照是在某個收集時間儲存的讀值。觀測紀錄則是該讀值儲存後的紀錄。本指南為已在收集 Instagram 公開指標的開發者提出一套匯入方法。這個方法能保留歷史資料,避免將重複匯入誤當成額外的一次檢查。
收集程式提供來源資料列。你的匯入流程必須具備下文所述的穩定識別鍵、儲存規則與重新啟動檢查。本文未執行任何收集作業或匯入測試。
定義每筆儲存資料列的意義
一位讀者曾公開詢問如何「每 24 小時分析貼文成效,繪製類似 Instagram 新版關鍵績效指標的曲線」。這段提問顯示需要重複量測,但沒有說明重試設計。本文提出的安全匯入方法,是在此需求上延伸的設計建議。讀者提問,於 2026 年 8 月 12 日觀察到;發布日期不詳,且未證實曾使用產品。
單靠每日排程,無法建立可靠的歷史資料。你還需要區分以下兩種事件:
- 新的收集:程式再次檢查貼文。儲存一筆新的觀測紀錄。
- 重複匯入:應用程式讀取已儲存過的資料列。保留現有的觀測紀錄。
這兩種事件可能包含相同的計數值。兩次檢查即使都回報 100 次觀看,仍是兩筆觀測紀錄。同一筆已收集的資料列讀取兩次,仍只是一筆觀測紀錄。
請區分次數與人數。公開觀看次數不等於不重複觀看人數。將 `views`、`plays` 與 `playsInstagram` 保留為不同欄位。在未定義報表規則前,不要將它們相加,也不要用其中一個取代另一個。
此方法處理的是公開計數值。它不會取得私人帳號的 Insights 洞察報告,也無法還原你未儲存的過往計數值。只有擁有者能存取的紀錄,必須透過另一個已獲授權的來源取得。已核對的公開規格支援收集目前的公開指標,不支援還原歷史計數值。Instagram Metrics Scraper 規格,已於 2026 年 10 月 25 日核對;僅檢查公開建置版本,未付費執行。
如果你還需要在尋找近期貼文與檢查已儲存的網址之間做選擇,請參閱 Instagram 定期收集指南。先做出選擇,再設計匯入流程。
保留觀測紀錄表與匯入回執
使用兩種用途不同的紀錄。觀測紀錄表保存收集到的讀值。匯入回執則記錄應用程式如何處理某次來源執行作業。
執行作業是指收集程式的一次執行。資料集則是該程式傳回並儲存的資料列清單。保留兩者的識別碼,才能追溯已儲存觀測紀錄的來源。
以下是建議的儲存欄位名稱。`run_id` 與 `item_position` 等欄位屬於工作流程的中繼資料,也就是收集與匯入過程的相關資訊。它們不是新增的 Actor 輸出欄位。Actor 是託管在平台上的收集程式。
| 儲存欄位 | 保留內容 | 用途 |
|---|---|---|
| `observation_key` | 來源資料列的唯一識別鍵 | 防止重複插入 |
| `run_id` | 以文字儲存的已完成來源執行作業識別碼 | 識別收集作業 |
| `dataset_id` | 以文字儲存的來源資料集識別碼 | 識別來源清單 |
| `item_position` | 原始資料列的絕對位置 | 識別變更前的資料列 |
| `postId` | 以文字儲存的原始貼文識別碼 | 比對不同執行作業中的同一內容 |
| `postUrl` | 原始內容網址 | 保留內容的參照資訊 |
| `scrapedAt` | 原始收集時間 | 將讀值放在歷史資料的正確時間位置 |
| 計數欄位 | 分別保留各個傳回的計數欄位 | 保留指標的意義 |
| 狀態欄位 | 原始指標狀態與資料列狀態 | 說明數值缺漏或無法使用的原因 |
| `original_json` | 完整的原始資料列 | 保留來源證據 |
| `imported_at` | 應用程式儲存資料列的時間 | 分開追蹤匯入作業 |
JSON 是一種用於結構化資料的文字格式。在重新命名欄位、移除欄位,或將一筆來源資料列展開為多筆紀錄之前,先儲存原始 JSON。
來源若提供 `postMetricStatus`、`status` 與 `statusReason`,請保留這些欄位。其他傳回的狀態欄位也應保留在原始 JSON 中。不要自行編造狀態值,也不要假設文件未說明的狀態結構。已核對的輸出規格包含內容識別資訊、計數值、收集時間與狀態欄位。公開預設建置版本,已於 2026 年 10 月 25 日核對;僅確認文件記載的欄位,未進行實際執行測試。
每次嘗試匯入時,都儲存一份包含以下資訊的回執:
- 執行作業識別碼、資料集識別碼,以及來源作業的完成狀態。
- 固定的匯出設定,以及本次匯入的來源資料列範圍。
- 已接受、重複與已拒絕的資料列。
- 最後一個已完成處理並持久儲存的來源位置。
- 匯入開始時間、結束時間與完成狀態。
- 拒絕資料列的原因。
「已接受」表示已儲存一筆新的觀測紀錄。「重複」表示相同的來源觀測紀錄先前已儲存。「已拒絕」表示依照你明定的規則,該資料列需要修正或審查。
分別保留每次匯入嘗試的計數。將多次重試的回執計數相加,得不到不重複觀測紀錄的筆數。
載入資料列前,先選定觀測紀錄識別鍵
識別鍵是用來識別一筆紀錄的值。觀測紀錄識別鍵必須識別來源資料列,不能只識別 Instagram 貼文。
只使用 `postId`,會把該貼文之後的所有檢查合併。使用匯入時間,則會在每次重試時建立新的觀測紀錄。貼文說明文字,或貼文在創作者個人檔案清單中的位置,也無法識別某次收集到的觀測紀錄。
對於穩定且已完成的資料集,請使用執行作業識別碼與資料集項目的原始位置。同時保留該識別鍵所對應的資料集識別碼。實用的儲存規則是:讓執行作業識別碼、資料集識別碼與項目位置的組合具有唯一性。
唯一性規則可防止資料表接受兩筆組合相同的紀錄。請在儲存層套用這項規則,不要只依賴應用程式在插入前進行檢查。
請依照以下步驟操作:
- 若報表規則要求使用穩定且已完成的資料,請選取已完成的來源執行作業。
- 儲存其執行作業識別碼與資料集識別碼。
- 固定原始資料的匯出設定,並固定使用來源升冪順序。
- 記錄預計匯入的來源範圍。
- 在排序、篩選或展開資料列之前,先指定原始絕對位置。
- 每次重試時,保持這些位置不變。
絕對位置是指項目在完整來源清單中的位置。如果一頁包含位置 0 到 99,下一頁就從 100 開始,不會重新從 0 開始。請明確說明位置編號從 0 還是 1 開始。
Apify 文件說明,資料集儲存採用僅附加模式:可以新增儲存項目,但不能修改或刪除現有項目。這有助於保留來源資料列。但這個特性本身並不能確保篩選或重新排序後的匯出資料,具有安全可靠的匯入識別資訊。Apify 資料集文件,已於 2026 年 10 月 25 日核對;說明僅附加儲存與資料擷取的事實,不保證匯入安全。
如果無法保留穩定的來源位置,請將原始資料列轉為固定的表示形式,再依照已記錄的方法計算雜湊值。雜湊值是根據內容計算出的識別值。每次重試都必須使用相同欄位、文字表示形式與計算方法。同時保留執行作業與資料集的參照資訊。
使用這個替代方法時必須謹慎。內容相同的資料列可能產生相同的雜湊值,即使它們原本位於不同的來源位置。使用前,先定義這些資料列代表一筆還是兩筆觀測紀錄。如果必須保留每一筆傳回的資料列,請優先使用穩定的來源位置。
如果現有識別鍵對應到不同的原始內容,請停止並審查衝突。不要在未告知的情況下覆寫已儲存的觀測紀錄,也不要將它視為一般重複資料。
將資料列與進度作為單一操作儲存
重新啟動的主要風險,發生在儲存資料列與儲存進度之間。應用程式可能在其中一項成功後、另一項完成前停止。
交易是將相關變更作為單一操作儲存的機制。如果儲存工具支援交易,請一併提交已接受的觀測紀錄及其進度位置。相關回執的變更也必須與該次提交保持一致。
請依照以下順序匯入:
- 讀取下一批來源資料列及其原始位置。
- 依照接受規則檢查每筆資料列。
- 建立該資料列的觀測紀錄識別鍵。
- 識別鍵不存在時,插入一筆新的觀測紀錄。
- 若有相符的現有觀測紀錄,將其計為重複。
- 記錄已拒絕的資料列及其原因。
- 只有在資料列與拒絕紀錄都已持久儲存後,才儲存進度。
持久儲存是指儲存系統已保存變更,即使匯入流程停止,變更仍會保留。
不要只因某個計數欄位缺漏,就拒絕其他方面有效的來源資料列。該資料列仍可記錄一次收集嘗試,以及其他可用的計數值。請保留缺漏值及其狀態。
保留足夠的來源資訊,以便審查已拒絕的資料列。進度位置超過某筆已拒絕的資料列時,不得讓該資料列被遺漏。請先儲存拒絕紀錄,再推進進度;或停在該處,直到問題解決。
如果儲存工具無法一併提交資料列與進度,請先儲存資料列,再推進進度。流程停止後,對任何處理狀態不確定的範圍,使用相同的唯一識別鍵重新匯入。這可能產生重複資料列,但不得新增額外的觀測紀錄。
重新匯入時,不要產生新的 `scrapedAt`。不同嘗試的 `imported_at` 可以改變,但收集時間不能改變。
逐步檢視一次匯入與重新啟動
以下範例為原創虛構情境,不是 Actor 輸出、客戶成果或測試結果。所有時間都屬於同一個虛構日期,並採用 UTC。UTC 是一種通用時間標準。
執行作業 A 包含兩筆資料列。本範例的來源位置從 0 開始。
| 執行作業 | 原始位置 | 貼文 | 收集時間 | 觀看次數 |
|---|---|---|---|---|
| A | 0 | P1 | 10:00 UTC | 100 |
| A | 1 | P2 | 10:01 UTC | 缺漏 |
| B | 0 | P1 | 11:00 UTC | 120 |
首先,匯入執行作業 A。資料表將 P1 與 P2 儲存為兩筆觀測紀錄。P2 沒有可用的觀看次數,但仍保留為一筆觀看次數缺漏的觀測紀錄。
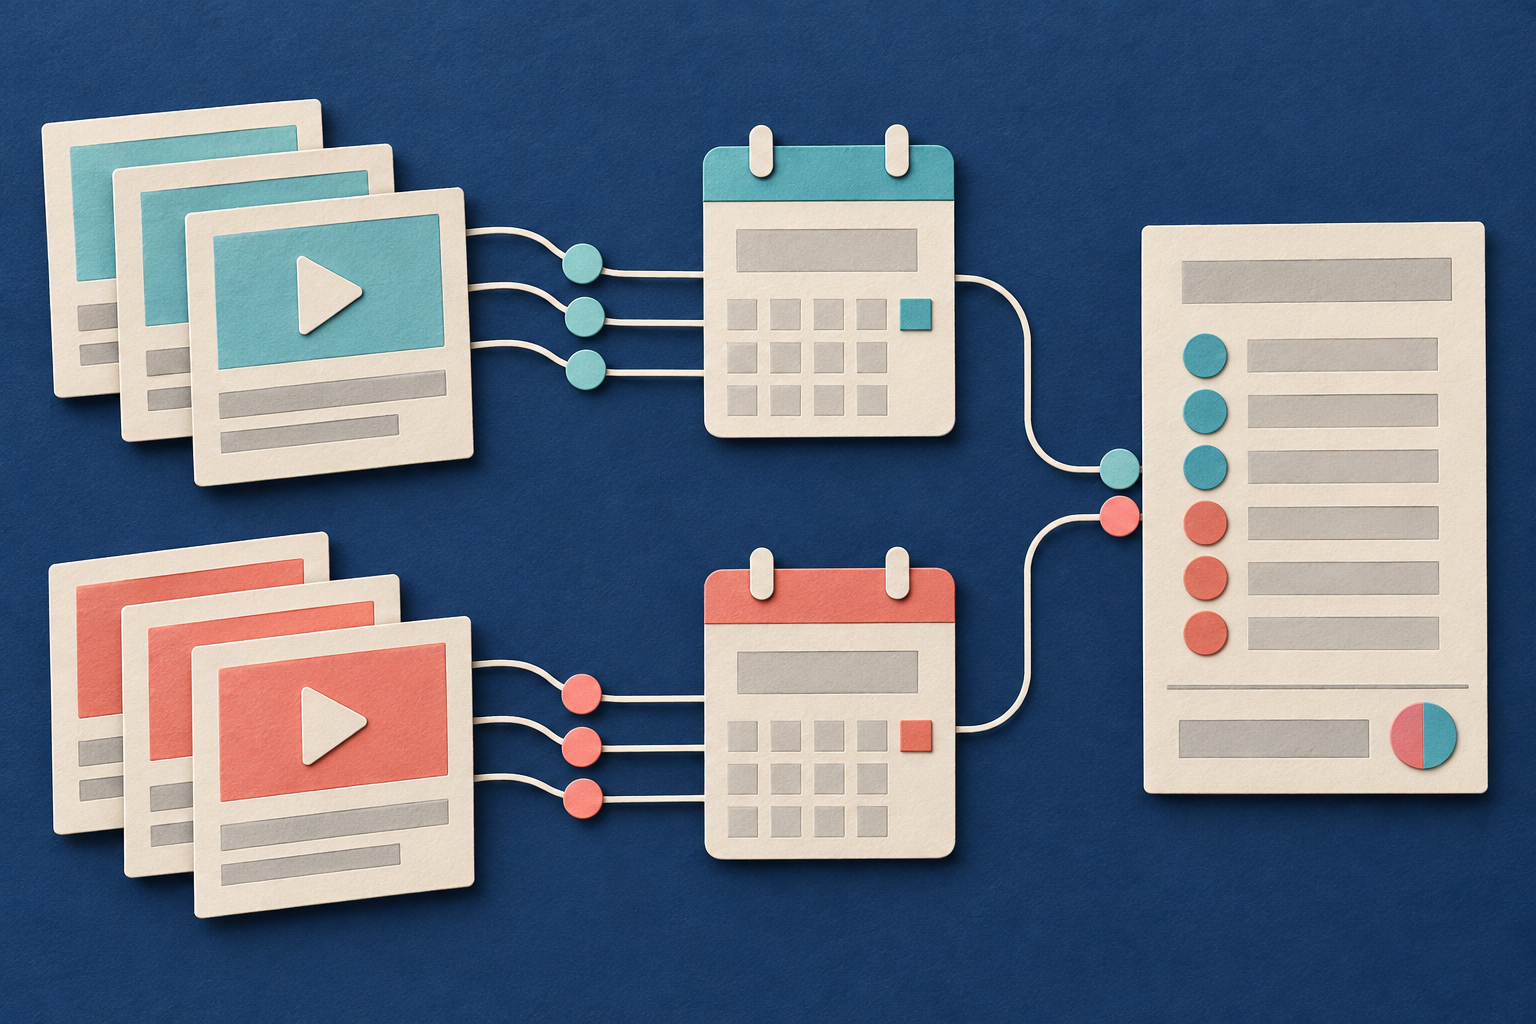
接著,重新匯入執行作業 A。兩個來源資料列識別鍵都已存在。本次匯入不會新增觀測紀錄,並回報兩筆重複資料列。
然後,匯入執行作業 B。其中 P1 資料列所屬的執行作業不同。即使資料表中已有 P1,也要將它儲存為新的觀測紀錄。
| 匯入嘗試 | 新增觀測紀錄 | 重複資料列 | 已儲存觀測紀錄總數 |
|---|---|---|---|
| 首次匯入 A | 2 | 0 | 2 |
| 重新匯入 A | 0 | 2 | 2 |
| 首次匯入 B | 1 | 0 | 3 |
計算如下:
- 首次匯入:0 筆觀測紀錄 + 2 筆新增觀測紀錄 = 2 筆觀測紀錄。
- 重新匯入:2 筆觀測紀錄 + 0 筆新增觀測紀錄 = 2 筆觀測紀錄。
- 新的執行作業:2 筆觀測紀錄 + 1 筆新增觀測紀錄 = 3 筆觀測紀錄。
兩次執行作業共產生三筆觀測紀錄。三次匯入嘗試共發生五次資料列處理事件,但這些事件不代表五筆觀測紀錄。P2 的觀看次數仍然缺漏,不會變成零。
現在,考慮同一原創虛構情境的另一種重新啟動情況。首次匯入 A 時,流程在儲存 P1 後停止,尚未儲存 P2。
如果已儲存的進度可靠,就從 P2 重新開始。這次重新啟動會新增一筆觀測紀錄。完成後,資料表中共有兩筆來自 A 的觀測紀錄。
如果進度不確定,就從頭重新匯入 A。P1 會計為一筆重複資料列,P2 則會新增為一筆觀測紀錄。完成後,資料表中仍共有兩筆來自 A 的觀測紀錄。
匯入 B 後,兩種重新啟動方式都會得到相同的三筆已儲存觀測紀錄。這就是重試檢查應驗證的結果。
建立最新資料顯示方式,保留歷史紀錄
檢視表是由已儲存紀錄組成的查詢結果。請建立最新讀值檢視表,不要取代舊的觀測紀錄。
有效的觀測時間應依 `scrapedAt` 排序,不要依匯入時間排序。今天匯入昨天已完成的執行作業,不得讓昨天的計數值看起來比今天收集的讀值更新。
每篇貼文應分別顯示以下兩項資訊:
- 最近一次已儲存的收集嘗試。
- 每個所需計數欄位的最新可用讀值,以及該讀值的原始時間。
較新的資料列可能缺少觀看次數,而較舊的資料列有可用的觀看次數。你可以保留舊值供參考,但必須顯示它較早的時間,以及較新一次收集的缺漏結果。不要將舊值顯示為新的量測結果。
不同計數欄位的「最新可用」讀值可能來自不同資料列。具有可用按讚次數的最新資料列,可能不同於具有可用觀看次數的最新資料列。請分別保留它們的時間。
發布前,請記錄以下排序情況的處理方式:
- 收集時間相同:保留兩筆來源觀測紀錄。顯示時間相同的情況,或套用明定的顯示規則。顯示規則無法證明哪個讀值較晚取得。
- 收集時間缺漏:保留來源資料列,但在審查前,不納入依時間排序的結果。
- 收集時間無效:記錄問題。未清楚標示時,不要以匯入時間代替。
- 未傳回資料列:另行記錄收集缺口。不要編造觀測紀錄,也不要填入零計數值。
後續計算可參閱 Instagram 月報指南。此匯入方法能保留觀測紀錄,但無法補出缺漏的月份交界讀值。指標歷史資料指南也說明了檢查出現間隔缺口時,實際觀測時間為何重要。
先使用小規模收集輸入,再檢查匯入
Chronometrica 的 Instagram Metrics Scraper 文件記載了直接指定內容的輸入方式,以及這套建議儲存方法所需的欄位。文件顯示它符合這些需求,不代表它會替你建立歷史資料表,或強制執行匯入識別鍵規則。
Task 是為 Actor 儲存的一組輸入預設值。公開的 Instagram Post Metrics Tracker Task 可作為起點。提供的頁面檢查只確認它公開存在,沒有登入驗證已儲存的設定,也沒有執行這組預設值。Instagram Post Metrics Tracker,已於 2026 年 10 月 25 日核對;僅確認公開頁面存在,未登入檢查輸入設定,也未付費執行。
使用以下提供的小規模輸入:
{"maxItems":1,"mode":"contentUrls","startUrls":["https://www.instagram.com/reel/DIwcCZgxVZP/"]}`mode` 選擇 Actor 處理輸入的方式。`contentUrls` 選擇直接檢查內容。`startUrls` 包含預計檢查的內容網址。`maxItems` 限制傳回的指標資料列數量。
將範例網址替換成一個已知的公開貼文或 Reel 網址。Reel 是 Instagram 的一種影片格式。請替換整個範例清單,不要將自己的網址加在範例網址旁。使用前,先檢查已儲存的設定。
此輸入已通過靜態結構描述檢查。這項檢查依據所提供的公開結構描述,確認輸入格式符合規定。它不會確認線上內容目前是否可用,也不會確認收集能否成功。公開輸入結構描述,已於 2026 年 10 月 25 日核對;僅進行靜態驗證,未付費執行。
以下是建議讀者自行執行的檢查:
- 收集一個預定的公開項目,並保留已完成執行作業與資料集的參照資訊。
- 匯入其資料列,並記錄已接受、重複與已拒絕的筆數。
- 再次匯入同一來源。確認新增觀測紀錄為 0 筆。
- 在匯入途中停止流程,再重新啟動。確認最終的來源資料列識別鍵與完整匯入的結果相同。
- 針對同一項目執行新的收集作業。確認它會建立新的觀測紀錄。
- 確認所有已儲存的 `scrapedAt` 值都與來源資料列相符。
- 確認缺漏的計數值仍維持缺漏,且較舊的可用計數值保留原始時間。
執行作業已完成,不代表每個要求收集的項目都有可用的計數值。請比對預定內容清單與傳回的資料列,並另行記錄缺口。
來源與延伸閱讀
- Instagram Metrics Scraper 公開規格,已於 2026 年 10 月 25 日核對;文件記載公開輸入與輸出,未付費執行,也未測試目前的實際執行狀態
- 公開預設建置版本 1.0.35,已於 2026 年 10 月 25 日核對;提供結構描述與文件所載欄位的證據,並非實測的執行行為
- Apify 資料集文件,已於 2026 年 10 月 25 日核對;提供僅附加儲存與資料擷取的證據,穩定的匯入識別資訊仍須依靠固定的來源順序
- Instagram Post Metrics Tracker Task,已於 2026 年 10 月 25 日核對;僅確認公開預設值存在,未登入驗證已儲存的設定,也未付費執行
- 定期量測提問,於 2026 年 8 月 12 日觀察到;發布日期不詳,僅是一則公開提問,不構成市場需求或產品使用的證據
作者 Chronometrica · 更新日期
返回頂端 ↑