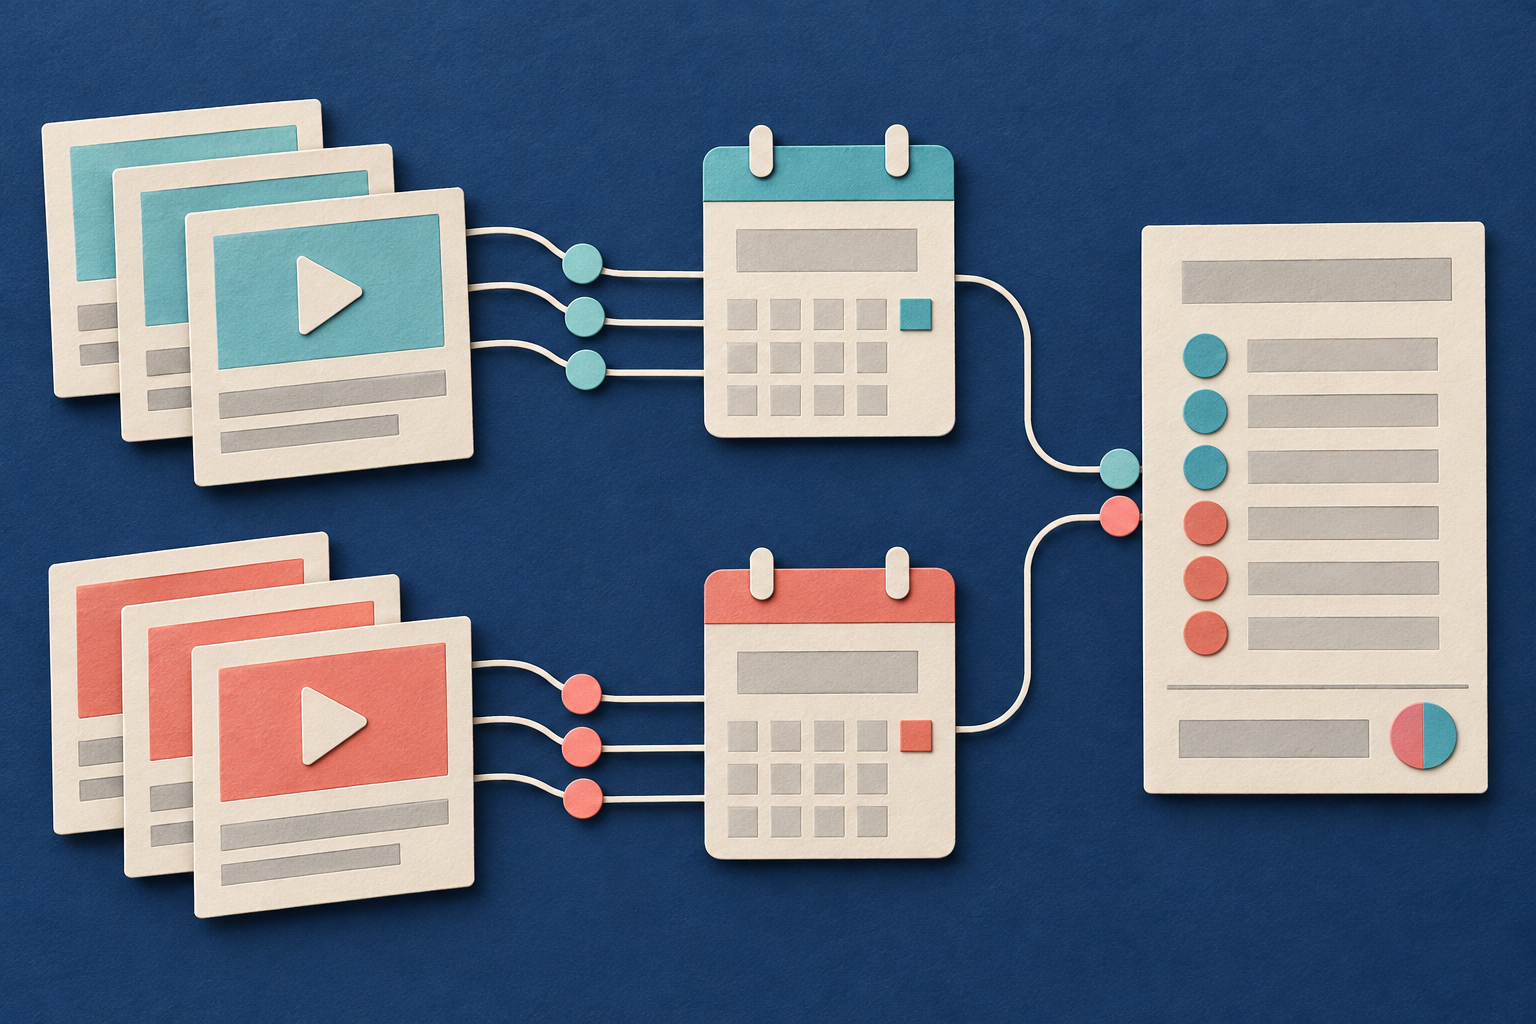
Um cadastro é uma lista salva com uma entrada para cada ID de comentário conhecido. Uma exportação é um arquivo com os registros coletados. Este guia explica como criar esse cadastro para publicações e Reels públicos conhecidos do Instagram. Um Reel é um formato de vídeo do Instagram. O escopo inclui comentários de primeiro nível: comentários na própria publicação, em vez de respostas a outro comentário.
Em uma pergunta pública, um leitor quis saber se poderia coletar apenas os comentários mais recentes, como os da última hora. Essa pergunta contém duas necessidades diferentes: encontrar horários de publicação recentes e encontrar registros ausentes de um cadastro existente. O método a seguir atende à segunda necessidade. Uma pergunta pública não estabelece quantas pessoas têm essa necessidade. Pergunta de um leitor, publicada em 22 de junho de 2021; consultada em 11 de agosto de 2026; uma pergunta, sem uso verificado do produto.
1. Defina as publicações e os limites da coleta
Comece com uma lista escrita de URLs de publicações públicas conhecidas. Uma URL é um endereço da web. Mantenha a mesma lista ao comparar execuções ou registre cada alteração na lista. Uma execução é uma realização do programa de coleta com um conjunto de dados de entrada.
Anote estas escolhas antes da coleta:
- Liste as publicações públicas que você vai verificar.
- Escolha o intervalo entre as verificações.
- Defina quanto atraso ou falta de cobertura seu uso pode aceitar.
- Defina o número máximo de comentários salvos por publicação.
- Escolha a ordem dos comentários.
- Registre todos os filtros de data de publicação usados.
- Atribua a cada coleta uma referência que você possa guardar com a exportação.
Um limite é o número máximo de registros que você solicita salvar. Ele não é uma quantidade prometida de resultados. O intervalo de coleta indica quando você pretende verificar novamente. Ele não comprova que todos os comentários entre as verificações aparecerão.
Se seu uso exige comprovação de que todos os novos comentários foram capturados, este método não pode fornecer essa comprovação. Ele fornece um registro dos comentários observados e dos limites visíveis da coleta.
O Instagram Comments Scraper da Chronometrica é um Actor, ou seja, um programa de coleta hospedado. Seu contrato público verificado documenta entradas de publicações públicas conhecidas, registros de comentários de primeiro nível, filtros de data e um limite por publicação. Não há entrada documentada para coletar desde a última execução ou apenas comentários novos. Seu próprio processo de comparação deve identificar os IDs ainda não observados. Instagram Comments Scraper, verificado em 25 de outubro de 2026; adequação documentada à coleta pública, sem teste de execução para este guia.
Este guia usa registros públicos. Ele não obtém registros de contas privadas nem relatórios de conta exclusivos do proprietário. Não descreva o cadastro como um histórico completo de notificações da conta ou como todo o histórico de comentários de um usuário no Instagram.
2. Mantenha um cadastro e um registro separado de observações
Use duas tabelas salvas. Uma tabela contém registros em linhas e valores com nomes em colunas. Uma chave é um valor, ou uma combinação de valores, que identifica um registro.
O cadastro de comentários usa `commentId` como chave. O contrato documentado descreve esse campo como o ID estável do Instagram de um comentário de primeiro nível. Armazene os IDs como texto para manter seus caracteres exatos sem alterações.
O registro de observações documenta cada coleta em que você viu esse ID. Use a combinação de `commentId` e da referência da coleta como chave. Isso permite que um comentário apareça em várias coletas sem se tornar várias identidades de comentários.
As tabelas a seguir propõem campos para seu armazenamento. Campos como `first_seen_at` e `collection_ref` pertencem ao seu processo. Eles não são campos adicionais de saída do Actor.
| Campo do cadastro | O que salvar | Regra |
|---|---|---|
| `commentId` | ID estável do comentário na fonte | Uma entrada no cadastro por ID conhecido |
| `postUrl` | Endereço canônico da publicação pública | Preserve o valor da fonte |
| `postId` | ID da publicação na fonte, quando disponível | Mantenha ausente um valor ausente |
| `postShortCode` | Código curto do endereço da publicação | Use-o para verificar a identidade da publicação |
| `createdAt` | Horário de publicação do comentário informado pela fonte | Mantenha separado do horário de observação |
| `first_seen_at` | Horário em que seu processo aceita o ID pela primeira vez | Defina uma vez e preserve no reprocessamento |
| `first_seen_collection_ref` | Referência da primeira coleta aceita | Preserve o vínculo com as evidências da fonte |
| `original_text` | Texto do primeiro registro aceito | Não o substitua sem registrar a alteração |
| Campo da observação | O que salvar | Regra |
|---|---|---|
| `commentId` | ID do comentário correspondente ao cadastro | Não use o texto para determinar a correspondência |
| `collection_ref` | Referência desta coleta | Reutilize-a ao importar a mesma exportação |
| `collectedAt` | Horário de coleta do Actor informado na linha | Não o substitua pelo horário de importação |
| `text` | Texto retornado nesta coleta | Mantenha versões datadas |
| `raw_export_ref` | Referência à exportação sem alterações | Permita rastrear a linha de origem |
| `text_change` | Resultado da sua comparação | Sinalize uma diferença em relação ao texto salvo anteriormente |
Guarde também a exportação original completa. JSON é um formato de texto para registros estruturados. Preservar o JSON original ajuda a verificar os valores depois de criar as tabelas.
Mantenha os três horários separados
`createdAt` registra quando a fonte informa que o comentário foi publicado. O valor pode ser null, que significa indisponível.
`collectedAt` registra quando o Actor coletou o comentário, em UTC. UTC é um padrão de tempo comum. Preserve esse horário da linha de origem.
`first_seen_at` registra quando seu cadastro aceita o ID do comentário pela primeira vez. Declare essa regra na nota sobre seu método. Se você importar hoje uma exportação antiga, o horário de coleta continua sendo o horário antigo. A primeira aceitação no cadastro ocorre hoje. Não faça os horários parecerem iguais, a menos que eles sejam de fato iguais segundo a regra definida.
A saída verificada também documenta dados do autor, contagens de curtidas e contagens de respostas. Uma contagem de respostas não é o texto das respostas. Mantenha contagens iguais a zero separadas de contagens indisponíveis. Mantenha o valor false de `ownerVerified` separado de null. Um ID de autor ausente não significa um ID de autor igual a zero e não invalida um ID de comentário válido. Compilação pública 0.1.21, verificada em 25 de outubro de 2026; campos e regras de null documentados, sem resultado de execução atual.
Este cadastro conta identidades de comentários. Ele não conta contas distintas nem pessoas. Se você também precisa de um arquivo de trabalho verificado, o guia de amostra de comentários públicos explica um fluxo separado de exportação e importação. Mantenha esse trabalho separado da decisão sobre se um ID foi observado pela primeira vez.
3. Verifique uma publicação com uma entrada pequena
Comece com uma publicação pública conhecida e um limite de 10. Use a entrada fornecida:
{"collectAllAvailable":false,"commentSortMode":"default","maxCommentsPerPost":10,"postUrls":["https://www.instagram.com/reel/DZu6dkVyImf/"]}Substitua o endereço do Reel de exemplo pelo endereço da publicação pública ou do Reel que você pretende coletar. Substitua o exemplo em vez de adicionar seu endereço ao lado dele.
`postUrls` contém os endereços de destino. `maxCommentsPerPost` limita os comentários únicos de primeiro nível salvos para cada publicação. `commentSortMode` seleciona a ordem. O valor `default` mantém a ordem padrão do Instagram. O valor false de `collectAllAvailable` mantém o limite numérico em vigor.
A entrada fornecida passou por uma verificação estática de esquema. Um esquema define os campos de entrada e os tipos de valores aceitos. A verificação confirma o formato da entrada. Nenhuma execução foi feita para este guia, e a verificação não confirma a disponibilidade em uso real. Contrato público de entrada, verificado em 25 de outubro de 2026; apenas validação estática, sem execução paga.
Depois da sua própria execução, siga estas etapas:
- Salve a entrada exata e a referência da coleta.
- Guarde a exportação sem alterações.
- Compare cada endereço de publicação e código curto retornados com a publicação solicitada.
- Confira os IDs, os textos e os horários dos comentários com os registros originais.
- Separe os registros cuja identidade do comentário ou correspondência com a publicação não possa ser confirmada.
- Adicione os IDs aceitos ao cadastro inicial.
A saída documentada permite um `postId` com valor null. Verifique o endereço da publicação e o código curto disponíveis em vez de inventar um ID de publicação. A ausência de `commentId` impede uma correspondência confiável com o cadastro. Mantenha essa linha como pendente, ou seja, ela precisa de revisão antes da aceitação. Palavras idênticas não resolvem a falta de um ID.
Use a primeira coleta como seu cadastro inicial. Seus IDs passam a ser conhecidos por esse cadastro. A presença deles não comprova que os comentários foram publicados recentemente.
4. Compare a próxima exportação por ID
Em cada coleta posterior, compare os IDs de comentários aceitos com o cadastro no estado anterior àquela atualização.
- Se um ID estiver ausente do cadastro, adicione uma entrada de comentário.
- Defina seu `first_seen_at` conforme a regra de primeira aceitação declarada.
- Preserve o `createdAt` da fonte, inclusive null quando estiver indisponível.
- Adicione a observação com a referência da coleta e `collectedAt`.
- Se o ID já existir, mantenha a entrada no cadastro e adicione a nova observação.
- Compare seu texto com o texto salvo anteriormente.
- Guarde o texto alterado como outra versão datada e sinalize a diferença.
“Observado pela primeira vez” significa que o ID era desconhecido pelo cadastro. “Repetido” significa que o ID já era conhecido antes da atualização desta coleta. Nenhum desses rótulos depende da data de publicação do comentário.
Dois comentários podem ter palavras idênticas e IDs diferentes. Guarde ambos. Um ID pode aparecer em várias coletas. Mantenha uma entrada no cadastro e várias referências de observação.
Se o texto de um ID conhecido for diferente, preserve o texto anterior usado em qualquer relatório anterior. A comparação comprova uma diferença entre os registros salvos. Ela não comprova, por si só, quem alterou o texto nem por quê.
Mantenha o resultado da atualização vinculado à referência da coleta. No reprocessamento, reutilize esse resultado em vez de apresentar novamente os IDs novos originais como novas descobertas. Reprocessar significa processar novamente a mesma exportação salva.
O histórico de métricas tem outra unidade: uma leitura salva de uma contagem. O guia de registros pontuais do Instagram trata desse problema separado. Aqui, uma observação posterior do mesmo comentário acrescenta evidências sobre uma identidade. Ela não acrescenta outra identidade de comentário.
5. Acompanhe uma descoberta tardia
O exemplo detalhado a seguir é uma ficção original. Ele não é uma saída do Actor, um resultado de cliente nem um resultado de teste. Todos os horários se referem ao mesmo dia fictício em UTC. Considere que o cadastro aceita cada exportação no horário de verificação indicado.
Às 10:00, a primeira exportação com limite contém C1 e C2. Os dois IDs entram no cadastro vazio.
Às 11:00, a segunda exportação contém C2 e C3. O horário de publicação de C3 informado pela fonte é 09:30. Ele foi publicado antes da primeira verificação, mas não estava na primeira exportação.
| Coleta | IDs exportados | IDs observados pela primeira vez | IDs repetidos |
|---|---|---|---|
| Primeira, às 10:00 | C1, C2 | C1, C2 | Nenhum |
| Segunda, às 11:00 | C2, C3 | C3 | C2 |
O cálculo do cadastro é:
- Após a primeira atualização: 0 identidades de comentários conhecidas + 2 novas identidades = 2 identidades conhecidas.
- Segunda atualização: 2 identidades conhecidas + 1 nova identidade = 3 identidades conhecidas.
- Segunda exportação: 1 ID repetido + 1 ID observado pela primeira vez = 2 IDs distintos exportados.
O cadastro agora contém C1, C2 e C3. São três identidades de comentários conhecidas. Isso não é uma contagem de três pessoas.
| ID do comentário | Primeira observação | Horário de publicação usado neste exemplo | Resultado da segunda coleta |
|---|---|---|---|
| C1 | 10:00 | Não especificado | Não observado |
| C2 | 10:00 | Não especificado | ID repetido |
| C3 | 11:00 | 09:30 | ID observado pela primeira vez |
C3 mantém `createdAt` às 09:30 e `first_seen_at` às 11:00. Não o descreva como publicado após as 10:00. “Não especificado” para C1 e C2 significa que este exemplo fictício não fornece um horário de publicação. Não significa meia-noite nem zero.
C1 permanece no cadastro. Sua ausência na segunda exportação não comprova exclusão nem moderação. Este exemplo não estabelece por que ele estava ausente.
As duas coletas contêm quatro registros de observação: 2 observações + 2 observações = 4 observações. O cadastro contém três identidades de comentários. Esses totais medem coisas diferentes.
Agora reprocesse a segunda exportação com a mesma referência de coleta. O resultado esperado no cadastro é:
- 3 identidades de comentários existentes + 0 novas identidades = 3 identidades conhecidas.
- 0 novas entradas de primeira observação.
- 0 registros adicionais de observação para as mesmas chaves de comentário e coleta.
A primeira observação de C3 continua às 11:00. Reprocessar o arquivo não cria outra descoberta.
6. Use filtros de data com uma sobreposição explícita
O Actor documenta `commentsFrom` e `commentsUntil` como filtros de datas dos comentários. Eles não filtram pelo horário da primeira observação no cadastro. Contrato público de entrada, verificado em 25 de outubro de 2026; entradas de data documentadas, sem opção desde a última execução nem teste de execução.
Se usar filtros de data, defina uma sobreposição entre os períodos de coleta. Uma sobreposição significa que o próximo período de datas inclui parte do período anterior. Compare os IDs para impedir que esses registros repetidos criem novas entradas no cadastro.
Escolha e registre a sobreposição para seu uso. As evidências fixadas para este guia não estabelecem uma duração de sobreposição segura para todos os casos.
O C3 fictício mostra o risco restante. Uma solicitação posterior que excluísse horários de publicação anteriores às 10:00 excluiria o horário de publicação de C3, às 09:30. Esse comentário continuaria sem ser descoberto, embora seu cadastro nunca o tivesse observado.
Uma sobreposição pode incluir datas de publicação mais antigas. Ela não comprova a descoberta de todos os comentários. Comentários fora do período escolhido ainda podem ficar ausentes do resultado.
A configuração de ordem também tem limites. `newest` e `oldest` ordenam por data a amostra coletada de comentários de primeiro nível. Eles não comprovam que todos os comentários elegíveis chegaram à amostra. A ordem padrão não comprova uma coleta cronológica.
Definir `collectAllAvailable` como true remove o limite numérico. A execução documentada ainda pode parar quando o fluxo público termina, o tempo se esgota ou a fonte falha. Portanto, remover o limite não comprova a cobertura completa da fonte e pode custar muito mais. Mantenha a configuração com limite enquanto verifica o método do cadastro.
7. Registre as lacunas de cada publicação solicitada
Mantenha uma nota de cobertura junto de cada coleta. Cobertura significa a parte da fonte solicitada que o resultado salvo permite comprovar. Compare a lista de publicações solicitadas com cada exportação, inclusive nas solicitações que não produzem linhas aceitas.
| Item de cobertura | O que registrar |
|---|---|
| Referência da coleta | A execução e a exportação sem alterações usadas |
| Publicações solicitadas | A lista exata de publicações pretendidas |
| Limites de entrada | Limite, ordem, filtros de data e configuração do limite de resultados |
| Registros retornados | Linhas brutas e IDs distintos de comentários aceitos |
| Registros pendentes | Identidade ausente ou correspondência não confirmada com a publicação |
| Falhas | Falhas de coleta registradas e publicações afetadas |
| Limite de cobertura | Efeitos conhecidos do limite e outras informações de contexto ausentes |
Não transforme um estado desconhecido em um resultado bem-sucedido. Se você não puder confirmar por que a coleta parou, registre que o motivo é desconhecido.
Mantenha estes estados de falha separados:
- Nenhuma linha retornada: Nenhum comentário foi observado nesse resultado. Isso não comprova que a publicação tinha zero comentários.
- Identidade do comentário ausente: Preserve a linha bruta para revisão. Não determine a correspondência pelo texto nem pelo nome do autor.
- Correspondência não confirmada com a publicação: Mantenha a linha pendente até confirmar a publicação de destino.
- Limite conhecido atingido: Informe o limite como uma restrição de cobertura. Não o trate como a contagem total de comentários da publicação.
- ID conhecido ausente em coleta posterior: Preserve a entrada no cadastro. Não afirme que houve exclusão ou moderação.
- Horário indisponível: Mantenha-o ausente. Não o substitua por um horário de publicação nem pelo horário da primeira observação.
- Entrada alterada: Registre a alteração. Um limite, uma ordem ou um período de datas diferente altera o escopo da comparação.
A saída documenta contagens públicas de curtidas e respostas. Zero é um zero conhecido. Null significa indisponível. Nem uma contagem de respostas ausente nem uma contagem diferente de zero fornece o texto das respostas. Preserve esses significados ao guardar os registros brutos.
8. Verifique a atualização antes de usá-la
Entregue quatro resultados separados para cada coleta: IDs observados pela primeira vez, IDs repetidos, casos de texto alterado e pendências de cobertura. Os casos de texto alterado também podem ser IDs repetidos. Não some grupos que se sobrepõem como se fossem totais separados de comentários.
Aceite a atualização somente após estas verificações:
- Rastreie cada ID aceito até sua publicação de origem e exportação bruta.
- Confirme que os IDs novos estavam ausentes do cadastro antes da atualização.
- Confirme que os horários de publicação mais antigos permanecem sem alterações.
- Confirme que os IDs conhecidos mantêm sua primeira observação original.
- Confirme que o texto alterado mantém suas versões datadas.
- Reprocesse a mesma exportação com a mesma referência de coleta.
- Confirme zero novas identidades de comentários e zero novas entradas de primeira observação no reprocessamento.
- Verifique se cada publicação solicitada tem um resultado ou uma lacuna declarada.
Estas são verificações propostas para seu processo. Elas não são resultados de uma execução feita para este artigo.
Fontes e leituras adicionais
- Página pública do Instagram Comments Scraper, contrato verificado em 25 de outubro de 2026; apenas adequação documentada, sem execução paga nem confiabilidade medida
- Compilação padrão pública 0.1.21, verificada em 25 de outubro de 2026; contratos estáticos de entrada e saída e README, sem resultado de execução
- Tarefa Export Instagram Comments to CSV, verificada em 25 de outubro de 2026; apenas presença da página pública, entrada salva não verificada com autenticação e tarefa não executada
- Pergunta sobre coleta de comentários recentes, publicada em 22 de junho de 2021; consultada em 11 de agosto de 2026; uma pergunta pública, sem estimativa de demanda nem uso verificado do produto
Por Chronometrica · Atualizado
Voltar ao topo ↑