Actorは、ホスティング環境で動くデータ収集プログラムです。この記事では、当社のChronometrica YouTube Search ScraperとStreamers YouTube Scraperを比較します。目的は、収集ルールを説明できる、小規模で役に立つ動画リストを作ることです。
検索パネルとは、あらかじめ定めた複数の検索クエリを、1つの固定ルールで収集する枠組みです。たとえば、2つのクエリに共通の上限を設けて収集できます。その結果は、調査、情報源の確認、その後のトピック分析に使えます。ただし、YouTubeを網羅できたことを示すものではありません。
ここで使う公開仕様は、2026年10月20日に確認しました。入力例は、スキーマによる検証に合格しています。実行はしていないため、取得件数や性能の実測結果はありません。
Actorを選ぶ前に、1行が表す単位を決める
制御項目を比較する前に、1行で何を表す必要があるかを決めてください。
重複のない動画の表では、各行がそれぞれ別の動画IDを表します。同じ動画が2つのクエリで見つかっても、この形式の表では、その動画について1行だけを保存します。
クエリと動画の検出記録は、特定のクエリで動画が見つかったことを表します。同じ動画でも、異なるクエリで見つかれば、それぞれ別の検出記録になります。
この2つの単位は、異なる問いに答えます。重複しない動画の表は、「このパネルで収集した動画は、重複を除くとどれか」に答えます。検出記録の表は、「各クエリで、どの動画が見つかったか」を確認するのに役立ちます。1つの表で両方の問いに十分答えられるとは限りません。
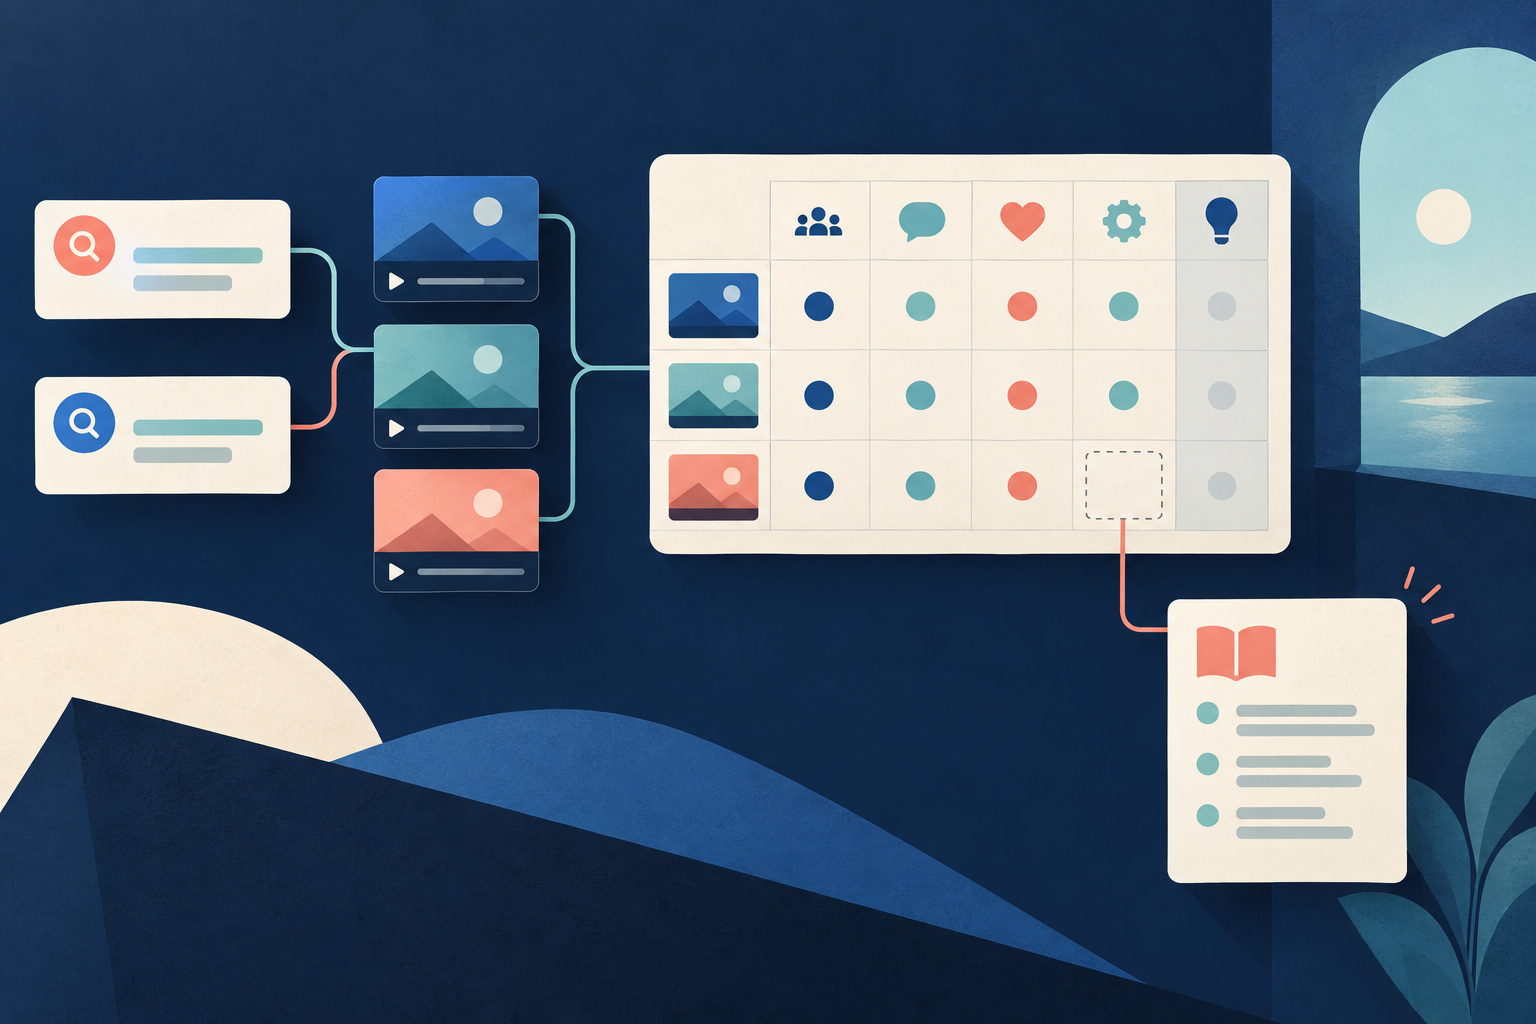
Chronometricaは、`maxResults`を使い、全クエリを通じて保存する重複のない動画の件数に上限を設けます。重複する動画IDは取り除きます。出力には、`rootQuery`、`query`、`querySource`などのフィールドでクエリの文脈が含まれます。出力とサマリーには、クエリ別の集計も残ります。保存した各動画の取得元が記録された、件数制限のある情報源リストが必要な場合に役立つ強みです。Chronometricaの公開仕様
重複を除くと、残した1行だけでは、同じ動画が複数のクエリで見つかったすべての検出記録を保持できなくなります。クエリの文脈は、その行を説明する助けになります。ただし、記録された1つの取得元は、その動画を見つけたすべてのクエリの一覧ではありません。
必要な成果物が、この重複のない情報源リストなら、Chronometricaを選べます。すべての検出記録を含む表が必要なら、まず、その記録をどう保持するか確認してください。重複を除いたエクスポートに含まれているとは考えないでください。
選択を左右する制御項目を比較する
どちらのActorも、YouTubeの検索結果を収集し、取得件数を制限できます。選ぶうえで重要なのは、プロジェクトに必要な収集ルールです。
| 判断項目 | Chronometrica | Streamers |
|---|---|---|
| この比較で注目する収集用途 | クエリの文脈を明示した、重複のない動画の検索パネル | キーワード検索、URL直接指定、より広い範囲の収集 |
| 上限 | 重複しない動画の全体件数上限とページ制御 | 通常の動画、Shorts、配信それぞれの件数上限 |
| クエリの処理順序 | クエリを交互に処理、または順番に処理 | 必要な収集ルールに対応するか、スキーマで確認 |
| 検索時に使える制御項目 | 文書に記載されたパネル用の入力項目を確認 | 並べ替え、日付、動画の種類、長さなどのフィルター |
| 追加オプション | ここでの判断は検索結果の収集に絞る | 字幕と、任意で使えるAIのオプション |
出典:Chronometricaの入力スキーマ、Streamersの入力スキーマ。
調査のために、検索時点で直近1か月に絞るフィルターや、動画の長さで絞るフィルターが必要だとします。その場合は、Streamersの文書に記載された制御項目を検討してください。Chronometricaに同じ入力項目があるとは限りません。収集後にフィルターをかけると、保存済みのどの行を残すかが変わります。しかし、収集元での検索に同じルールを適用したことにはなりません。Streamersの入力スキーマ
この比較は、Streamersにクエリの文脈がないと示すものではありません。Chronometricaを選ぶ理由は、検索パネルの仕様が明示されていることです。機能の掲載数ではなく、適用する必要があるルールに基づいて選んでください。
設定を明示して小さなパネルを定義する
まず、収集した動画が答えを探す助けになる問いを立てます。たとえば、「制作者が初心者向けの制作スキル2つをどう説明しているかを理解するには、どの公開動画を確認すればよいか」という問いです。
次に、元の検索クエリを書きます。後から付けるラベルやトピック分類とは分けておきます。そうすれば、収集元に何を返すよう求めたのかを、ほかの人も確認できます。
以下の学習用入力では、提案段階のクエリを2つ使います。これらは測定済みの検索語ではなく、購入者の需要を示す証拠でもありません。
{
  "queries": [
    "video lighting basics",
    "home audio recording"
  ],
  "maxResults": 6,
  "maxPagesPerQuery": 1,
  "searchDistribution": "balanced",
  "enableQueryExpansion": false
}この入力では、重複のない動画を最大6件保存するよう指定します。各クエリで続きのページを1ページまで取得でき、クエリを交互に処理します。クエリ拡張は無効なので、定義したパネルに含まれる元のクエリは2つです。この入力は公開スキーマで検証しましたが、実行はしていません。6件は上限であり、その件数を取得できるという約束ではありません。Chronometricaの入力スキーマ
動画形式のルールも重要です。`includeShorts`の既定値は`true`です。このため、設定を明示的に変更しない限り、このパネルには通常の動画とShortsの両方が含まれる可能性があります。動画指標の追加取得を含め、ほかのスキーマの既定値も適用されます。パネルの定義とともに、これらの既定値も記録してください。記録しないと、クエリの一覧だけを読んだ人が、収集対象を誤解する可能性があります。Chronometricaの入力スキーマ
Taskは、保存済みの入力プリセットです。公開されているYouTube検索結果をエクスポートするTaskを出発点にできます。収集前に、設定が書き留めたルールに合うか確認してください。プリセットは開始を助けますが、適切な入力を決めるのは、あらかじめ定めた問いです。
交互に収集する方式と順番に収集する方式を理解する
Chronometricaの`searchDistribution`には、`balanced`と`sequential`の2つの値があります。交互に処理する方式は、全体上限、収集元の制限、またはページ上限によって収集が止まるまで、クエリを交互に処理します。順番に処理する方式は、先に並んだクエリから優先して件数を埋めます。Chronometricaの入力スキーマ
共通の上限で収集が終わる前に、各クエリから動画を取得する機会を確保したい場合は、交互に処理する方式を選んでください。クエリの一覧が、1つの調査課題の複数の側面を表す場合に役立ちます。
交互に処理しても、保存件数が同じになるとは限りません。クエリごとに、利用できる候補の数が異なる場合があります。同じ動画が見つかる場合もあります。クエリが2つで上限が6件でも、各クエリから3件ずつ保存できるとは約束しないでください。
クエリの優先順位を調査設計に組み込む場合は、順番に処理する方式を選んでください。最も重要なクエリを先頭に置きます。後のクエリから動画を取得する前に、先のクエリが共通の上限枠をより多く使う可能性を受け入れる必要があります。
`resultsPerQuery`は、順番に処理するモードでのクエリごとの最大件数です。交互に処理するモードで各クエリに固定件数を割り当てるものとして説明しないでください。入力に追加する前に、現在のスキーマを確認してください。Chronometricaの入力スキーマ
これらの選択は、保存したリストの解釈に影響します。あるクエリから保存された動画が少ない理由は、収集ルール、重複、収集元の制限かもしれません。それだけでは、そのトピックに関連動画が少ない証拠にはなりません。
架空の重複例で考える
以下は、読者が手元で考えるための、架空の候補例です。Actorがそのまま出力したデータでも、実際に観測した収集順序でも、テスト結果でもありません。
クエリAの候補動画IDはV1、V2、V3です。クエリBの候補はV3、V4、V5です。
各クエリに候補が3件あるため、クエリと動画の検出記録は6件です。V3が両方のリストにあるため、重複しない動画IDは5件です。
重複する検出記録の数は、次のとおりです。
`6 encounters − 5 unique video IDs = 1 duplicate encounter`
重複部分には、V3という1つのIDが含まれます。全体上限を6件にしても、これらの候補リストに異なる動画が6件ある証拠にはなりません。リストにあるのは5件だけです。
ここで、残したV3の行に、取得元としてクエリAが記録されているとします。その行は、保存した情報源リストにV3が含まれる理由を説明する助けになります。しかし、クエリBでV3が見つかった別の検出記録は保持していません。
その検出を示す証拠がない限り、V3の2行目を追加しないでください。この架空の例では、違いが分かるように、両方の候補リストを示しています。実際の重複除去済みエクスポートだけでは、その証拠を得られない場合があります。
これは、クエリごとの取得件数を数える際に重要です。記録された取得元ごとに保存済みの行を数えると、その行については説明できます。しかし、各クエリで見つかったすべての候補を数えたことになるとは限りません。
重複を調べる際にも重要です。重複を除いたエクスポートだけから、収集元の2つの完全な検索結果集合の正確な重複を復元することはできません。手元のデータで裏付けられる内容を示してください。それは、保存した重複のない動画、それぞれに記録された文脈、既知の収集制限です。
情報源を確認するためのリストなら、それらが適切な単位である場合があります。重複の調査には、別々の検出記録を保持した証拠が必要です。
8段階の手順で収集する
- 問い、クエリ、動画形式を書きます。そのリストを何の判断に使うかを明示してください。元のクエリ文字列をそのまま調査記録にコピーします。パネルに通常の動画、Shorts、または両方を含めるか指定します。結果を見てから問いを変える場合は、必ず変更を記録してください。
- 収集上限を設定します。重複しない動画の全体件数上限、ページ上限、クエリの処理方式を選びます。条件を管理する最初のパネルでは、クエリ拡張を無効にしてください。自分で確認できる範囲に、その上限が合う理由を説明します。小さな上限は、保存したすべての行を確認し、収集範囲を広げる前に不適切なクエリを修正できる場合に役立ちます。
- Actor自体の入力スキーマを確認します。必要なルールをActorで指定できるか確かめてください。交互処理でのクエリ別固定割当、検索時の日付フィルター、過去の順位を自動追跡する機能があると、根拠なく想定しないでください。必要なルールに対応する入力が文書にない場合は、その不足を解決してから、パネルを適切な証拠として扱ってください。
- 少量のサンプルを収集し、その文脈を保持します。実行を参照できる情報、定義した設定、動画ID、公開URL、取得元クエリを残してください。Chronometricaでは、クエリ関連フィールドとともに、`postId`と`postUrl`が文書に記載されています。IDで動画を識別し、URLから公開情報源を開いて確認します。Chronometricaの公開仕様
- クエリ別集計と停止条件を確認します。各クエリから何件取得でき、何によって収集が終わったかを確かめてください。実行が完了していても、上限や収集元の制限によって終了している場合があります。保存件数を設定した上限と比較します。ただし、件数が上限未満でも、網羅できた証拠として扱わないでください。停止理由を結果とともに残します。
- 検出記録と、保存した重複のない動画を区別します。各件数は、実際の単位を使って説明してください。取得への寄与が明確でないクエリも、メモに残します。定義したパネルから、説明せずに取り除かないでください。欠損値は欠損値のまま保持します。不明な件数や指標を0に置き換えないでください。
- 分析前に関連性を確認します。保存した公開URLを開き、動画が問いに答えているか確認してください。1つの一貫したルールを使い、含めるかどうかの判断を記録します。あるクエリで主に無関係な内容が返るなら、変更を明示したうえでクエリを修正し、新しいパネル定義を作ります。クエリを変えた結果を、変更前と同じ説明のまま混ぜないでください。
- 繰り返し観測する場合は、設定を固定します。再度収集するなら、各実行を日付と設定とともに別々に保持してください。そうすれば、変化を調べやすくなります。1回の収集だけでは傾向を確認できません。保存した動画の変化も、上限、重複、クエリの処理順序、収集元の制限を踏まえて解釈する必要があります。
この手順で得られるのは、リンクの一覧だけではありません。収集ルール、識別可能な情報源、各行の意味を明確に説明する記録が残ります。検索結果を網羅したと主張しなくても、最初の確認に役立てるには十分です。
位置を示すフィールドは、その限界を踏まえて読む
Chronometricaの文書には、出力フィールドとして`pageIndex`と`pageRank`が記載されています。`pageRank`は、その検索結果ページ内だけの位置です。クエリ全体を通じた安定した位置ではありません。Chronometricaの公開仕様
返されたデータを説明するのに役立つ場合は、これらのフィールドを保持してください。ページ内の位置を、検証済みの全体順位として示さないでください。収集を繰り返しても、この限界はなくなりません。
取得できる動画やチャンネルの情報にも、同じ注意が必要です。収集元が返した値を残し、不明な値は不明のまま保持してください。指標が空欄でも、その動画に視聴などの活動がないことを示すわけではありません。
関連性を確認したら、情報源リストを次の問いに使えます。たとえば、選んだ動画がそれぞれどのような説明をしているかを比較できます。当社のYouTubeで不足しているトピックを見つける方法では、その次の段階を扱います。収集ツールの選択とは分けて考えてください。まず何を収集したかを確定し、その後に内容から何が分かるかを判断します。
出典と参考資料
著者 Chronometrica · 更新日
ページの先頭へ ↑