データ収集タスクを設定する
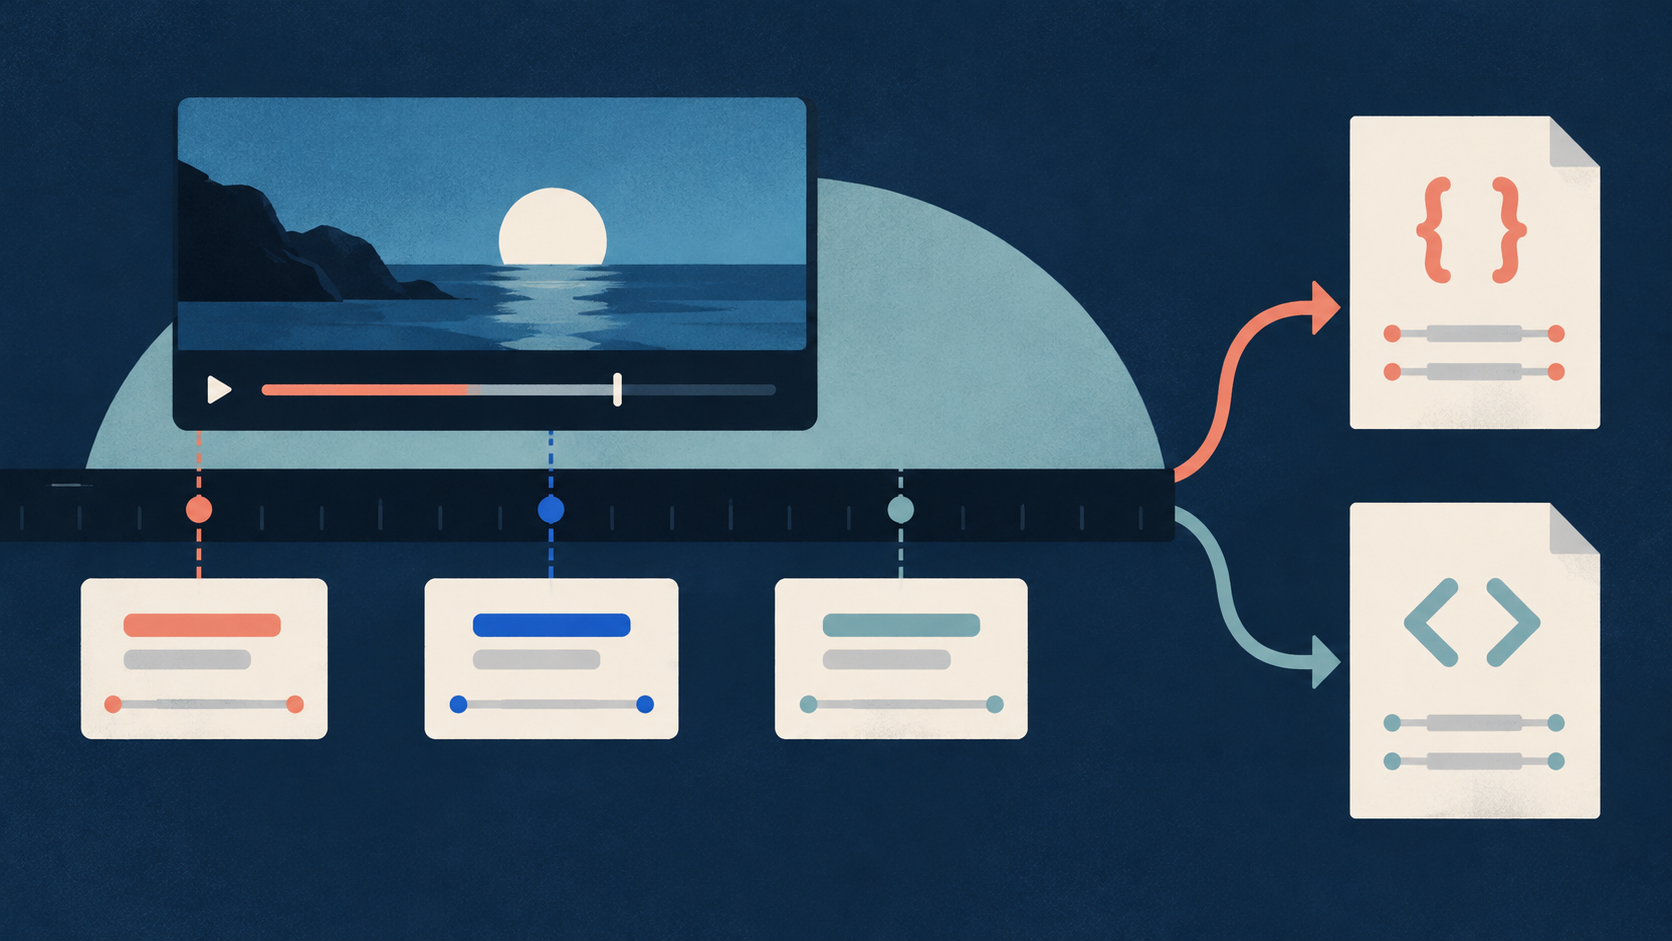
Actorは、ホスティング環境で動くデータ収集プログラムです。タスクは、入力設定を保存したものです。YouTube Transcriptの公開build0.1.43では、レビュー用に品質の整った記録を収集できるよう、タスク入力のJSONを更新します。startUrlsに保存されている三本のサンプル動画URLのリスト全体を置き換えます。原版を収集する実行には目的の原版動画のURLを一つだけ指定し、翻訳版を収集する別の実行には目的の翻訳版動画のURLを一つだけ指定します。それぞれのpreferredLanguagesには、その実行で使う言語コードを優先順に指定します。outputFormatsを[text,llm]から[json]に変更し、includeFailedInputDetailsはtrueのままにします。
JSON
{
  "startUrls": [
    "https://www.youtube.com/watch?v=dQw4w9WgXcQ"
  ],
  "preferredLanguages": [],
  "outputFormats": ["json"],
  "includeFailedInputDetails": true
}要求した言語がどれも存在しない場合、preferredLanguagesは別の言語を黙って選択せず、LANGUAGE_UNAVAILABLEを返します。preferredLanguagesを空にすると、利用可能な中で最適な字幕トラックを使います。読者が手作業で作成した文字起こしは、出所を別に記録します。このActorは、翻訳、吹き替え、音声の文字起こし、話者の識別、音声からの字幕作成、対応する動画の検索、自動での対応付けを行いません。
Actorは、読者が使用するために必要なフィールドとして、videoId、videoUrl、transcriptLanguageCode、transcriptLanguageName、requestedLanguageCodes、availableLanguageCodes、languageMatch、isAutoGenerated、status、segmentsをそのまま返します。公開されているセグメントのキーは、startSeconds、endSeconds、durationSeconds、textです。返されたendSecondsと、長さがnullの場合のその値を保持します。
OUTPUTの集計フィールドは、inputsReceived、uniqueVideosPlanned、rowsWritten、successfulTranscriptRows、failedInputs、duplicateVideosSkipped、statusCounts、errorCodeCounts、failedInputDetailsです。rowsWrittenとsuccessfulTranscriptRowsは、正常に取得できた文字起こしの行数を数えます。保存された失敗詳細の行数は数えません。statusCountsには、処理済みの入力のうち失敗したものの結果も含まれます。
現在の英語・手動字幕を使った正常系の対照テストでは、取得元の字幕テキスト、時間情報、言語に関するデータ構造を確認しています。特定の翻訳版チャンネル、イタリア語やスペイン語のトラックが利用可能かどうか、2言語間の翻訳の正確さ、音声品質を保証するものではありません。読者が作成する各alignmentUnitIdには、両方のvideoUrlの値、それぞれ独立した開始・終了の時間範囲、対応付けの理由を保持する必要があります。意味単位のIDはActorの出力ではありません。
意味のレビューを完了する手順
- 既知の2つのURLが、同じ内容の正しい原版と翻訳版を指していることを手作業で確認します。動画の識別情報、言語トラック、各動画の時間情報を確認します。タイトルやサムネイルが一致するだけでは不十分です。
- 公開仕様に従って、利用可能な字幕トラックを収集します。取得元の言語情報と、手動字幕か自動字幕かを示すフラグを別々に保存します。実際に聞こえる言語を確認します。翻訳先言語のトラックがない場合、原語トラックを翻訳先の列に無理に入れてはいけません。
- レビューする箇所について、各動画の音声と字幕の語句を照合します。字幕に不確かな箇所があれば、「caption word uncertain」と記録し、まず取得元を確認します。取得元の字幕に誤りがあっても、それだけで翻訳の誤りとはいえません。
- 意味単位を、条件を含めた1つの完結した指示として定義します。原版の意味単位と翻訳版のセグメントは、実際の内容に基づいて対応付けます。配列の同じ位置にある要素同士を組み合わせたり、開始時刻が同じという理由で対応付けたりしてはいけません。対応が見つからない箇所は、推測で組み合わせず、未対応のままにします。
- 両言語を照合するための短いチェックリストを使います。誰が何をするか、否定、必要な順序や条件、数値と単位、専門用語、限定条件を確認します。翻訳先の文が自然でも、条件が逆になっていたり、数量が変わっていたりすることがあります。
- 対応付けた各意味単位に、「meaning supported」「meaning changed」「caption word uncertain」「alignment uncertain」「unavailable」のいずれかの限定的な判定を記録します。翻訳版にしかない箇所と原版にしかない箇所は、別々のリストに記録します。意味が変わっている単位については、どの指示が変わったかと、必要な修正を記載します。
- 声の自然さ、感情、話者を識別できるかどうか、吹き替えの話すリズム、音質は、この字幕を根拠とする意味の確認の対象外とします。これらには、別の音声レビュー基準が必要です。
- 対応付けた台帳に、原文、翻訳文、確認した音声の時間、判定、修正メモを記載して提出します。レビュー済みの意味単位と未対応の意味単位は、分けて報告します。
台帳の記入例と判定の手順(独自に作成した架空の例)
この確認用の小さなテストケースに含まれる動画、字幕、判定は、すべて独自に作成した架空のものです。バイリンガルのレビュアーが、話された箇所を字幕と照合したという設定ですが、実際の音声を使ったテストは行っていません。
| 意味単位ID | 原版の時間範囲 | 原版の文言 | 翻訳版の時間範囲 | 翻訳版の文言 | 判定 | 修正メモ |
|---|---|---|---|---|---|---|
| U1 | 0-4秒 | 緑のランプが点灯するまで、12ミリリットルを加えないでください。 | 3-8秒 | ランプが消えている間に、21ミリリットルを加えてください。 | meaning changed | 否定、条件、12ミリリットルという数量を元に戻します。 |
| U2 | 5-8秒 | ふたを2分間閉めたままにしてください。 | 9-13秒 | ふたを二分間閉めたままにしてください。 | meaning supported | 修正は不要です。 |
翻訳版の後半にある締めくくり部分には、レビューした原版の時間範囲内に対応する箇所がありません。誤訳とはせず、未対応のままにします。この2つの意味単位の確認結果は、意味を確認できた単位が1つ、意味が変わっている単位が1つです。これに加えて、翻訳版に未対応の箇所が1つあります。
出典と参考資料
著者 Chronometrica · 更新日
ページの先頭へ ↑