Des personnes demandent quelle source d'offres donne les données les plus complètes. Cette question montre un besoin de comparer des sources. Elle ne désigne pas un gagnant. Elle ne montre pas la taille du marché. La question publique est sur Reddit.
Un Actor est un programme hébergé qui collecte des données. Une Task est un préréglage d'entrée enregistré pour un Actor. L'Actor enregistre les lignes de la source. Vous faites la comparaison vous-même. La Task ne compare pas les sources à votre place. Cette méthode ne classe pas les sources pour chaque utilisateur. Elle ne note pas la rémunération. Elle ne classe pas les outils selon le coût.
Une exécution est une collecte avec une seule entrée. Une ligne brute est une annonce enregistrée avant revue. Un identifiant source est le numéro d'annonce de cette source. Une annonce utile correspond à votre métier, à votre marché et à votre fenêtre, et elle a un identifiant source connu. Un doublon est la même annonce enregistrée plus d'une fois. Une republication est le même poste à pourvoir publié de nouveau. Une opportunité est un poste à pourvoir après que vous avez regroupé les doublons et les republications. La couverture des champs est la fréquence à laquelle un champ nécessaire est présent dans les annonces utiles. La couverture du marché est l'ensemble des postes à pourvoir que le test a collectés. Ce sont des faits différents.
Menez huit actions
- Écrivez la décision et les champs dont vous avez besoin.
Écrivez le choix que vous devez faire. Pour une recherche publique sur le marché de l'emploi, vous avez souvent besoin de quatre faits. Vous avez besoin du nom de la source, du métier, du lieu et d'une description utilisable. Déclarez le métier. Déclarez le marché. Déclarez la langue. Déclarez la fenêtre de publication. Déclarez la date et l'heure auxquelles vous collectez les lignes. Déclarez la règle d'inclusion. La règle d'inclusion dit quelles lignes comptent comme le métier que vous voulez.
Choisissez deux sources pour le petit test. Ne supposez pas qu'elles listent les mêmes postes à pourvoir. Un lot est un métier, un marché, une fenêtre et une source. Utilisez les mêmes règles de lot sur les deux sources. Si le métier ou la fenêtre change, les fichiers répondent à des questions différentes. Vous ne pouvez pas les comparer de façon équitable.
La Task LinkedIn hiring-trends actuelle est un large échantillon. Ce n'est pas votre lot de comparaison. Ses mots de recherche sont trois métiers sur des lignes séparées : software engineer, data analyst et product manager. Sa liste startUrls est vide. startUrls est une liste facultative de pages à ouvrir. saveOnlyUniqueItems vaut true. Ce réglage conserve une seule copie d'une annonce répétée dans l'enregistrement. Remplacez les trois métiers par un métier que vous déclarez. Ajoutez un lieu correspondant et une fenêtre. Laissez startUrls vide. Ce parcours est une recherche par mots-clés. Ne remplacez pas les mots de recherche par des adresses connues de pages d'offres.
- Fixez des budgets et des filtres que vous pouvez comparer.
Écrivez les mots de recherche, la limite de pages et le plafond de lignes pour chaque source. Un plafond est le nombre maximal de lignes que vous laissez cette exécution enregistrer. Un plafond limite ce que vous pouvez voir. Ce n'est pas le nombre d'offres sur le marché. Si une source atteint son plafond et que l'autre s'arrête plus tôt, les nombres bruts de lignes ne sont pas des preuves égales. La source plafonnée peut contenir plus d'offres correspondantes que vous n'en avez enregistrées. Notez l'entrée qui a réellement été exécutée. Notez pourquoi chaque exécution s'est arrêtée.
Utilisez les noms d'entrée vérifiés le 13 octobre 2026. Une page publique plus récente peut les changer. Lisez les noms actuels avant de vous fier à une ancienne liste.
La build publique 0.2.19 du LinkedIn Jobs Actor prend en charge searchTerm, location, postedWithin, maxItems, maxPagesPerSearch, saveOnlyUniqueItems et fetchJobDetails. Elle prend aussi en charge les autres filtres de sa liste d'entrée actuelle. fetchJobDetails à true indique à l'exécution d'essayer d'enregistrer le texte complet de l'offre. Un petit exemple LinkedIn peut utiliser le métier software engineer, un marché, postedWithin à any, maxItems à 3 et maxPagesPerSearch à 1. Réglez aussi saveOnlyUniqueItems à true et fetchJobDetails à true. La valeur any n'est correcte que lorsque votre fenêtre déclarée est toute la plage que ce contrôle désigne.
La Task Indeed Jobs correspond à la build publique 1.2.14 d'Indeed Jobs. Cette build prend en charge searchTerm, country, location, maxItems, maxPagesPerSearch, postedWithinDays et saveOnlyUniqueItems. Elle prend aussi en charge ses filtres facultatifs actuels. Utilisez un pays, un lieu et un métier qui correspondent. Ne fixez pas un salaire minimum supérieur à zéro. Un filtre de rémunération masque des annonces. Cela change le nombre de lignes retenu pour la couverture. Un petit exemple Indeed peut utiliser maxItems à 2, maxPagesPerSearch à 1 et saveOnlyUniqueItems à true.
L'exemple à 3 lignes et l'exemple à 2 lignes ne forment pas une paire appariée de budgets. Ils montrent seulement qu'une exécution minuscule est une entrée valide. Pour la comparaison, fixez le même maxItems sur les deux sources. Fixez le même maxPagesPerSearch sur les deux sources. Si une source ne peut pas accepter ce nombre, écrivez la différence.
LinkedIn utilise postedWithin. Indeed utilise postedWithinDays. Ces contrôles ne sont pas la même entrée. Choisissez, sur chaque source, la valeur autorisée la plus proche de votre fenêtre déclarée. Si les fenêtres diffèrent encore, écrivez l'écart. N'appelez pas les échantillons égaux.
Indeed a une entrée country. Les entrées LinkedIn vérifiées utilisent location, pas un champ country distinct. Réglez country et location d'Indeed sur le même marché déclaré que vous mettez dans location de LinkedIn. Si les contrôles de lieu diffèrent encore, écrivez la différence.
Ce bloc LinkedIn est un petit exemple de structure d'entrée. Remplacez le jeton de marché. Remplacez le métier si vous en avez déclaré un autre. SET_YOUR_MARKET est un rappel, pas un lieu réel.
{
  "searchTerm": "software engineer",
  "location": "SET_YOUR_MARKET",
  "postedWithin": "any",
  "maxItems": 3,
  "maxPagesPerSearch": 1,
  "saveOnlyUniqueItems": true,
  "fetchJobDetails": true,
  "startUrls": []
}Ce bloc Indeed est un petit exemple de structure d'entrée. SET_THE_CLOSEST_ALLOWED_VALUE est un rappel, pas un vrai réglage Indeed. Mettez-y la valeur en jours autorisée la plus proche. N'ajoutez pas de salaire minimum.
{
  "searchTerm": "software engineer",
  "country": "SET_YOUR_COUNTRY",
  "location": "SET_YOUR_MARKET",
  "postedWithinDays": "SET_THE_CLOSEST_ALLOWED_VALUE",
  "maxItems": 2,
  "maxPagesPerSearch": 1,
  "saveOnlyUniqueItems": true
}Des exécutions vérifiées de ces contrôles ont enregistré quatre sortes de valeurs. Elles ont enregistré des identifiants d'annonces de source qui n'étaient pas vides. Elles ont enregistré des adresses de pages de source. Elles ont enregistré des heures de collecte. Elles ont enregistré des descriptions complètes. Ces exécutions ont utilisé des lieux différents et des fenêtres différentes. Les deux se sont arrêtées à de petits plafonds de lignes. Cette vérification montre que les Actors peuvent enregistrer ces champs sur ces entrées. Ce n'est pas un test apparié. Ce n'est pas un classement. Aucune vraie paire d'offres partagée n'a été vérifiée. Aucun nombre de couverture complète n'a été vérifié. Réutilisez ces mêmes contrats d'entrée pour votre propre lot apparié.
- Collectez chaque source, puis triez les lignes.
Triez chaque ligne enregistrée dans un seul groupe avant de comparer les sources. Gardez ces groupes séparés.
- Lignes utiles.
- Lignes hors du métier, du marché ou de la fenêtre.
- Doublons à l'intérieur d'un fichier enregistré.
- Lignes sans identifiant source.
- Requêtes bloquées ou en échec.
- Recherches qui ont atteint le plafond.
Rendez compte de chaque entrée que vous aviez prévu d'exécuter. Une exécution refusée peut renvoyer zéro ligne. Ce zéro ne prouve pas qu'aucune offre n'existe. Gardez un échec distinct d'un vrai résultat vide. Si vous ne connaissez pas un nombre, laissez-le inconnu. N'écrivez pas zéro à sa place. Confondre ces deux sortes de résultat peut faire croire qu'une source bloquée ne contient aucune offre.
- Utilisez la même règle sur les deux échantillons.
Lisez le métier, le lieu et la fenêtre de la même façon pour chaque ligne. Le texte de description complet peut trancher un cas difficile. Un titre seul peut être trop vague. descriptionStatus à full signifie que la description complète a été enregistrée. Cela ne signifie pas que vous avez inventé une étiquette de texte court.
Si une date manque et que votre règle exige une date, laissez cette ligne non tranchée. Si le marché manque et que votre règle exige un marché, laissez cette ligne non tranchée. Le marché que vous avez envoyé ne prouve pas que chaque annonce est dans ce lieu. Le texte de l'annonce peut nommer un autre lieu.
Associez les colonnes volontairement. Chaque source utilise ses propres noms de champs. Conservez ces noms d'origine dans l'enregistrement brut. Remplissez les colonnes de comparaison à partir d'eux. Une URL est l'adresse de page d'une annonce.
| Colonne de comparaison | Ce que vous stockez |
|---|---|
| source et identifiant d'offre | Nom de la source plus son propre identifiant d'annonce |
| title | Texte du titre du poste |
| companyName | Nom de l'employeur |
| locationRaw | Texte du lieu tel qu'enregistré |
| jobUrl | Adresse de la page de l'annonce |
| descriptionText | Mots de la description |
| descriptionStatus | Si la description est complète |
| scrapedAt | Heure à laquelle vous avez collecté la ligne |
| query | Mots de recherche que vous avez envoyés |
| searchLocation | Marché que vous avez envoyé |
| contexte d'exécution | Entrée que vous avez exécutée et pourquoi elle s'est arrêtée |
Écrivez le champ source d'origine à côté de chaque colonne. Ne renommez pas les champs bruts pour les faire disparaître. postedAt de LinkedIn peut être calculé à partir d'une expression de temps relatif. Une expression de temps relatif dit depuis combien de temps la publication est apparue. Cette valeur n'est pas une preuve exacte de l'heure de publication. Les valeurs de temps d'Indeed conservent le sens que cette source énonce. postedWithinDays conserve aussi ce sens de source. Des champs facultatifs peuvent manquer. Des identifiants d'annonce peuvent manquer. Un nombre de lignes ne prouve pas que vous avez trouvé chaque poste à pourvoir. Un nombre de lignes ne prouve pas qu'une offre est authentique.
- Comparez les opportunités revues, pas les chiffres bruts des identifiants.
Regroupez les doublons et les republications d'abord à l'intérieur de chaque source. Ensuite, examinez les correspondances possibles entre les deux sources. Utilisez ces groupes revus pour la comparaison. Ne comptez pas deux enregistrements d'un poste à pourvoir comme deux postes à pourvoir.
Un identifiant source n'est unique qu'à l'intérieur de l'espace de noms de cette source. Un espace de noms est l'ensemble propre d'identifiants de cette source. Ne joignez jamais un identifiant d'offre LinkedIn à un identifiant d'offre Indeed parce que les chiffres correspondent. Les mêmes chiffres peuvent appartenir à des annonces différentes.
Conservez les deux URL de source pour chaque paire. Une URL de source est l'adresse de page de cette annonce. Conservez l'URL LinkedIn et l'URL Indeed. Ne remplacez pas une URL par l'autre.
Comparez l'employeur. Comparez le métier. Un métier est le travail que l'annonce demande à une personne de faire, pas seulement la ligne de titre. Comparez le lieu. Comparez la référence de recrutement disponible. Une référence de recrutement est le numéro de poste à pourvoir de l'employeur lorsque l'annonce en montre un. Comparez le libellé complet. Comparez le contexte de l'heure d'observation. L'heure d'observation est le moment où vous avez vu l'annonce. Le contexte est ce que cette annonce disait à ce moment.
Confirmez une paire seulement lorsque ces faits concordent. Conservez les deux URL sur chaque paire confirmée.
Un titre seul n'est pas une confirmation. Un identifiant seul n'est pas une confirmation. Le même employeur et un titre semblable exigent encore cette revue. Ils ne sont pas une correspondance automatique.
Une paire faible reste incertaine. Une paire contradictoire reste incertaine. Une paire faible a des faits manquants ou seulement une partie des mêmes faits. Une paire contradictoire a des faits qui ne concordent pas. Des références de recrutement différentes ne concordent pas. Un libellé qui décrit un poste à pourvoir différent ne concorde pas. Des heures d'observation qui montrent deux postes à pourvoir différents ne concordent pas. Gardez les paires incertaines hors du recouvrement confirmé.
- Construisez les ensembles confirmés et comptez quatre groupes.
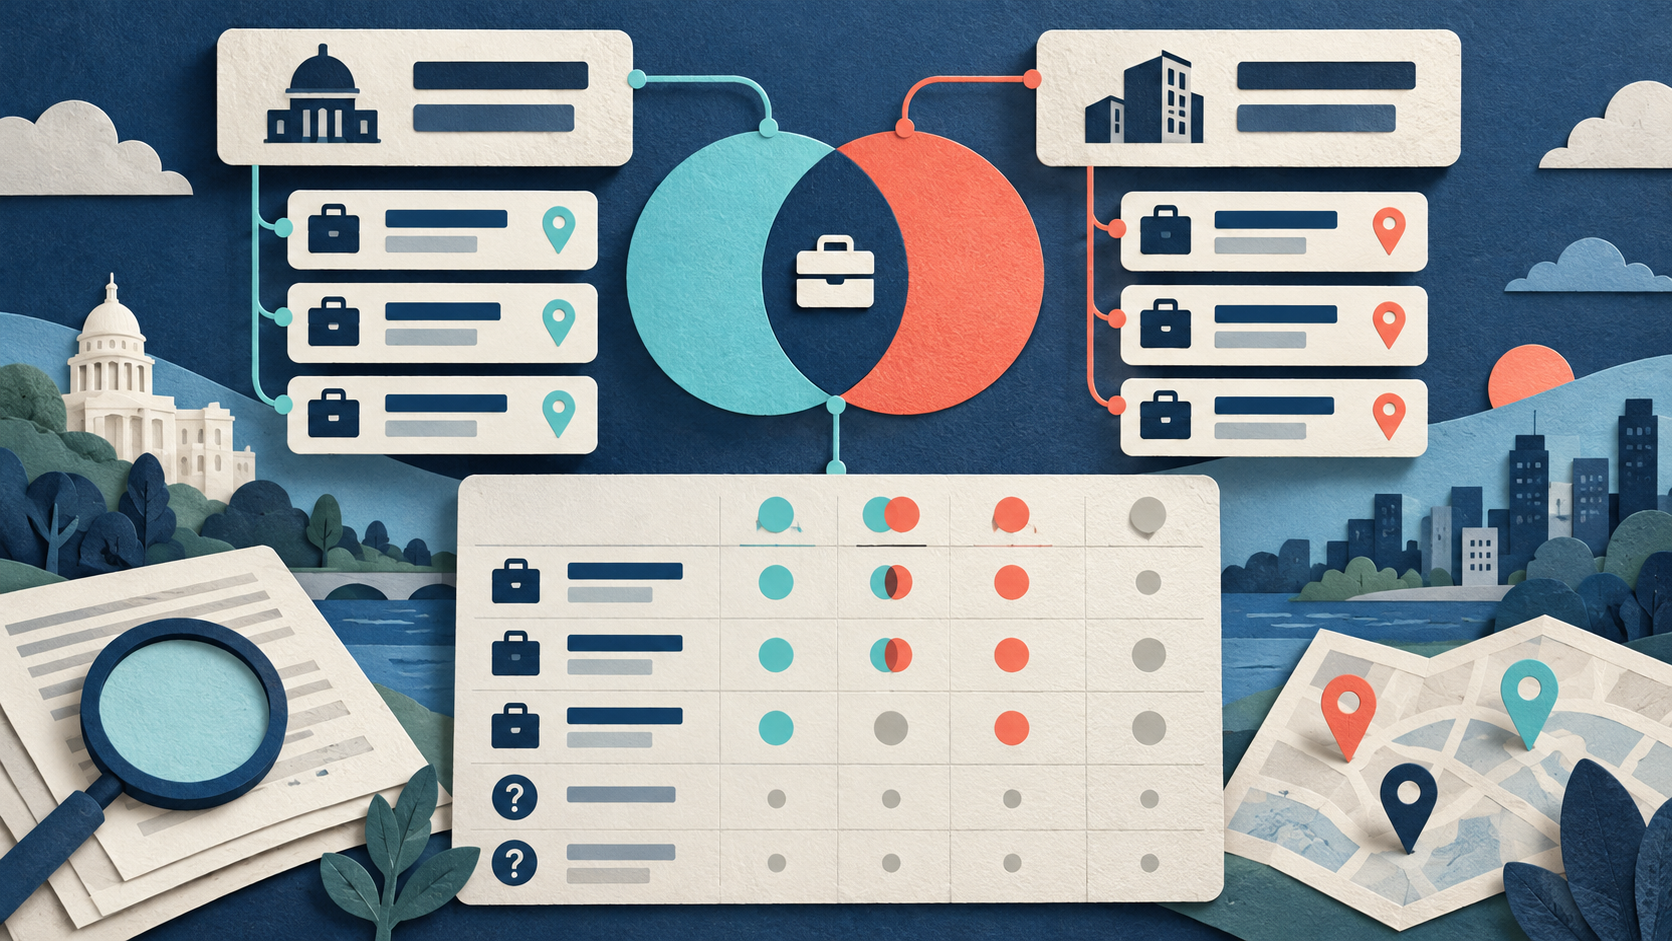
Appelez A l'ensemble des opportunités utiles confirmées de la première source. Appelez B l'ensemble de la seconde source. Comptez quatre groupes. L'union est chaque opportunité confirmée dans le test collecté. L'intersection est le recouvrement que vous avez confirmé. Les opportunités seulement A apparaissent dans A et pas dans B. Les opportunités seulement B apparaissent dans B et pas dans A. Signalez les correspondances incertaines par un nombre à part. Ne les forcez pas dans l'intersection.
L'union couvre seulement le test collecté. Ce n'est pas chaque poste ouvert sur ce marché. N'utilisez pas la capture-recapture sur ces nombres. La capture-recapture estime une population entière à partir du recouvrement de deux échantillons. Elle exige des échantillons aléatoires. Elle exige des échantillons séparés. Ces sources ne sont pas des échantillons aléatoires. La même offre peut apparaître sur les deux pour des raisons que vous n'avez pas mesurées. Signalez les quatre nombres. Ne les transformez pas en un total pour tout le marché.
- Comparez les champs nécessaires à l'intérieur de chaque échantillon utile.
Divisez le nombre de descriptions complètes par le nombre d'annonces utiles qui ont un identifiant source connu. Cette part est la couverture des champs pour les descriptions. Indiquez à part le nombre d'identifiants source manquants. Ne les supprimez pas, puis ne parlez pas comme si chaque ligne enregistrée était utile. Un identifiant manquant peut encore être une vraie ligne. C'est une ligne faible pour l'appariement.
La couverture des champs n'est pas la couverture du marché. Une source peut ajouter peu de nouvelles opportunités et compter encore. Elle compte lorsqu'elle fournit un champ que vous exigez. Ne conservez des nombres de coût que lorsque vous les avez mesurés. Ne conservez des nombres d'effort que lorsque vous les avez mesurés. N'inventez pas, sans mesure, la source la moins chère. N'inventez pas, sans mesure, la meilleure source.
- Choisissez la combinaison de sources pour cette décision seulement.
Choisissez à partir des nouvelles opportunités confirmées et des champs requis. Une source qui ajoute peu peut rester dans la combinaison de sources. Gardez-la lorsque ses lignes fournissent un champ que vous ne pouvez pas obtenir de l'autre source. Si la collecte a échoué, répétez le même lot déclaré. Si l'incertitude est trop grande pour décider, répétez le même lot. Ne répétez pas seulement pour augmenter le nombre de lignes. Plus de lignes ne réparent pas une exécution bloquée. Plus de lignes ne réparent pas une correspondance floue. N'appelez pas une source la meilleure pour tous les métiers et tous les marchés.
Déroulez un test apparié fictif
Les nombres de cette section sont une fiction. Ils enseignent l'arithmétique. Ils ne sont pas un résultat de produit. Ils ne sont pas les exécutions vérifiées ci-dessus. Source A et Source B sont seulement des étiquettes. Cette fiction ne dit pas quelle étiquette est LinkedIn. Cette fiction ne dit pas quelle étiquette est Indeed. J1 à J8 sont des étiquettes d'opportunités. Ce ne sont pas des identifiants source.
Dans cette fiction, les deux lots utilisent le même métier, le même marché et la même fenêtre. La source A enregistre 8 lignes brutes. La source B enregistre 7 lignes brutes. La revue laisse 6 annonces utiles à identifiant source connu dans A. La revue laisse 5 annonces utiles à identifiant source connu dans B. La baisse rend compte ensemble des lignes non pertinentes et des lignes en doublon. Cette fiction ne sépare pas ces deux raisons. N'inventez pas la séparation. Les identifiants source manquants ne sont pas indiqués. Laissez-les inconnus. Ne les remplissez pas avec zéro.
| Mesure | Source A | Source B |
|---|---|---|
| Lignes brutes | 8 | 7 |
| Annonces utiles avec un identifiant source connu | 6 | 5 |
| Part des lignes brutes qui sont utiles | 6/8 = 75 pour cent | 5/7 = 71,4 pour cent |
| Descriptions complètes sur les annonces utiles | 5 sur 6 = 83,3 pour cent | 4 sur 5 = 80 pour cent |
| Arrêt | A atteint son plafond | S'est arrêtée avant son plafond |
| Correspondances non tranchées | aucune dans cette fiction | aucune dans cette fiction |
| Identifiants source manquants | non indiqué | non indiqué |
| Répartition des lignes brutes non utilisées | non indiqué | non indiqué |
Les parts de 75 pour cent et de 71,4 pour cent utilisent la règle de cette fiction. Ce ne sont pas des scores d'exactitude pour une source. Divisez 6 par 8 pour obtenir 75 pour cent. Divisez 5 par 7 pour obtenir 71,4 pour cent.
Les ensembles revus sont :
- A = {J1, J2, J3, J4, J5, J6}
- B = {J4, J5, J6, J7, J8}
| Opportunité | Dans A | Dans B | Groupe |
|---|---|---|---|
| J1 | oui | non | seulement A |
| J2 | oui | non | seulement A |
| J3 | oui | non | seulement A |
| J4 | oui | oui | les deux |
| J5 | oui | oui | les deux |
| J6 | oui | oui | les deux |
| J7 | non | oui | seulement B |
| J8 | non | oui | seulement B |
L'intersection est {J4, J5, J6}. Le nombre est 3. L'union est {J1, J2, J3, J4, J5, J6, J7, J8}. Le nombre est 8. Seulement A est {J1, J2, J3}. Le nombre est 3. Seulement B est {J7, J8}. Le nombre est 2. Chaque correspondance incluse dans cette fiction est tranchée. Aucune paire ne reste dans un groupe incertain.
Ajouter B à A ajoute 2 opportunités confirmées. Deux parts décrivent cet ajout. Elles répondent à des questions différentes. Utilisez la part qui correspond à votre question.
- Nouvelles opportunités divisées par les six de A : 2/6 = 33,3 pour cent. Utilisez cette part lorsque vous demandez combien B ajoute à A.
- Opportunités seulement B divisées par l'union de huit : 2/8 = 25 pour cent. Utilisez cette part lorsque vous demandez quelle partie de l'union collectée vient seulement de B.
N'échangez pas ces parts. La première part utilise l'ensemble utile de A comme base. La seconde part utilise l'union collectée comme base.
La source A a des descriptions complètes sur 5 des 6 annonces utiles. Divisez 5 par 6 pour obtenir 83,3 pour cent. La source B a des descriptions complètes sur 4 des 5 annonces utiles. Divisez 4 par 5 pour obtenir 80 pour cent. Ce sont des taux de couverture de champ dans les annonces utiles. Ils ne mesurent pas la couverture de tout le marché.
Dans cette fiction, A a atteint son plafond. B s'est arrêtée avant son plafond. Aucun des deux ensembles n'est le nombre complet des offres ouvertes. Le nombre d'opportunités seulement A peut augmenter si une exécution ultérieure utilise un plafond plus haut et les mêmes règles. Le choix fictif peut être A comme source principale, plus B pour les 2 opportunités ajoutées. Ce choix ne convient qu'à ce test déclaré. Ce n'est pas un classement universel. Montrez les champs, les ensembles, les arrêts et les nombres inconnus.
Les dates de publication ne sont pas données dans cette fiction. Une date vide n'est pas le jour zéro. Si votre règle de fenêtre exige une date, cette ligne reste non tranchée. Cette fiction n'a pas cette ligne non tranchée. Avant de choisir, comptez à part les vraies paires incertaines.
Sources et lectures complémentaires
Par Chronometrica · Mis à jour
Retour en haut ↑