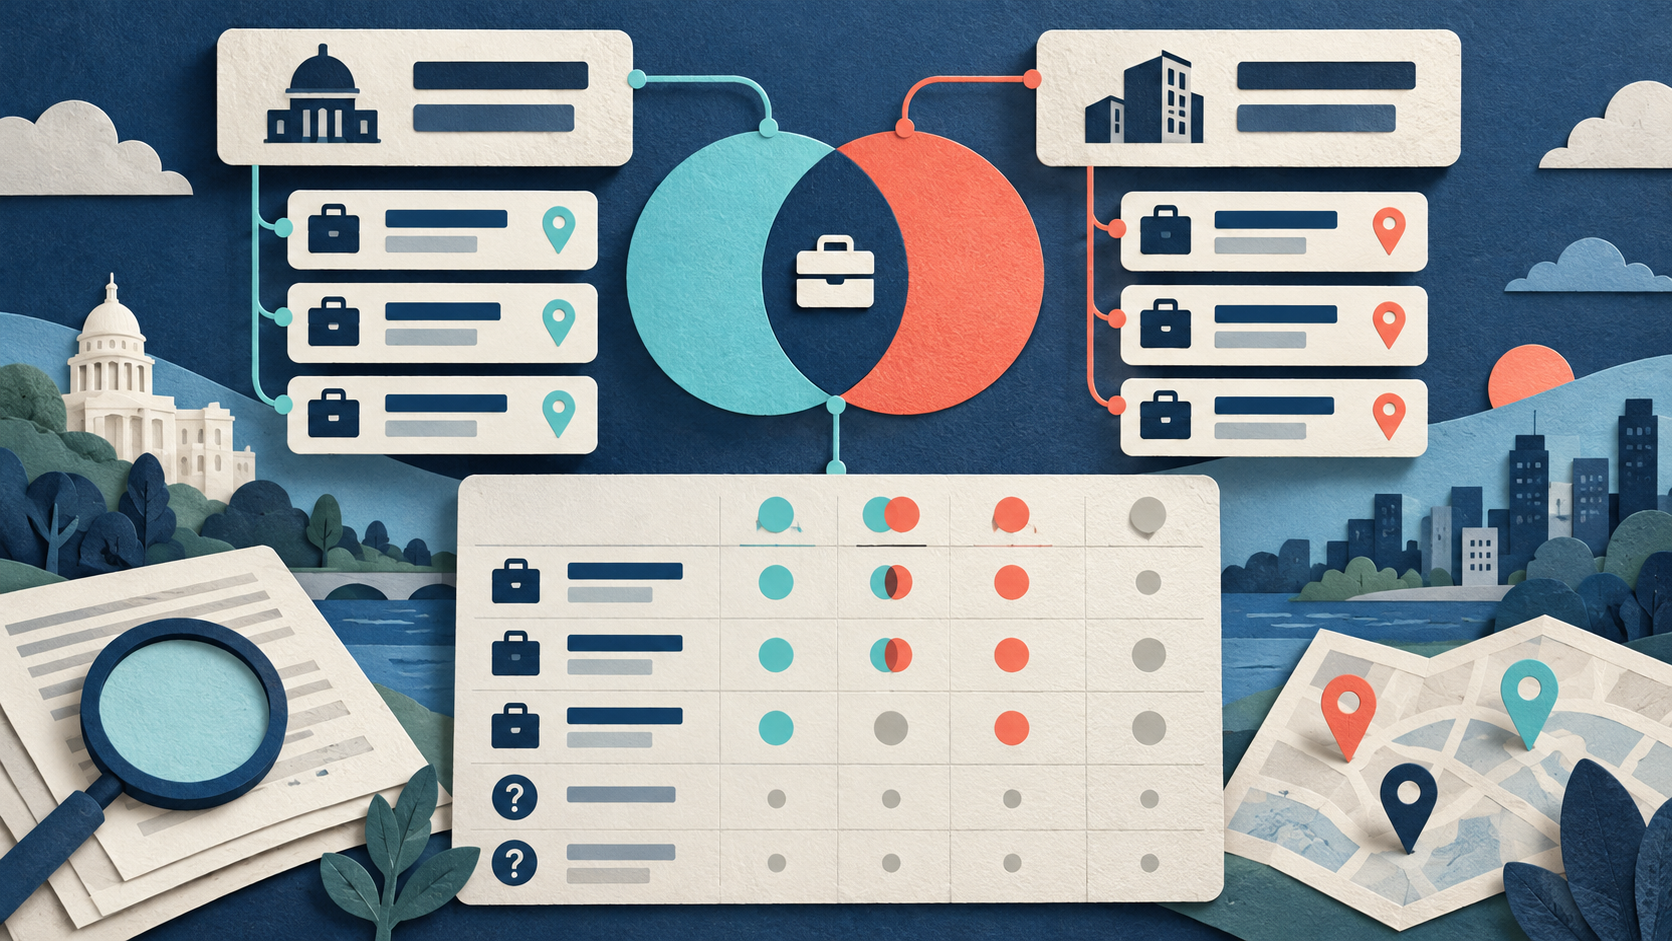
Distinctions et définitions essentielles
Une annonce est une publication diffusée sur un site d'emploi précis. Un poste vacant est un poste sous-jacent à pourvoir chez l'employeur, dans le monde réel. Une observation est une lecture unique des données, capturée au moment de la collecte. Une copie exacte est exactement la même observation importée deux fois dans votre fichier.
Une clé source combine la source de la plateforme et l'identifiant de l'annonce, par exemple `linkedin:L101`. Conservez les identifiants d'emploi strictement comme du texte. Une référence employeur est un code d'emploi fourni par l'employeur, visible publiquement dans la description du poste ou sur la page employeur lorsqu'elle est disponible. Les employeurs peuvent réutiliser ces codes publics. Un groupe de revue contient des correspondances possibles avec les raisons enregistrées. Les groupes sont des correspondances possibles, pas des postes vacants confirmés.
Un Actor est un programme hébergé de collecte de données.
Les sites d'emploi traitent les publications de façons différentes. LinkedIn traite la républication d'un emploi clos, expiré ou modifié comme une nouvelle instance de publication, comme le décrit le guide de republication LinkedIn. Cette politique ne prouve pas un changement universel d'identifiant ni une intention d'embauche de l'employeur. Indeed distingue les publications en double des rôles rouverts, comme l'indiquent les règles d'intégrité des publications Indeed. Ces règles ne prouvent pas que les annonces répétées collectées sont non conformes. Les règles de données structurées de Google définissent les identifiants d'emploi de l'employeur et autorisent plusieurs lieux, comme le détaille la documentation Google sur les offres d'emploi. Le contrat Actor vérifié, et non les règles Google, définit comment `jobId` identifie les publications des sites.
Les analystes de l'emploi utilisent ces règles lorsqu'ils combinent des exports. Les lecteurs demandent si les rôles republiés plusieurs fois sur LinkedIn sont de vrais postes vacants, comme dans une question sur la republication d'emplois LinkedIn. Des recherches externes suivent les publications brutes, distinctes et répétées, comme le montre une analyse d'un jeu de données Indeed. Ces totaux sont un contexte externe non vérifié. Les extracteurs publics capturent des enregistrements bruts dans des jeux de données, comme l'explique le guide des jeux de données Apify. Les analystes utilisent ces outils pour collecter des lignes, retirer les doublons exacts et regrouper les republications possibles.
Configuration de la Task et de la collecte
Une Task est une configuration de départ enregistrée pour un Actor. Une Task collecte des données. Elle ne classe pas les republications et ne planifie pas les exécutions. La Task Exporter les emplois LinkedIn vers CSV ou Excel utilise l'Actor LinkedIn. La configuration par défaut demande 25 emplois. La Task Jeu de données de preuves d'emplois republiés Indeed utilise l'Actor Indeed. Son préréglage demande 500 emplois sur 15 pages. Les deux outils collectent des données publiques sans cookies de connexion utilisateur.
Ajustez les réglages avant de collecter un échantillon de test. Définissez votre requête de recherche. Réglez `maxItems` sur 3. Réglez `maxPagesPerSearch` sur 1. Laissez `saveOnlyUniqueItems` réglé sur true. Réglez `fetchJobDetails` sur true sur LinkedIn pour collecter les descriptions complètes. Contrôlez `descriptionStatus` sur les enregistrements renvoyés. Les extraits ne peuvent pas établir une correspondance de texte complet.
Le réglage `saveOnlyUniqueItems` retire les annonces répétées au sein d'une seule exécution. Il ne regroupe pas les annonces entre les exécutions et ne fait pas correspondre les postes vacants. Le réglage `maxItems` agit comme un plafond partagé de lignes enregistrées. Examinez le résumé OUTPUT après une exécution. Contrôlez `jobsSaved`, `duplicatesSkipped`, `candidateItemsSeen` et `stopReason`. Soustraire les emplois enregistrés des éléments candidats n'égale pas automatiquement le nombre de doublons.
L'extracteur renvoie `scrapedAt` comme horodatage de collecte. Il renvoie `postedAtRaw` comme texte de date source d'origine ou comme libellé d'âge relatif. Il renvoie `postedAt` en analysant les dates source exactes ou en dérivant un horodatage d'un texte relatif comme « 6 days ago ». Préservez la précision de la source et conservez les deux champs. Une valeur dérivée n'est pas une heure de publication exacte. Les réviseurs dérivent les valeurs `firstSeen` et `lastSeen` des observations conservées réussies, et non d'un historique récupéré intégré. Les lacunes de collecte ne prouvent pas la clôture d'un emploi, sa réouverture ni un poste pourvu.
Méthode en 10 étapes pour les analystes
- Conservez les exports bruts. Enregistrez un export source inchangé avant de modifier les données. Ajoutez les noms de fichiers d'import et les numéros de ligne dans votre copie de travail afin de retrouver les enregistrements source d'origine.
- Formez la clé d'annonce. Combinez le nom de la source et l'identifiant d'emploi textuel, par exemple `linkedin:L101`. Conservez les identifiants comme du texte. Ne joignez pas des identifiants nus entre les sites et ne fusionnez pas des identifiants vides.
- Trouvez les observations copiées. Trouvez les copies exactes en comparant la clé source, `scrapedAt` et toutes les valeurs source conservées. Excluez les noms de fichiers d'import, les numéros de ligne et les notes de revue des contrôles d'égalité. Des valeurs source différentes doivent rester des lignes séparées pour la revue.
- Conservez les lectures ultérieures. Gardez les observations ultérieures de la même annonce. Préservez les missions, intitulés, lieux et champs de statut modifiés entre les exécutions. Ne fusionnez pas des champs issus de moments de collecte différents dans une seule ligne combinée.
- Mettez à part les identifiants manquants. Déplacez les enregistrements sans identifiant d'emploi vers un tableau de revue séparé. Les URL source vérifiées peuvent offrir des indices d'identité. Les intitulés, noms d'entreprise, villes et champs vides ne peuvent pas établir une correspondance automatique.
- Créez des paires de revue. Comparez les annonces seulement au sein du même employeur vérifié. Comparez les intitulés, les lieux, les missions complètes et les moments de collecte. Rognez les espaces dans les colonnes de comparaison, mais préservez le texte source brut. Conservez les noms d'équipe, les niveaux de séniorité, les lieux et les références employeur. Un texte d'emploi standard partagé ne prouve pas l'identité de l'annonce. N'affirmez pas de correspondance automatique.
- Comparez les détails des annonces. Comparez les missions complètes, les références employeur, les équipes, la séniorité, les types de travail et les lieux. Le même employeur, le même intitulé et la même ville peuvent correspondre à des postes vacants distincts. Des références employeur différentes ou des missions différentes appuient des postes vacants distincts. Des références employeur concordantes aident la revue, mais les employeurs peuvent réutiliser les codes.
- Enregistrez les choix de revue. Étiquetez les paires comme `same_listing`, `possible_same_vacancy`, `separate_listing` ou `unresolved`. Enregistrez les preuves, les raisons, le nom du réviseur et la date de revue. Une classification `possible_repost` exige un identifiant d'annonce ultérieur et des missions concordantes. Des publications simultanées sur des sites différents sont des candidats inter-sources, pas des republications automatiques.
- Comparez directement les membres du groupe. Comparez chaque membre ajouté à la référence principale du groupe. Si l'annonce A correspond à l'annonce B, et que l'annonce B correspond à l'annonce C, l'annonce A ne correspond pas automatiquement à l'annonce C. Gardez séparées les annonces en conflit.
- Comptez les enregistrements séparément. Comptez les lignes brutes, les observations distinctes, les clés d'annonce source et les groupes de revue possibles comme des nombres séparés. Aucune fenêtre d'âge fixe ni aucun score de similarité ne prouve une correspondance.
Exemple fictif résolu : Northshore Tools
Toutes les lignes d'exemple appartiennent à l'employeur Northshore Tools, à l'intitulé Data Engineer et au lieu Toronto. Tous les identifiants sont des libellés fictifs. Les références employeur sont des notes du réviseur, pas des champs natifs de l'Actor. Le tableau montre six observations brutes issues de fichiers d'import.
| Ligne d'import | Clé source | Collecté à | Texte complet des missions conservé |
|---|---|---|---|
| R1 | `linkedin:L101` | 2026-10-01T09:00:00Z | Équipe reporting, missions d'entrepôt de données par lots |
| R2 | `linkedin:L101` | 2026-10-01T09:00:00Z | Équipe reporting, missions d'entrepôt de données par lots |
| R3 | `linkedin:L101` | 2026-10-03T09:00:00Z | Équipe reporting, missions d'entrepôt de données par lots |
| R4 | `linkedin:L202` | 2026-10-05T09:00:00Z | Équipe reporting, missions d'entrepôt de données par lots |
| R5 | `linkedin:L303` | 2026-10-05T09:00:00Z | Équipe produit, missions de données à faible latence |
| R6 | `indeed:I90` | 2026-10-05T09:00:00Z | Équipe reporting, missions d'entrepôt de données par lots |
Toutes les valeurs source conservées sous-jacentes de la ligne R2 correspondent à la ligne R1, y compris l'horodatage de collecte complet `2026-10-01T09:00:00Z`. Les libellés de ligne d'import sont hors de l'égalité des valeurs source. La ligne R2 est une copie exacte.
La ligne R3 partage la clé source `linkedin:L101` et contient les mêmes valeurs source, collectées plus tard à `2026-10-03T09:00:00Z`. C'est la même annonce lue plus tard. Conservez la ligne R3 avec la ligne R1.
Étapes de regroupement et de comptage
- Lignes d'import brutes : 6 lignes.
- Retrait de la copie exacte : retirez la ligne R2, car toutes les valeurs source correspondent à la ligne R1.
- Observations distinctes : 6 - 1 = 5 observations valides (R1, R3, R4, R5, R6).
- Clés d'annonce source : 4 clés d'annonce distinctes (`linkedin:L101`, `linkedin:L202`, `linkedin:L303`, `indeed:I90`).
- Groupes de revue possibles : 2 groupes créés. Le groupe G1 contient `linkedin:L101`, `linkedin:L202` et `indeed:I90`, sur la base de missions concordantes et de la note de réviseur NT-20. Le groupe G2 contient `linkedin:L303`, sur la base des missions de l'équipe produit et de la note de réviseur NT-21.
Tableau de décision provisoire des groupes de revue
| Groupe de revue | Clés d'annonce | Classification de revue | Preuve et raison du réviseur |
|---|---|---|---|
| G1 | `linkedin:L101`, `linkedin:L202`, `indeed:I90` | `possible_same_vacancy` | Les missions complètes correspondent. Le réviseur a noté la référence employeur NT-20 sur les descriptions. L202 est une republication possible de L101. I90 est un candidat inter-sources. |
| G2 | `linkedin:L303` | `separate_listing` | Les missions précisent l'équipe produit et des systèmes à faible latence. Le réviseur a noté la référence employeur NT-21. Annonce distincte de G1. |
Les nombres de postes vacants confirmés restent inconnus. Les groupes de revue possibles ne confirment pas l'identité du poste vacant sous-jacent ni la disponibilité actuelle. Deux groupes de revue provisoires ne sont pas deux postes vacants prouvés.
Limites à traiter en pratique et frontières de l'analyse
Laissez les annonces dont le texte complet manque marquées comme non résolues jusqu'à la revue manuelle. Lorsque le même identifiant montre des missions modifiées, conservez la nouvelle observation dans votre journal. Gardez les annonces séparées lorsque les intitulés correspondent mais que les équipes ou les références diffèrent. Pour des lieux différents, examinez si les annonces représentent des postes vacants distincts ou une seule publication multi-lieux.
Si une URL source échoue pendant la vérification, enregistrez un contrôle échoué. Ne supposez pas que le poste est clos ou pourvu. Gardez visibles dans vos notes les références employeur en conflit. Conservez le texte d'âge relatif dans son format d'origine. Un nombre de doublons égal à zéro dans une petite exécution de test ne prouve pas que des exécutions plus grandes ne contiennent aucun doublon.
Sources et lectures complémentaires
- Aide LinkedIn : republier un emploi clos ou expiré
- Aide employeur Indeed : intégrité des publications d'emploi et doublons
- Google Search Central : consignes sur l'identifiant des données structurées d'offre d'emploi
- Documentation Apify : guide de stockage des jeux de données
- Actor Apify : LinkedIn Jobs Scraper
- Actor Apify : Indeed Jobs Scraper
- Exemple de Task Apify : exporter les emplois LinkedIn vers CSV ou Excel
- Exemple de Task Apify : jeu de données de preuves d'emplois republiés Indeed
- Discussion Reddit csMajors : emplois republiés sur LinkedIn
- Discussion Reddit Recruiting Hell : suivi des publications d'emploi
Par Chronometrica · Mis à jour
Retour en haut ↑