Configuración de la recolección
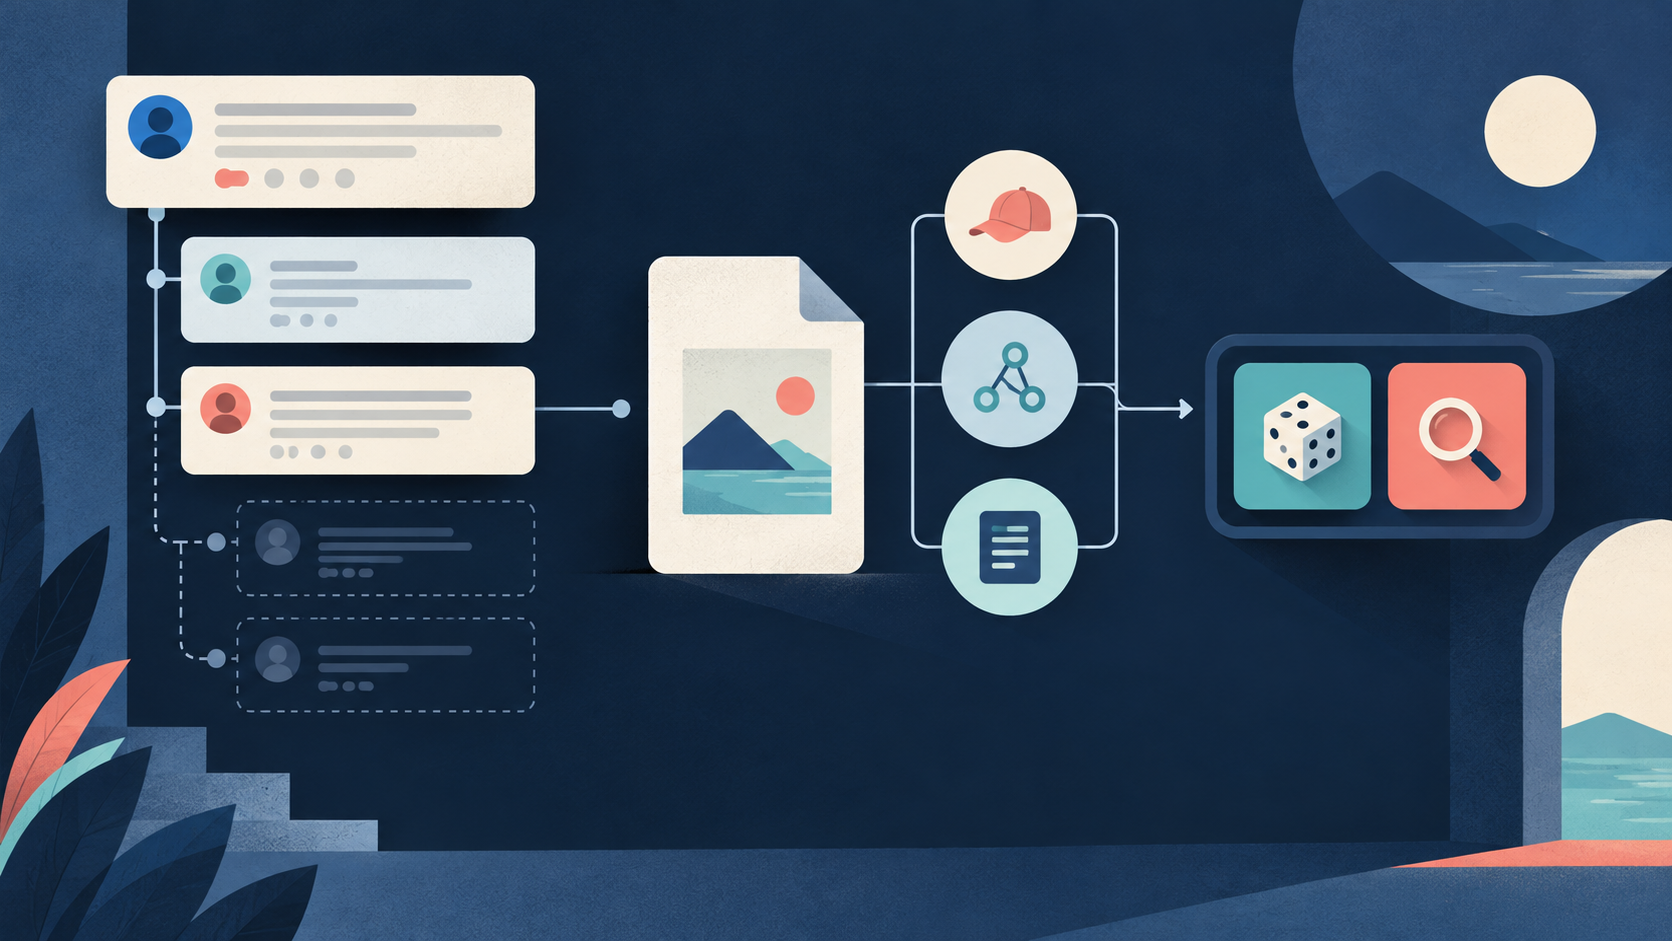
El Reddit Comments Scraper devuelve filas de comentarios de hilos públicos conocidos, y no filas de publicaciones separadas. La entrada exige `postUrls` (de 1 a 50 URL de hilos públicos) y `maxCommentsPerPost` (de 1 a 500 por publicación, predeterminado 100, predefinido 250, piloto de un hilo conocido con tope 3).
Cada exportación de fila incluye campos exactos: `postId`, `commentId`, `parentId`, `depth`, `body`, `status`, `unavailableFields` y `observedAt`. Los valores de estado de fila del conjunto de datos son estrictamente `ok`, `deleted` y `removed`. Los estados parciales y fallidos de la ejecución o de la entrada permanecen separados de los valores de estado de fila.
La marca OUTPUT `isComplete=true` indica que el procesamiento terminó en este control, mientras que los resultados generales de la entrada siguen parciales. `inputResults` tiene `status`, `reason`, `commentsFound` y `commentsSaved`, y `hiddenBranchesRemaining` puede ser null. Un piloto actual que devuelve tres ID con el cuerpo presente, y con `parentId`, `depth` y las ramas no disponibles, y sin filas removed ni deleted, demuestra una recolección acotada, no un panel de moderación en vivo ni un historial completo. Un autor faltante es distinto de un cuerpo faltante; nunca infiera la causa ni recupere palabras faltantes.
Abra la tarea Reddit Moderation Research Dataset para revisar el ajuste público de la ejecución.
Ocho pasos para registrar el texto faltante
- Defina la unidad de investigación y el alcance de la instantánea antes de contar. Observe las identidades de comentarios en los hilos indicados en un momento de recolección. Mantenga aparte los ID no resueltos. No mezcle los recuentos que muestra la fuente ni las ramas desconocidas en un denominador de filas observadas.
- Conserve la exportación de origen sin cambios y el archivo de salida. Para cada identidad conocida, retenga su estado, la disponibilidad del cuerpo, los campos no disponibles y la hora de observación. No elimine una posición removed o deleted solo para obtener una tabla de texto sin esas filas.
- Cree un subconjunto de trabajo para el análisis de texto que contenga cuerpos realmente disponibles. Deje fuera el texto de relleno. Conserve un autor faltante como un hecho separado. Un cuerpo visible anónimo puede seguir siendo texto disponible según la regla de su estudio.
- Informe las posiciones conocidas observadas, las posiciones con texto disponible, los marcadores removed, los marcadores deleted y las demás posiciones no disponibles o inciertas. Use categorías disjuntas para un recuento simple e indique su regla de asignación. Si los estados se superponen o las identidades entran en conflicto, revíselos en lugar de forzar la suma.
- Mantenga el denominador del análisis junto a cada porcentaje. Una proporción entre filas con texto disponible responde una pregunta distinta de una proporción entre todas las posiciones observadas. Ninguna estima la discusión completa no observada.
- En revisiones repetidas, una solo identidades conocidas de comentarios de origen y compare sus estados observados. Mantenga las claves recién observadas y las claves que ya no se observan separadas de una transición de estado confirmada de la misma clave. La ausencia en una instantánea posterior con tope no prueba una eliminación.
- No atribuya un cambio de estado a moderadores, autores, una política, censura o una clase de sentimiento sin evidencia independiente de la fuente. Un cuerpo no disponible no se puede clasificar solo por las respuestas vecinas.
- Entregue una tabla de disponibilidad de la instantánea y, cuando haya respaldo, una tabla de transición de claves emparejadas. Mantenga visibles los límites de la recolección y las incógnitas para que otro investigador pueda entender qué texto entró en el análisis.
Todas las identidades, los estados y las métricas de estas tablas son artefactos ficticios redactados y no representan resultados medidos de moderación del mundo real.
Instantánea A: tabla de estado observado de diez claves (ficción)
| ID de clave | Estado de origen | Disponibilidad del cuerpo | Recuento / proporción |
|---|---|---|---|
| C1–C7 | ok | Disponible | 7 filas (70%) |
| C8–C9 | removed | No disponible | 2 marcadores removed (20%) |
| C10 | deleted | No disponible | 1 marcador deleted (10%) |
- Detalles del denominador: la proporción de texto disponible es 7/10 = 70%; el texto no disponible es 3/10 = 30%. Un clasificador de sentimiento inventado etiqueta como positivos 4 de 7 cuerpos disponibles; 4/7 equivale aproximadamente a 57.1% solo como proporción del texto analizable. No escriba que el 40% de todos los comentarios es positivo y no asigne etiquetas a cuerpos desconocidos.
Instantánea B: tabla de estado de diez claves emparejadas y libro de transiciones (ficción)
Instantánea B: tabla agrupada de claves emparejadas (ficción)
| ID de clave | SnapshotAstatus | SnapshotBstatus | Transición |
|---|---|---|---|
| C1–C6 | ok | ok | sin cambio |
| C7 | ok | removed | con cambio |
| C8–C9 | removed | removed | sin cambio |
| C10 | deleted | deleted | sin cambio |
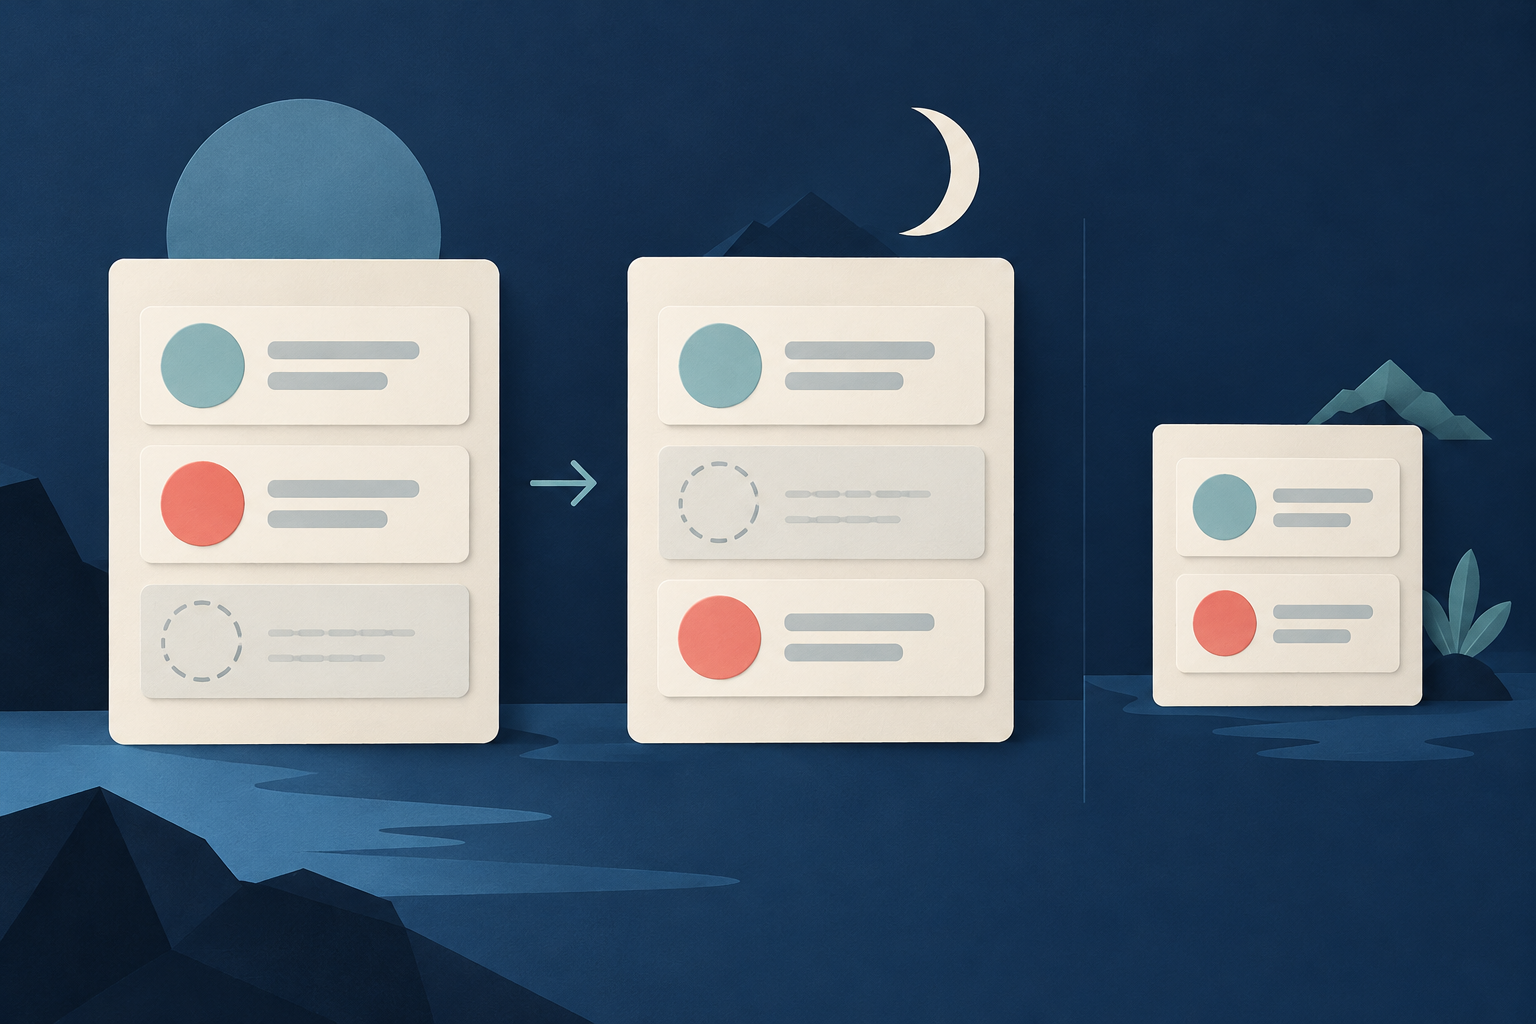
- Métricas de la instantánea B: 6 disponibles, 3 removed, 1 deleted (9 claves sin cambio más 1 clave con cambio). Esta tabla ficticia ilustra la aritmética del denominador y no representa resultados de moderación del mundo real.
- Métricas de la instantánea B: 6 disponibles, 3 removed, 1 deleted. La disponibilidad del texto es 6/10 = 60%, 10 puntos porcentuales menos que en la instantánea A. Esto no es un efecto de moderación medido, ni una causa de eliminación, ni una tendencia de la comunidad.
Instantánea C: nota de comparación de alcance (ficción)
- La instantánea C devuelve 8 claves en total (7 claves anteriores conservadas más la clave nueva C11; se omiten C1, C2 y C3).
- La ausencia de C1, C2 y C3 en esta instantánea limitada no es prueba de eliminación.
- Las categorías de cuerpo no están suministradas para C, así que no calcule ninguna tasa de disponibilidad.
Fuentes y lecturas adicionales
Por Chronometrica · Actualizado
Volver arriba ↑