設定你的職位數據收集
使用 LinkedIn Jobs Scraper Actor 及 LinkedIn Jobs by Experience Level Dataset Task 收集職位列表。範例輸入把 `searchTerm` 設為 data engineer,把 `experienceLevel` 設為 entry。讀者按自己的範圍替換這兩個值。
設定 `fetchJobDetails=true`、`maxItems=3` 及 `saveOnlyUniqueItems=true`。MaxItems 在整次收集中共用。保留這些欄位:`jobId`、`jobUrl`、`title`、`companyName`、`locationRaw`、`seniority`、`employmentType`、`descriptionStatus`、`descriptionText`、`descriptionSnippet` 及 `scrapedAt`。欄位值可以缺失。
Actor 提供來源文字與標籤,不提供履歷分析或契合分數。進行比較之前,必須先有與來源相符的完整描述。描述片段不能證明一項未提及的技能並不存在。目前這三筆已接受的完整詳情列,只確立來源的資料形態,並不是一項真實的履歷比較測試。
1. 建立你的證據清單
寫下你的目標職位名稱,以及你不可讓步的規則。列出一份誠實的工作證據短清單。包括你做過的任務、用過的工具、專案範圍,以及相關日期。把自我評估與職位列表的要求分開。
Actor 是一個託管程式,用來從網絡收集數據。Task 是為該程式儲存的輸入預設。你可以用 Actor 收集職位資料列,但必須自己做人手分析。數據收集器給你職位文字與來源標籤。它不提供技能匹配分數,也不分析你的履歷。
2. 收集少量職位樣本
收集少量包含完整描述的職位列表。在用某一則職位做要求比較之前,你必須先通過完整描述關卡。如果描述缺失,把證據標為不足,不要因為沒有出現某些字詞就否決該職位。
仔細核對職位的來源職級標籤。來源職級標籤可以與實際經驗要求不同,所以你必須閱讀完整職責與條件。保留來源文字、狀態及觀察時間。不要把私人履歷傳送給第三方模型。這個方法不需要模型,也不需要上傳履歷。
3. 拆分職位要求
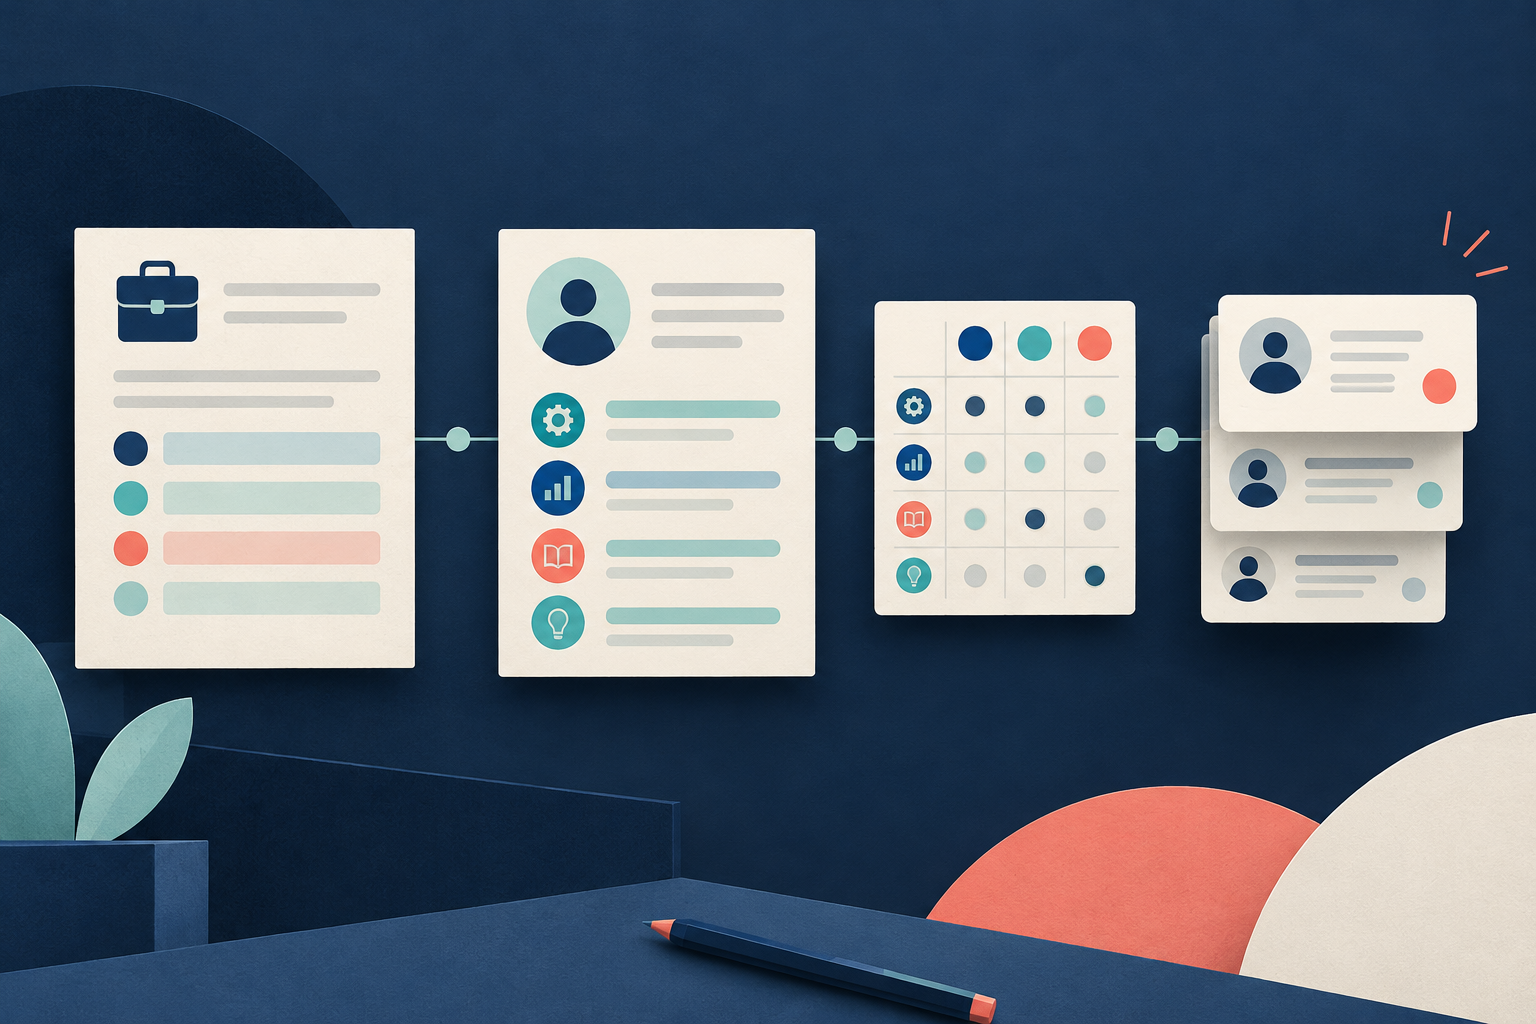
把職位列表拆成三部分:必要條件、必要職責與技能,以及偏好的額外項目。在每項已解讀的要求旁邊,保存支持該項解讀的文字段落。不要把公司相關段落中提到的每項工具,都變成申請人的必備技能。
4. 套用硬性條件檢查
先檢查硬性要求。如果職位要求一項你無法滿足的條件,就按你的規則排除它。如果一項重要條件不清楚,就標為稍後核實。通過這些檢查的職位,可以進入技能與職責檢視。這項檢查並不承諾你符合資格,也不承諾你會被選中。
5. 把職責對應到你的證據
把每項核心職責與你的工作證據對照。把每項職責評為已證明、相關但有限、未證明,或不清楚。用一句話說明理由。舊工具名稱的相符,可能不如同一職責的近期證據有用。清楚寫出這個判斷,不要把它藏進一個數字裡。
6. 把偏好的額外項目分開
把偏好的額外項目與核心要求分開。缺少一項偏好工具,並不代表硬性否決,除非職位列表寫明該工具是必要的。不要自創權重,也不要把加總後的分數稱為客觀。
7. 選擇你的短名單類別
把每則職位歸入三個類別之一:短名單、超出已證明技能/待核實,或擱置,並附上一個清楚理由。把未知項與問題保存下來,留待稍後檢查。如果兩個職位的契合程度相近,就用職責匹配與必要缺口,決定把閱讀與申請的時間花在哪裡。不要使用虛假的獲聘機率。
8. 維持決策表
維持一份與來源連結的決策表。當僱主澄清一項要求,或你自己的證據有變時,更新這份表。結果是一份透明的短名單。申請與主動聯絡是你稍後另行採取的行動。
虛構例子與證據分析
這個例子中的所有職位與申請人經驗都是虛構的。
申請人證據清單
- 建立過一條 Python 與 SQL 的每週報告管道。
- 檢查過數據質素,並記錄故障。
- 沒有正式環境輪值職位的經驗。
- 沒有團隊管理經驗。
- 目前正在學習雲端部署。
- 沒有聲稱商業成功或數字。
範例職位
- 職位 A:要求 Python 與 SQL 報告,以及來源質素檢查;偏好雲端部署;職級欄位寫著 entry。沒有已知的硬性衝突。證據把必要職責對應到已證明的工作。已記錄雲端偏好項目的缺口。
- 職位 B:要求正式環境的雲端運作,以及輪值事故處理;偏好 Python。申請人與 Python 的相符,並未滿足兩項主要職責。
- 職位 C:要求管理團隊並負責預算;職銜寫著 data lead;描述文字不完整。管理未證明,而且完整要求的上下文尚未核實。
證據表
| 職位 | 要求或職責 | 申請人證據 | 匹配狀態 | 決定與理由 |
|---|---|---|---|---|
| A | Python 與 SQL 報告 | 建立過每週報告管道 | 已證明 | 短名單:核心報告職責已證明 |
| A | 來源質素檢查 | 檢查過數據,並記錄故障 | 已證明 | 短名單:質素檢查已證明 |
| A | 雲端部署 | 正在學習雲端部署 | 相關但有限 | 短名單:雲端額外項目待定 |
| B | 正式環境與輪值 | 沒有正式環境輪值職位 | 未證明 | 擱置:缺少必要的正式環境運作 |
| C | 管理與預算 | 沒有管理經驗 | 未證明 | 待定:因文字不完整,需要完整來源檢視 |
為何以職責為本的檢視重要
如果只找關鍵詞,Python 這個詞在職位 A 與職位 B 都出現,就會得到兩個匹配。然而,以職責為本的檢視只把職位 A 列為清楚的首個短名單,因為職位 B 缺少正式環境與輪值職責的證明。
這名讀者使用缺少核心職責的證據規則擱置職位 B,因為正式環境雲端運作與輪值職責均未證明。雙方共有的 Python 一詞並非充分證據。職位 A 仍然是清楚的短名單,職位 C 則繼續待完整來源檢視。全部五列證據確認:Python 的兩次關鍵詞命中,只產生一個清楚的短名單,當中沒有權重,也沒有預測的面試機會。
來源與延伸閱讀
作者 Chronometrica · 更新日期
返回頂端 ↑