采集设置
打开 YouTube Search Scraper 或 YouTube Content Idea Research Task。当前预设输入包括 queries(复数形式),maxResults 为150,resultsPerQuery 为40,maxPagesPerQuery 为2,enableQueryExpansion 设为 true,enrichWithVideoMetrics 设为 true。
进行小规模试采集时,将 queries 的内容替换为1个观众问题,将 maxResults 设为2,resultsPerQuery 设为2,maxPagesPerQuery 设为1。将 enableQueryExpansion 设为 false、enrichWithVideoMetrics 设为 false,以关闭查询扩展和指标补充;还可将可选项 enrichMissingChannelFields 设为 false。在同一次运行中,所有查询共用 maxResults 总上限,而 resultsPerQuery 限制每次搜索的结果数。不同运行各自有独立的 maxResults 上限。
原样保留这些输出字段:rootQuery、query、querySource、pageIndex、pageRank、postId、postUrl、postType、isShort、title、description、publishedAt、channelId、status、statusReason 和 observedAt。来源排名表示结果位置,不代表需求或内容质量。当前包含2个候选结果的对照检查没有使用查询扩展或数据补充,发布日期均为 null。这项检查只验证了限定范围内的来源数据结构,没有验证创意质量,也没有验证实际审查过的视频内容。缺失的日期仍属未知,不能推定为0。对实际回答的审查需由人工完成。
收集并梳理观众问题
- 选定1位观众,以及1个你能回答的真实问题。写清相关的操作、已有知识和适用范围。将这个问题转化为2或3个直白的搜索短语。这些只是拟用的搜索词,不代表已经验证的搜索量。
- 为每个短语采集少量样本,并明确记录查询词、数量上限和时间。保留来源视频的标识信息,以及同一视频在不同查询中重复出现的背景。比较 Shorts 和长篇教程时,应注明格式差异,避免将它们视为具有相同的讲解深度。
- 在可以查看视频内容时,审查每个视频的实际回答。标题可能承诺给出某个回答,但视频正文却遗漏了关键条件。如果无法查看视频,就将覆盖情况保留为“未审查”,不要根据标题或简介推断。
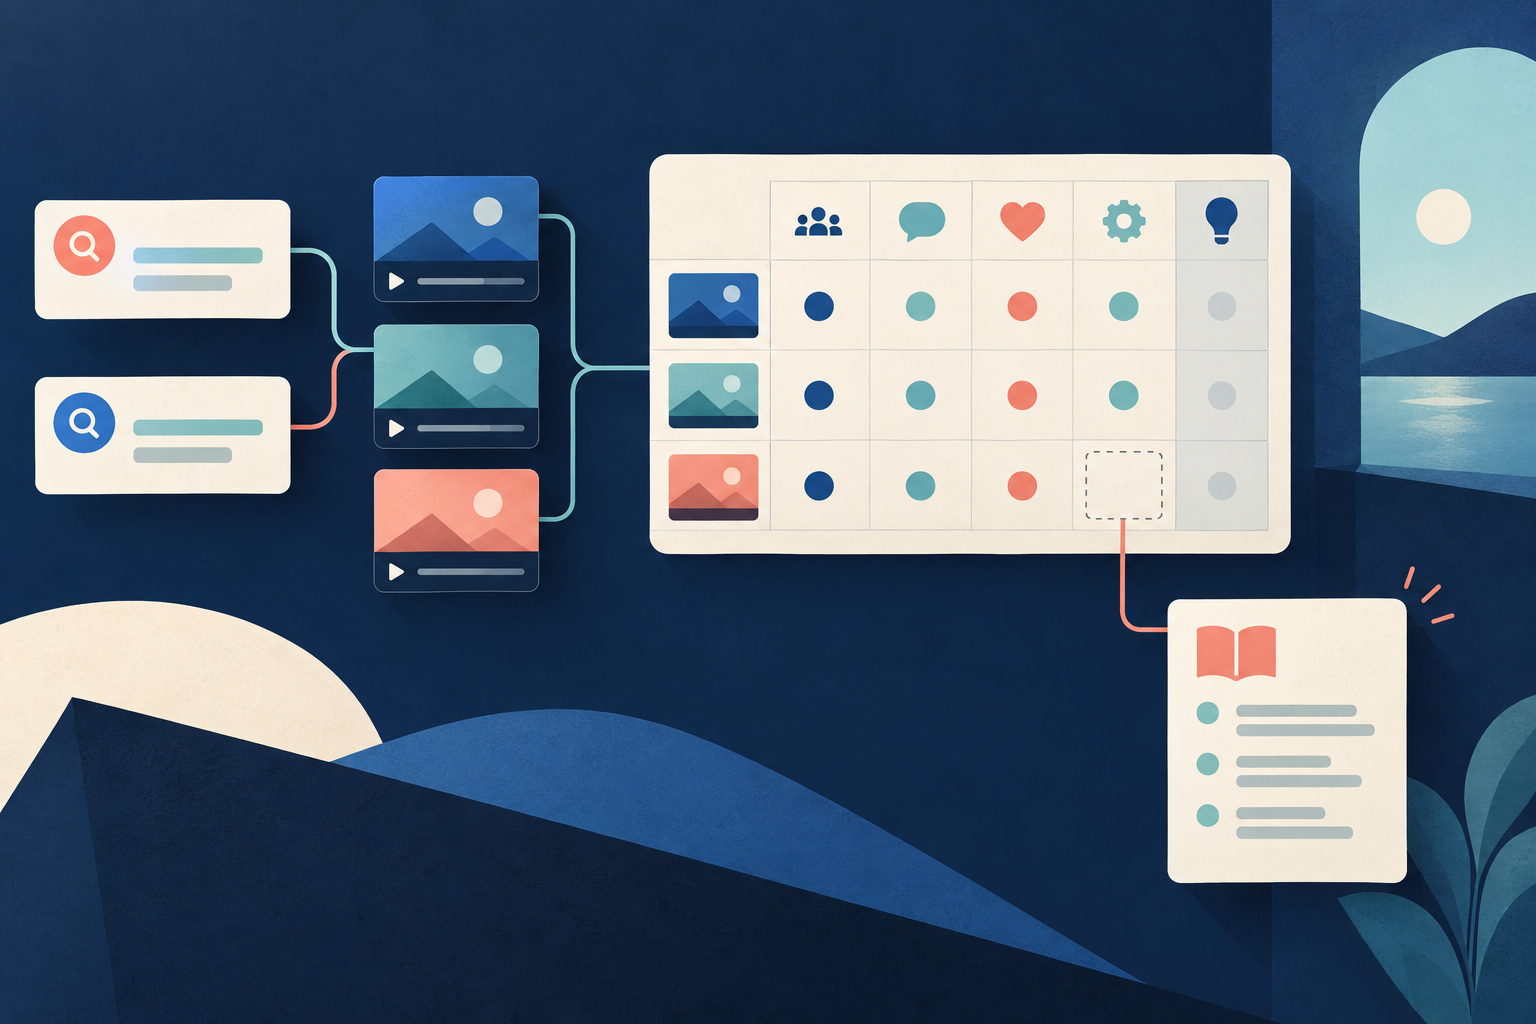
- 制作问题要点矩阵。行表示观众需求,列表示已审查的来源视频。单元格标记为“已回答”“部分回答”“未涉及”或“未审查”,并附上来源段落或场景笔记。这些标签由读者自行创建,并非 Actor 输出。
- 寻找已观察示例没有解释的具体条件或步骤。要区分样本中的缺口与整个 YouTube 上都不存在相关内容的情况。对于一个不常见的问题,样本之外可能已有出色的回答;问题不常见,并不能证明存在尚未得到充分满足的需求。
- 用你自己核实过的方法、示例或一手来源验证拟提供的回答。不要仅仅因为某个观点与采集到的视频不同,就发布这种反向观点。目标是提供更清晰、更有用的教学,而不是照搬结构或追求缺乏依据的新奇观点。
- 撰写原创教学提纲:直接回答、必要条件、逐步讲解的完整示例、检查方法或失败案例,以及最后的操作。自然地使用关键词,因为它表达了这个问题;不要堆砌关键词,也不要承诺流量。
- 将覆盖矩阵和来源的局限与创意一起保存。你可能需要自己的观众反馈或搜索需求数据,才能按商业价值确定其优先级;仅凭这个数据集无法完成这项判断。最终成果是有依据、针对具体问题的提纲,而不是保证成功的关键词。
问题要点矩阵示例
下面用一个虚构测试说明这个过程。观众是一名电子表格新手。问题是如何比较2份导出文件,而不遗漏发生变化的行。查询组 A 使用 compare CSV files。查询组 B 使用 find changed spreadsheet rows。候选视频共占据5个结果位置,涉及4个不同的视频。人工审查覆盖视频1、视频2和视频4。视频3仍未审查。实际观看需由人工完成。日期或指标若为 null,仍表示未知,不是0。
需求包括匹配稳定的键、比较数据值、处理缺失的键,以及检查重复项。
| 需求 | 视频1 | 视频2 | 视频4 | 视频3 |
|---|---|---|---|---|
| 匹配稳定的键 | 已回答 | 部分回答 | 已回答 | 未审查 |
| 比较数据值 | 已回答 | 部分回答 | 已回答 | 未审查 |
| 处理缺失的键 | 未涉及 | 未涉及 | 未涉及 | 未审查 |
| 检查重复项 | 未涉及 | 未涉及 | 已回答 | 未审查 |
视频1回答了前2项规则,但遗漏了后2项。视频2只展示逐行比较,而行的顺序可能变化,因此它对全部4项需求的覆盖,最多只能算部分回答,或完全未涉及。视频4回答了稳定的键和重复项问题,但没有说明缺失键时如何作出判断。视频3的单元格表示未审查,而不是未涉及。
在所观察的样本中,发现的缺口是:3个已审查视频都没有演示用于核查缺失键的记录表。这并不表示 YouTube 上没有这类视频。
原创教学提纲和简化示例
原创提纲分为5个部分。直接回答是:匹配已知的行键,并将缺失键的行保留待查。必要条件是:键必须能够标识记录。逐步讲解的完整示例使用2份虚构的导出文件,其中行的顺序发生了变化。检查要求是:不能根据行的位置为缺失键的行指定键。最后的操作是创建变更表和待解决表。
假设旧数据行中,键1的值为10,键2的值为20。新数据行中,键2的值为21,键1的值为10,还有1个未知键,其值为20。
Old: K1=10, K2=20
New: K2=21, K1=10, Unknown=20确认键1没有变化。确认键2的值从20变为21。将新增的未知行保留为待解决状态。不要仅仅因为20看起来与旧值相同,就把未知行匹配到键2。最终成果包含4个视频覆盖情况列,记录已审查来源数为3,保留1个未审查列,并附上分为5个部分的原创提纲。由此无法得出实际内容表现、搜索量或预计观看次数。
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑