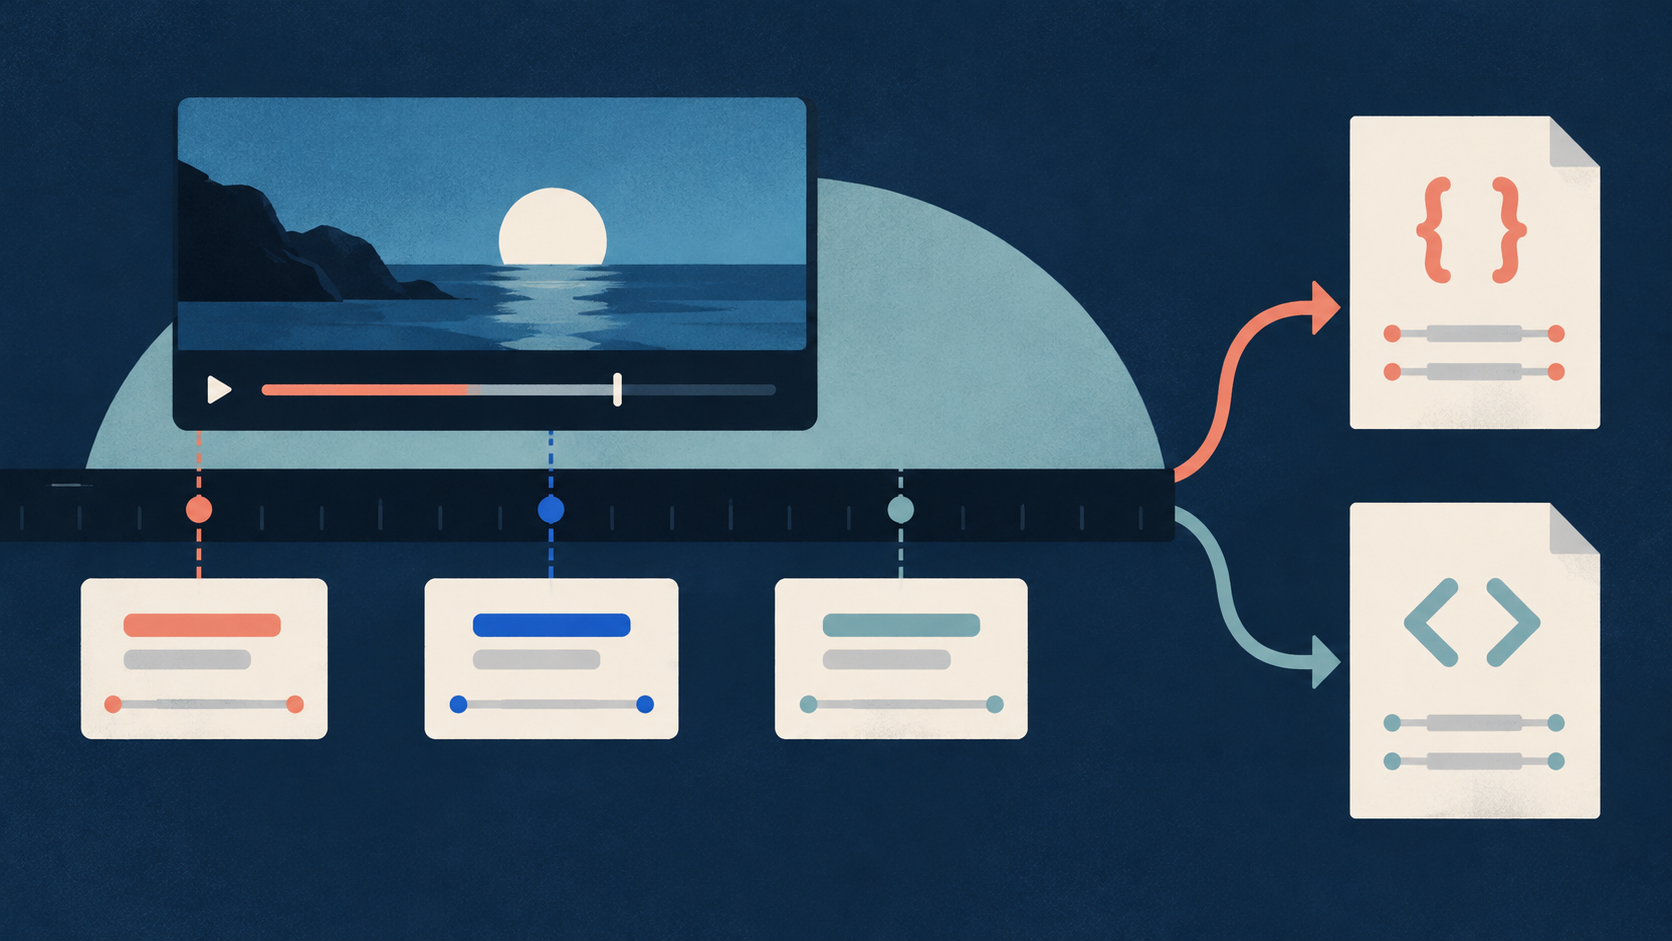
即使只有一个视频,也可能同时需要两份文本:一份供阅读的干净文本副本,以及一份供参照的带时间源副本。你可以使用 Actor。Actor 是一种托管的数据收集程序。你通过 Task 来配置 Actor。Task 是已保存的输入预设。如果选中 JSON,它会保留带时间的片段。JSON 是一种结构化文本格式。仅文本的输出不会保留这些片段。
了解字幕来源与限制
YouTube 字幕来自创作者上传的手动轨道,以及平台算法生成的自动语音识别。官方文档说明,带有字幕的视频可以通过视频简介菜单直接获得文字稿(YouTube 帮助:查看转录稿)。不过,自动字幕可能因发音错误、口音、方言或背景噪音而错误表述语音(YouTube 帮助:自动字幕)。此外,官方参考资料还将开头的长时间静音和人声重叠列为可能的字幕生成问题。这些一般性列表本身并不能诊断某一个具体视频。
要访问公开字幕轨道,目标视频必须确实提供可用字幕。如果轨道本身缺失或已停用,只打开直接视频 URL 并不够。请注意,公开字幕访问与一般观看访问并不相同。不要把不公开列出的视频与私享视频归为一类,因为只要创作者已启用,不公开列出的视频仍然可以提供公开字幕轨道。请把缺失字幕、语言不匹配和提取失败区分开。
获取并检查文字稿的实用方法
- 在开始提取之前,确认确切的直接视频链接,并记录它的主要研究目的。核实你使用的是已知的公开视频 URL,而不是播放列表或频道页面。
- 在原生界面中测试该视频:打开它的页面,滚动到简介,并点击 Show transcript(显示转录稿),以检查可用轨道。如果该操作不存在,请把它当作进行下一项检查的提示,而不是自动作出的隐私诊断。
- 选择纯阅读文本、带时间的证据,或两者都要。当你同时需要干净的阅读文本和带时间的片段时,请同时选择 json 和 text。
- 使用 startUrls 数组配置输入,并放入一条直接视频 URL。将 outputFormats 设为 ["json", "text"],并保持 includeFailedInputDetails 为启用。将 preferredLanguages 留空,可以让抓取程序选择最佳的可用轨道。严格的英语分析则要求将它设为 ["en"]。
- 运行提取,并同时检查数据集行和 OUTPUT 摘要记录。使用 rowsWritten、successfulTranscriptRows、failedInputs 和 duplicateVideosSkipped 等字段来核算你的输入。
- 请注意,text 是数据集行中的一个字段,而不是自动下载的文本文件。打开一个成功的行,把 text 字段的值复制到你自己的阅读文档中,并另行保留一份 JSON 源导出,其中包含用于时间的片段。检查 videoId、实际的 transcriptLanguageCode 和 transcriptLanguageName。当确切措辞很重要时,把开头、中间和结尾的音频样本与对应的字幕片段进行比较。请注意,抽查并不能证明每一个词。请把手动更正与你的原始源数据分开保存。
- 对照失败表检查所有错误代码,以确定下一步。查看 isRetryable 属性。仅当该值为 true 时,才在稍后进行一次有限度的重试。
- 保留 URL、视频 ID、实际语言、自动或手动标志、scrapedAt 收集时间、结果状态、源副本和更正备注。最后明确决定:该文字稿是否符合你的质量标准与完整性标准。
使用结构化 Actor 自动提取
当一个或多个已知视频需要已保存的阅读文本和带时间的证据时,Chronometrica YouTube Transcript Scraper 可以帮助收集这些数据。此 Actor 读取现有的公开字幕轨道。当选中 json 和 text 时,它可以提供可读文本副本和带时间的片段。
此 Actor 读取现有的公开字幕轨道。它不会创建语音识别、翻译文本、下载媒体或发现视频。
要配置此 Actor,你需要提供一份输入。你可以查看专门的预设,例如用作 JSON 与 text 起步配置的 YouTube Transcript Scraper、仅 text 预设 YouTube Transcripts as Plain Text,或仅 JSON 预设 YouTube Timestamped Transcript JSON。请注意,仅 text 预设不会保留带时间的片段。当你同时需要阅读文本和时间证据时,请一起使用 json 和 text。
startUrls 输入接受一个由直接视频 URL 字符串组成的数组。outputFormats 输入接受 json 和 text 等格式。includeFailedInputDetails 参数控制失败输入的详细错误报告是否出现在 OUTPUT 运行摘要中。
{
  "startUrls": [
    "VIDEO_URL_TO_REPLACE"
  ],
  "outputFormats": [
    "json",
    "text"
  ],
  "includeFailedInputDetails": true
}在运行之前,把整个 VIDEO_URL_TO_REPLACE 标记替换为一条已知的直接公开视频 URL,因为所显示的标记只是占位符。
解读运行结果与输出字段
一次 Actor 运行会生成数据集行和一条运行摘要记录。一个数据集行代表一份成功的唯一视频文字稿,而不是一条输入或一个片段。失败的输入不会创建数据集行。
OUTPUT 是运行摘要记录,它核算成功、失败和被跳过的重复项。关键摘要字段包括 inputsReceived、uniqueVideosPlanned、rowsWritten、successfulTranscriptRows、failedInputs、duplicateVideosSkipped、statusCounts、errorCodeCounts 和 failedInputDetails。不要仅凭空的数据集就推断某个视频没有字幕。
按照本文的 JSON 与 text 配置,每个成功的行都同时包含纯文本阅读副本和带时间的片段数据。选择其他输出格式,并不自动意味着带时间的片段会保留在你的数据集中。
验证输出质量与指标(虚构)
要评估提取的可靠性,你可以计算样本指标。设想一次已标明为虚构的运行,其中 preferredLanguages 设为 ["en"]。七条输入链接包含五个唯一视频和两条重复输入。三个唯一视频产生成功的英语文字稿,一个没有公开字幕,一个缺少匹配的英语轨道,因此造成 LANGUAGE_UNAVAILABLE 错误。如果改用默认的空偏好,则可能选中另一条可用的语言轨道,因此仅缺少英语并不会使默认运行失败。
在这个虚构样本中:
- 输入总数:7
- 唯一视频:5(3 个成功,2 个失败)
- 重复输入:2
- 写入的数据集行:3
可用轨道可得性 = 成功的唯一视频 / 唯一视频总数 = 3 / 5 = 60%。
这个 60% 的数字描述的是这个选定样本中的可用轨道可得性,不是准确率,也不是 YouTube 全平台的比率。
再设想一个单独的虚构计时示例:第一条字幕条从 2 秒开始,最后一条字幕条在 92 秒结束,视频总长度是 100 秒。字幕跨度是 92 减 2,等于 90 秒。再除以 100 秒的视频总长度,比率是 90 比 100,即 0.90。
0.90 的字幕跨度比率只描述字幕跨度,不能衡量词语准确率。该跨度之内仍然可能存在间隙和词语识别错误。平台运行成功,并不意味着每一条输入都产生了字幕。
诊断并处理失败
失败代码描述的是观察到的失败类别,而并不总是提供确切的根本原因。请查看下面已记录的代码与下一步操作表,为每个错误匹配正确的应对。
| 错误代码 | 报告的状况 | 下一步检查与操作 |
|---|---|---|
| TRANSCRIPT_NOT_FOUND | 查找后没有可用的公开轨道 | 检查原生源页面;如有需要,请求字幕,或使用经授权的单独转录。 |
| LANGUAGE_UNAVAILABLE | 未找到所请求语言的匹配 | 检查可用的源轨道,并保留该要求;仅在可以接受时才更改策略。 |
| INVALID_INPUT / UNSUPPORTED_INPUT | 提供了错误的输入对象 | 将该条目替换为一条直接视频 URL 字符串。 |
| VIDEO_UNAVAILABLE | 视频不可用,原因未知 | 检查链接是否有效,以及视频 ID 的格式。 |
| AGE_RESTRICTED / LOGIN_REQUIRED | 视频不在公开范围内 | 选择一个可访问的来源;不存在绕过承诺。 |
| ACCESS_BLOCKED / TEMPORARY_FAILURE / TRANSCRIPT_PARSE_FAILED | 发生了请求失败或解析失败 | 检查 isRetryable,仅当该值为 true 时,才在稍后执行一次有限度的重试。 |
始终对照这些已记录的类别核实你的错误诊断。请根据返回的代码采取精确的纠正操作,而不要猜测未经核实的原因。
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑