収集の設定
YouTube Search ScraperまたはYouTube Content Idea Research Taskを開きます。現在のプリセット入力には、queries(複数形)、maxResults 150、resultsPerQuery 40、maxPagesPerQuery 2、trueに設定されたenableQueryExpansion、trueに設定されたenrichWithVideoMetricsが含まれています。
試行では、queriesを視聴者の疑問1つに置き換え、maxResultsを2、resultsPerQueryを2、maxPagesPerQueryを1に設定します。enableQueryExpansionをfalse、enrichWithVideoMetricsをfalseに設定して、クエリ拡張と指標の追加取得を無効にします。任意項目のenrichMissingChannelFieldsもfalseに設定します。maxResultsは1回の実行内で各クエリに共通する上限で、resultsPerQueryは各検索の上限です。実行が別であれば、maxResultsの上限も別になります。
出力フィールドは、rootQuery、query、querySource、pageIndex、pageRank、postId、postUrl、postType、isShort、title、description、publishedAt、channelId、status、statusReason、observedAtという正確な名前のまま保持します。取得元での順位が示すのは表示位置であり、需要やコンテンツの質ではありません。今回の候補2件を使った対照確認では、拡張も追加取得も行っておらず、公開日はnullでした。この確認で検証できるのは、範囲を限定した取得元レコードの構造であり、アイデアの質や、実際に視聴して確認した動画内容ではありません。欠損している日付は不明のままで、0と推定することはできません。実際の回答内容は人が確認します。
視聴者の疑問を収集して整理する
- 視聴者を1人想定し、自分が答えられる実際の疑問を1つ選びます。重要となる行動、前提知識、対象範囲を書き出します。その疑問を、わかりやすい検索語句2〜3個に変えます。これらは検索語句の候補であり、検索ボリュームが検証済みという意味ではありません。
- クエリ、取得上限、取得時刻を明記し、語句ごとに少数のサンプルを収集します。取得元の動画を識別する情報を保持し、同じ動画が複数のクエリに現れた場合も、そのクエリの情報を残します。Shortsと長いチュートリアルを比較するときは、形式の違いを明記せずに、解説の深さが同じであるかのように扱わないでください。
- 視聴できる場合は、各動画で実際にどのような回答をしているかを確認します。タイトルである回答を約束していても、動画本編では重要な条件を説明していないことがあります。動画を確認できない場合は、タイトルや説明文から回答範囲を推測せず、未確認のままにします。
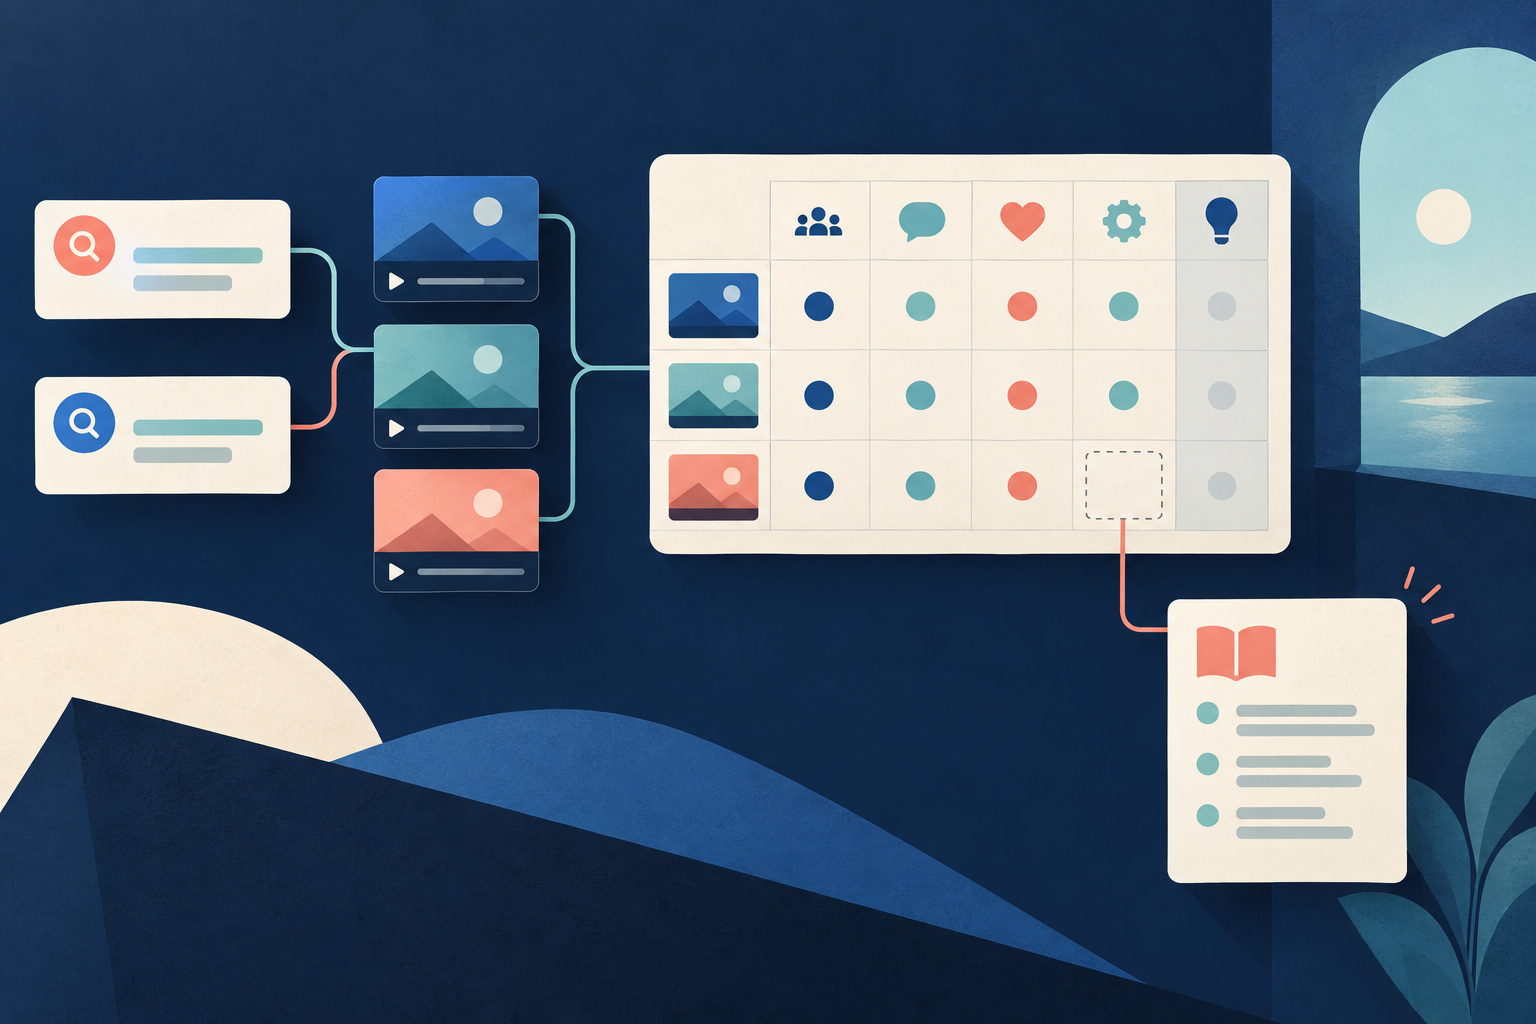
- 疑問を構成する項目ごとの一覧表を作ります。行は視聴者に必要な要件、列は内容を確認した取得元の動画です。各セルには、回答あり、一部のみ回答、回答なし、未確認のいずれかを記入し、根拠となる箇所や場面のメモを添えます。これらのラベルは読者が付けるもので、Actorの出力ではありません。
- 確認した事例で説明されていない具体的な条件や手順を探します。自分のサンプルで説明が見つからないことと、YouTube全体に存在しないことを区別します。あまり一般的でない疑問でも、サンプルの外に優れた回答が1つあるかもしれません。サンプルに説明がないだけでは、需要に対して供給が不足している証拠にはなりません。
- 提示しようとしている回答を、自分で確認した方法、具体例、または一次資料で検証します。収集した動画と異なるという理由だけで、通説に反する主張を公開しないでください。目標は、よりわかりやすく役立つ解説です。構成の模倣や、裏付けのない目新しさを目指すものではありません。
- 疑問への直接の回答、必要な条件、手順を追って解く具体例、確認方法または失敗例、最後に取る行動という順で、独自の解説構成案を書きます。キーワードは疑問を表す言葉として自然に使います。語句を詰め込んだり、アクセス数を約束したりしないでください。
- 回答範囲の一覧表と取得元の制約を、アイデアと一緒に保存します。商業的な優先順位を決めるには、自分の視聴者からの反応や検索需要のデータが必要になる場合があります。このデータセットだけでは、その判断はできません。最終的な成果物は、成果の出るキーワードではなく、特定の疑問に対して根拠を持って作成した構成案です。
疑問の構成項目別一覧表の例
仕組みを理解するために、架空のテスト例を見てみましょう。視聴者は表計算ソフトの初心者です。疑問は、変更された行を見落とさずに2つのエクスポートデータを比較するにはどうすればよいか、というものです。クエリ群Aではcompare CSV filesを使い、クエリ群Bではfind changed spreadsheet rowsを使います。候補として現れた動画は、重複を除くと4本で、検索結果への出現は合計5件です。人が内容を確認したのは動画1、動画2、動画4で、動画3は未確認のままです。実際の視聴は人が行います。日付や指標がnullの場合は不明のままとし、0にはしません。
必要な要件は、変わらないキーでの照合、値の比較、欠損キーへの対応、重複の確認です。
| 要件 | 動画1 | 動画2 | 動画4 | 動画3 |
|---|---|---|---|---|
| 変わらないキーで照合する | 回答あり | 一部のみ回答 | 回答あり | 未確認 |
| 値を比較する | 回答あり | 一部のみ回答 | 回答あり | 未確認 |
| 欠損キーに対応する | 回答なし | 回答なし | 回答なし | 未確認 |
| 重複を確認する | 回答なし | 回答なし | 回答あり | 未確認 |
動画1は最初の2つの要件に答えていますが、残りの2つには触れていません。動画2は行ごとの比較しか示していません。行の順序は変わることがあるため、4つの要件はいずれも、よくても一部のみ回答、または回答なしとなります。動画4は変わらないキーと重複について答えていますが、キーが欠損している場合の判断を省いています。動画3のセルは回答なしではなく、未確認です。
このサンプルで確認できた説明不足は、内容を確認した3本の動画のいずれも、欠損キーを確認するための管理表を実演していないことです。YouTubeにそのような動画がないと主張しているわけではありません。
独自の解説構成案と簡単な例
独自の構成案は5つの部分からなります。疑問への直接の回答は、既知の行キーで照合し、キーが欠損しているものは確認用に保留することです。必要な条件は、キーでレコードを識別できることです。手順を追って解く具体例には、行の順序を変えた2つの架空のエクスポートデータを使います。確認事項は、キーが欠損している場合に行の位置をもとにキーを割り当ててはいけないという点です。最後に取る行動は、変更されたものの表と、未解決のものの表を作ることです。
古いデータには、キー1の値が10、キー2の値が20の行があるとします。新しいデータには、キー2の値が21、キー1の値が10、不明なキーの値が20の行があるとします。
Old: K1=10, K2=20
New: K2=21, K1=10, Unknown=20キー1に変更がないことを確認します。キー2の値が20から21に変わったことを確認します。新しいデータにある不明な行は、未解決のままにします。20が古い値と同じに見えるという理由だけで、その不明な行をキー2に対応付けてはいけません。最終的な成果物には、4本の動画の回答範囲を示す列、確認済みの取得元動画3本という件数、未確認の列1つ、5つの部分からなる独自の構成案が含まれます。ここから、実際のコンテンツの成果、検索ボリューム、推定視聴回数が導かれるわけではありません。
出典と参考資料
著者 Chronometrica · 更新日
ページの先頭へ ↑