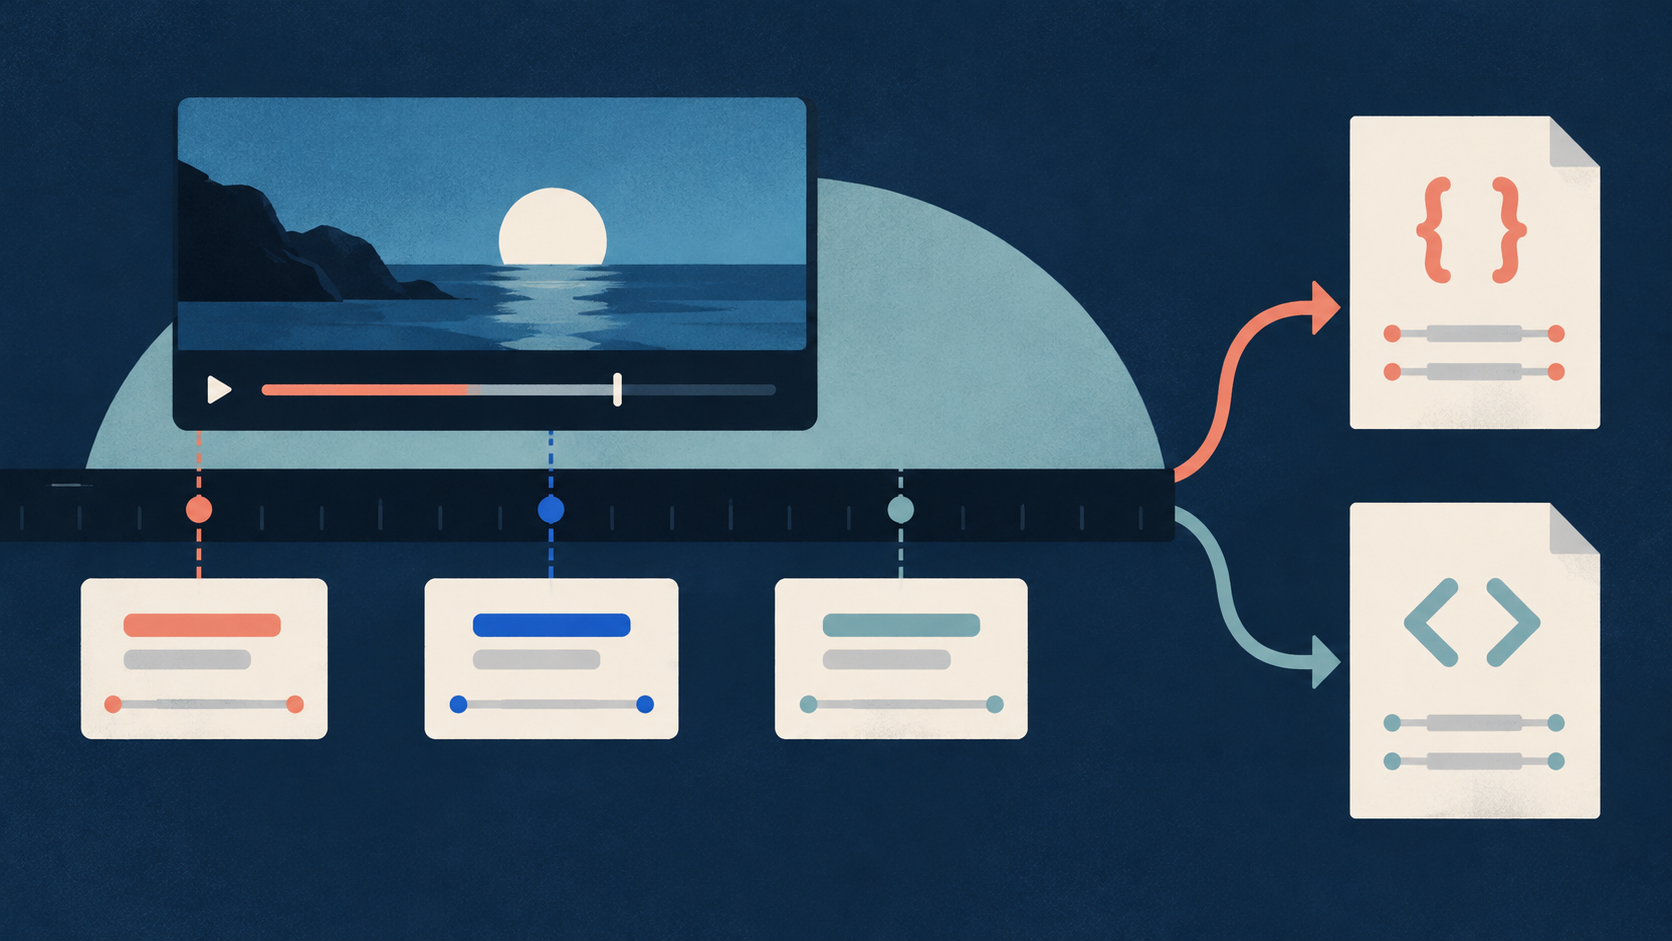
Même une seule vidéo peut exiger à la fois une copie de texte claire pour la lecture et une copie source minutée pour la référence. Vous pouvez utiliser un Actor, qui est un programme de collecte de données hébergé, configuré au moyen d'une Task, qui est un préréglage d'entrée enregistré. Lorsqu'il est sélectionné, JSON, qui est un format de texte structuré, conserve les segments minutés, alors que les sorties en texte seul ne les conservent pas.
Comprendre les sources de sous-titres et les limites
Les sous-titres YouTube proviennent de pistes manuelles téléversées par le créateur et de la reconnaissance vocale automatique générée par les algorithmes de la plateforme. La documentation officielle indique que les vidéos avec sous-titres ont une transcription disponible directement dans le menu de description de la vidéo (Aide YouTube : Afficher les transcriptions). Cependant, les sous-titres automatiques peuvent mal restituer la parole à cause de mauvaises prononciations, d'accents, de dialectes ou de bruit de fond (Aide YouTube : Sous-titres automatiques). De plus, un long silence au début et des voix qui se chevauchent sont indiqués comme des problèmes possibles de génération de sous-titres dans les références officielles. Ces listes générales ne diagnostiquent pas, à elles seules, une vidéo précise.
L'accès à une piste de sous-titres publics exige que la vidéo cible expose réellement des sous-titres utilisables. Ouvrir une URL directe de vidéo ne suffit pas si la piste elle-même est absente ou désactivée. Notez que l'accès aux sous-titres publics est distinct de l'accès général au visionnage. Ne regroupez pas les vidéos non répertoriées avec les vidéos privées, car les vidéos non répertoriées peuvent encore exposer des pistes de sous-titres publics si le créateur les a activées. Gardez distincts les sous-titres manquants, les non-correspondances de langue et les échecs d'extraction.
La méthode pratique pour obtenir et vérifier les transcriptions
- Confirmez le lien direct exact de la vidéo et notez son objectif principal de recherche avant de commencer l'extraction. Vérifiez que vous travaillez avec une URL de vidéo publique connue, plutôt qu'avec une page de liste de lecture ou de chaîne.
- Testez la vidéo de façon native en ouvrant sa page, en descendant jusqu'à la description et en cliquant sur Afficher la transcription pour vérifier les pistes disponibles. Si l'action est absente, traitez ce fait comme un signal pour le contrôle suivant, et non comme un diagnostic automatique de confidentialité.
- Choisissez un texte de lecture simple, une preuve minutée, ou les deux, en sélectionnant json et text ensemble lorsque vous avez besoin à la fois d'un texte de lecture clair et de segments minutés.
- Configurez votre entrée avec une seule URL directe de vidéo au moyen du tableau startUrls, réglez outputFormats sur ["json", "text"] et laissez includeFailedInputDetails activé. Laisser preferredLanguages vide permet à l'extracteur de sélectionner la meilleure piste disponible, tandis qu'une analyse strictement anglaise exige de le régler sur ["en"].
- Exécutez l'extraction et examinez à la fois les lignes du jeu de données et l'enregistrement de synthèse OUTPUT, en utilisant des champs tels que rowsWritten, successfulTranscriptRows, failedInputs et duplicateVideosSkipped pour rendre compte de vos entrées.
- Notez que text est un champ de ligne du jeu de données, et non un téléchargement automatique de fichier texte. Ouvrez une ligne réussie, copiez la valeur du champ text dans votre propre document de lecture et conservez un export source JSON séparé qui contient les segments pour les temps. Vérifiez videoId, le transcriptLanguageCode réel et transcriptLanguageName. Comparez des échantillons audio du début, du milieu et de la fin avec les segments de sous-titres correspondants lorsque la formulation exacte compte, en notant que les contrôles ponctuels ne certifient pas chaque mot. Gardez les corrections manuelles séparées de vos données source brutes.
- Vérifiez les codes d'erreur au regard du tableau des échecs pour déterminer l'étape suivante. Examinez la propriété isRetryable et ne faites une nouvelle tentative ultérieure bornée que si cette valeur est true.
- Conservez l'URL, l'identifiant de la vidéo, la langue réelle, l'indicateur automatique ou manuel, l'heure de collecte scrapedAt, l'état du résultat, la copie source et les notes de correction. Concluez par une décision claire sur le fait que la transcription répond ou non à vos critères de qualité et de complétude.
Automatiser l'extraction avec des Actors structurés
Lorsqu'une ou plusieurs vidéos connues exigent un texte de lecture enregistré et une preuve minutée, le Chronometrica YouTube Transcript Scraper aide à collecter les données. Cet Actor lit les pistes de sous-titres publics existantes et peut fournir une copie de texte lisible ainsi que des segments minutés lorsque json et text sont sélectionnés.
Cet Actor lit les pistes de sous-titres publics existantes. Il ne crée pas de reconnaissance vocale, ne traduit pas le texte, ne télécharge pas de médias et ne découvre pas de vidéos.
Pour configurer l'Actor, vous fournissez une entrée. Vous pouvez explorer des préréglages spécialisés, comme le YouTube Transcript Scraper pour un démarrage JSON et text, le YouTube Transcripts as Plain Text pour un préréglage en texte seul, ou le YouTube Timestamped Transcript JSON pour un préréglage en JSON seul. Notez que le préréglage en texte seul ne conserve pas les segments minutés ; utilisez json et text ensemble lorsque vous avez besoin à la fois du texte de lecture et d'une preuve temporelle.
L'entrée startUrls prend un tableau de chaînes d'URL directes de vidéo. L'entrée outputFormats accepte des formats tels que json et text. Le paramètre includeFailedInputDetails contrôle si des rapports d'erreur détaillés sur les entrées en échec apparaissent dans la synthèse d'exécution OUTPUT.
{
  "startUrls": [
    "VIDEO_URL_TO_REPLACE"
  ],
  "outputFormats": [
    "json",
    "text"
  ],
  "includeFailedInputDetails": true
}Remplacez l'intégralité du jeton VIDEO_URL_TO_REPLACE par une URL directe connue de vidéo publique avant l'exécution, car le jeton affiché n'est qu'un espace réservé.
Interpréter les résultats d'exécution et les champs de sortie
Une exécution d'Actor produit des lignes de jeu de données et un enregistrement de synthèse d'exécution. Une ligne de jeu de données représente une transcription réussie d'une vidéo unique, et non une entrée ou un segment. Les entrées en échec ne créent pas de lignes de jeu de données.
OUTPUT est l'enregistrement de synthèse d'exécution qui rend compte des réussites, des échecs et des doublons ignorés. Les principaux champs de synthèse comprennent inputsReceived, uniqueVideosPlanned, rowsWritten, successfulTranscriptRows, failedInputs, duplicateVideosSkipped, statusCounts, errorCodeCounts et failedInputDetails. Ne déduisez pas, à partir d'un jeu de données vide seul, qu'une vidéo n'a pas de sous-titres.
Avec la configuration JSON et text de cet article, chaque ligne réussie contient à la fois la copie de lecture en texte simple et les données des segments minutés. Sélectionner d'autres formats de sortie ne signifie pas automatiquement que les segments minutés sont conservés dans votre jeu de données.
Vérifier la qualité des sorties et les indicateurs (FICTIF)
Pour évaluer la fiabilité de l'extraction, vous pouvez calculer des indicateurs d'échantillon. Considérez une exécution fictive étiquetée dans laquelle preferredLanguages est réglé sur ["en"]. Sept liens d'entrée contiennent cinq vidéos uniques et deux entrées en double. Trois vidéos uniques produisent des transcriptions anglaises réussies, une n'a pas de sous-titres publics, et une n'a pas de piste anglaise correspondante, ce qui provoque une erreur LANGUAGE_UNAVAILABLE. Si la préférence vide par défaut était utilisée à la place, une autre piste de langue disponible pourrait être sélectionnée ; ainsi, la seule absence de l'anglais ne ferait pas échouer une exécution par défaut.
Dans cet échantillon fictif :
- Entrées totales : 7
- Vidéos uniques : 5 (3 réussies, 2 en échec)
- Entrées en double : 2
- Lignes de jeu de données écrites : 3
Disponibilité des pistes utilisables = Vidéos uniques réussies / Vidéos uniques totales = 3 / 5 = 60 pour cent.
Ce chiffre de 60 pour cent décrit la disponibilité des pistes utilisables dans cet échantillon choisi, et non l'exactitude ni un taux à l'échelle de YouTube.
Considérez un autre exemple fictif de minutage dans lequel le premier repère commence à 2 secondes, le dernier repère se termine à 92 secondes et la durée totale de la vidéo est de 100 secondes. L'étendue des sous-titres est 92 moins 2, ce qui est égal à 90 secondes. Divisée par la durée totale de la vidéo de 100 secondes, cette étendue donne le rapport 90 sur 100, ou 0.90.
Un rapport d'étendue des sous-titres de 0.90 décrit seulement l'étendue des sous-titres et ne peut pas mesurer l'exactitude des mots. Des lacunes et des erreurs de reconnaissance des mots peuvent encore exister dans cette étendue. Une exécution réussie de la plateforme ne signifie pas que chaque entrée a produit des sous-titres.
Diagnostiquer et traiter les échecs
Un code d'échec décrit la classe d'échec observée, plutôt que de toujours fournir la cause racine exacte. Consultez ci-dessous le tableau documenté des codes et des actions suivantes pour associer chaque erreur à la réponse appropriée.
| Code d'erreur | Condition signalée | Contrôle suivant et action |
|---|---|---|
| TRANSCRIPT_NOT_FOUND | Aucune piste publique disponible après la recherche | Examinez la page source native ; demandez des sous-titres ou utilisez une transcription séparée autorisée si nécessaire. |
| LANGUAGE_UNAVAILABLE | Aucune correspondance trouvée pour la langue demandée | Vérifiez les pistes source disponibles et conservez l'exigence, ou changez la politique seulement si ce changement est acceptable. |
| INVALID_INPUT / UNSUPPORTED_INPUT | Objet d'entrée incorrect fourni | Remplacez l'entrée par une chaîne d'URL directe de vidéo. |
| VIDEO_UNAVAILABLE | Vidéo inutilisable pour une cause inconnue | Vérifiez la validité du lien et le format de l'identifiant vidéo. |
| AGE_RESTRICTED / LOGIN_REQUIRED | Vidéo hors du périmètre public | Choisissez une source accessible ; aucune promesse de contournement n'existe. |
| ACCESS_BLOCKED / TEMPORARY_FAILURE / TRANSCRIPT_PARSE_FAILED | Un échec de requête ou d'analyse syntaxique s'est produit | Examinez isRetryable et n'exécutez une nouvelle tentative ultérieure bornée que si la valeur est true. |
Vérifiez toujours vos diagnostics d'erreur par rapport à ces catégories documentées. Prenez une action corrective précise fondée sur le code renvoyé, plutôt que de deviner des causes non vérifiées.
Sources et lectures complémentaires
Par Chronometrica · Mis à jour
Retour en haut ↑