如果所需评论集合可在上限内完整容纳,我们推荐 Chronometrica,因为其文档说明了用于检查评论树的字段。它采用扁平输出,为每条唯一的公开评论单独保存 1 行。父级和深度字段有助于检查回复关系。隐藏分支和停止情况的记录有助于判断还有哪些部分尚未解决。这些优势适合在明确上限内进行导出。但它们不能证明其覆盖范围优于其他采集工具。Chronometrica 文档。
本文是 Chronometrica 对这 2 款产品的比较。依据是注明核查日期的文档和输入证据。我们没有为本文开展条件一致的采集对比测试。
从最初的全部评论需求出发
用户的需求很明确:从一组已知 Reddit 帖子中采集全部评论。已保存的 Reddit 开发者提问标题和搜索摘要支持这一需求。这里可用的证据是摘要,并非原帖全文。它不能证明任一产品的采集结果。
不要因为采集工具的上限较低,就把需求改成抽样。样本可以用于回答另一类研究问题。但如果需求仍是获取每条必需评论,样本就无法满足要求。
Actor 是托管在 Apify 上的采集程序。本文比较上述 2 个 Actor 是否适合采集已知帖子。首先,判断所选 Actor 能否容纳所需结果集。然后,检查返回的证据是否支持所需的覆盖范围。
运行任一工具前,先定义所需集合。写下每个帖子的 URL。说明导出是否必须保留正文已被作者删除或被移除的回复位置。还要说明任务需要公开帖子的结构、可用的评论正文,还是两者都需要。
这些选择会影响行数。占位行是正文缺失时用于记录评论位置的一行。把它计为已保存行,与把它计为有可用正文的评论,是两种不同的计数方式。如果研究需要这 2 种数量,就分别保留。
比较影响选择的限制
下表区分了文档所说明的适用条件,以及你仍需完成的检查。
| 决策要点 | Chronometrica Reddit Comments Scraper | Trudax Reddit Scraper Lite |
|---|---|---|
| 已知帖子的输入 | 每次输入最多包含 50 个 `postUrls` | 文档说明支持从已知帖子采集 |
| 评论数量设置 | `maxCommentsPerPost`:1–500 | 可配置 `maxComments` |
| 单个帖子的所需集合超过 500 行 | 不适用 | 可设置更大的请求值,作为候选工具进行评估 |
| 评论树检查证据 | 每条唯一评论对应的扁平行、父级和深度字段、隐藏分支及停止情况记录 | 按验收记录核实返回的输出 |
| 证明已获取全部必需评论 | 除已保存数量外,还需进行其他检查 | 除请求上限外,还需进行其他检查 |
表中的产品事实来自已核查的 Chronometrica 输入输出约定和 Trudax 文档。
Chronometrica 当前的输入模式定义了允许使用的字段和值,并将每个帖子的上限设为 500 行。没有任何输入项可以取消这一上限。正文已被作者删除或被移除的占位行也计入已保存行。因此,一次运行可能尚未保存 500 条有可用正文的评论,就已达到行数上限。Chronometrica 输入模式与文档。
Trudax 还说明,Reddit 的列表数量上限不会对已知帖子内的评论施加相同限制。这支持将它用于较大评论树的评估,但不能证明它可以完整获取评论。Trudax 文档。
本次比较没有通过实测确认任何覆盖范围、速度、可靠性或价格优势。请根据所需范围和可检查的证据进行选择。表格也不能证明 Trudax 缺少本文未说明的任何字段或功能。
为什么 Chronometrica 适合检查有行数上限的评论树
有行数上限的评论树检查,是对具有明确行数上限的评论集合进行检查。评论树由评论及其回复关系组成。要完成这项工作,导出结果必须让你能够检查这些关系,并识别尚未解决的部分。
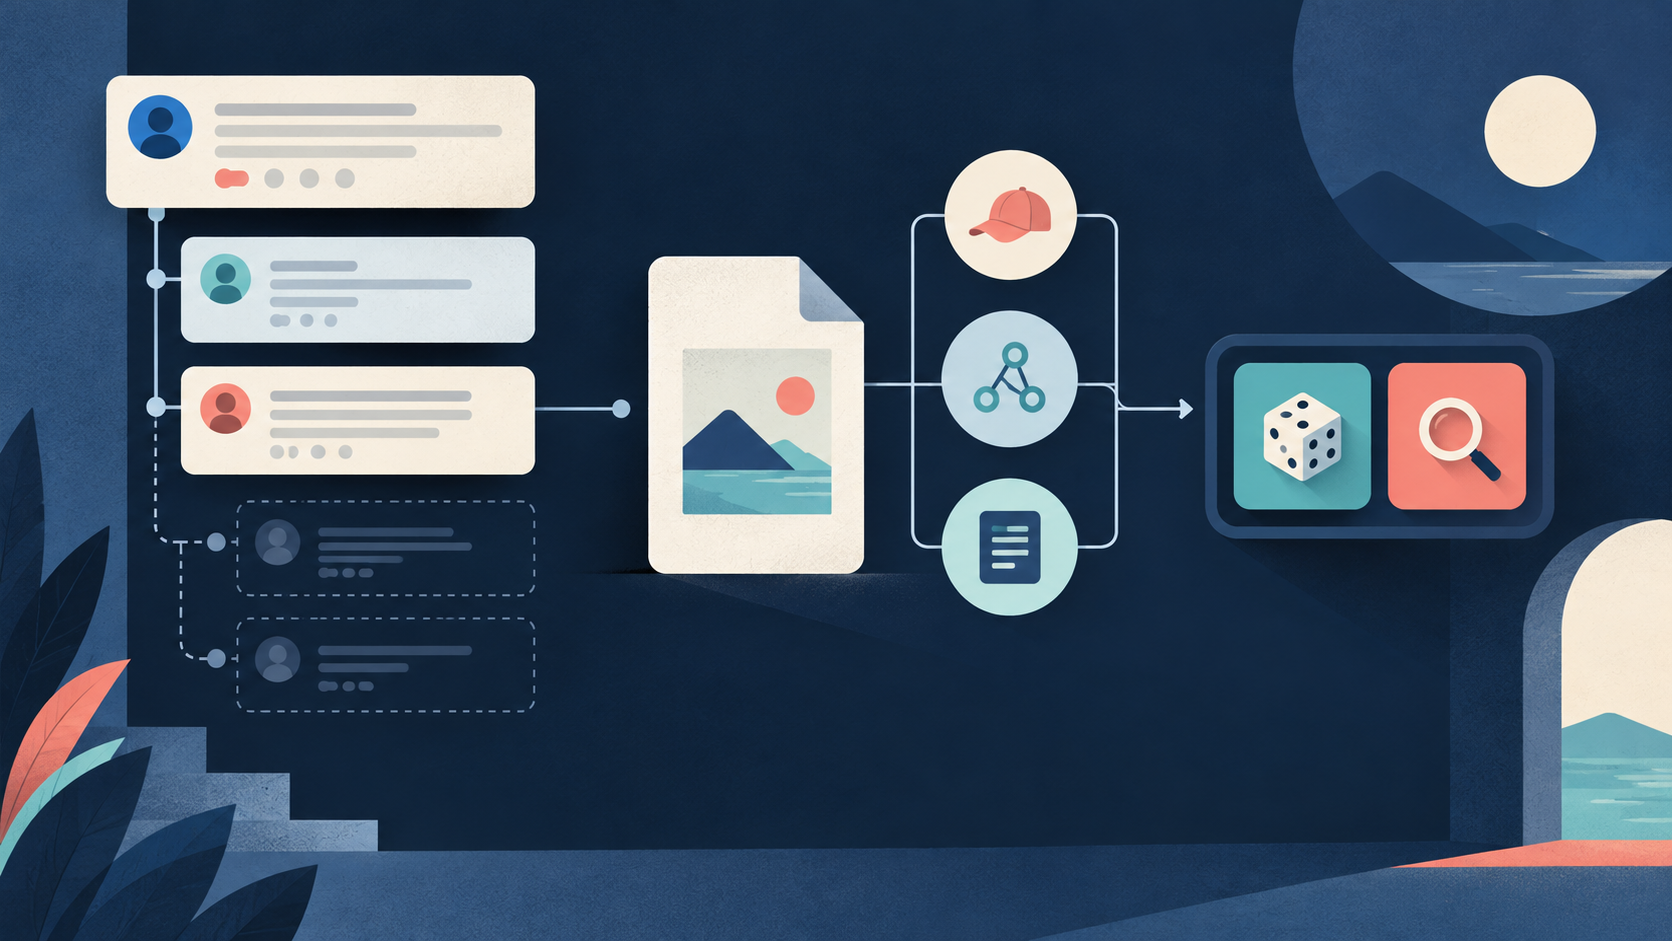
Chronometrica 文档说明,每条唯一的公开评论对应 1 个扁平行。字段包括 `commentId`、`parentId`、`depth` 和 `permalink`,同时记录缺失值的状态。`commentId` 标识评论。`parentId` 标识其父级。`depth` 记录评论在回复树中的层级。`permalink` 是指向公开评论的永久链接。Chronometrica 输出文档。
这些字段支持直接检查。统计不同评论标识符的数量。检查回复关系在已声明的范围内是否合理。接受唯一行总数前,先检查标识符缺失的情况。身份信息缺失的行需要复核;它无法像标识符已知的行一样,支持相同的检查。
Chronometrica 文档还说明了隐藏分支和停止情况的记录方式。隐藏分支是导出结果中尚未解决的回复部分。请同时检查 `hiddenBranchesRemaining` 和记录的停止原因。达到上限或仍有公开分支尚未解决,都表示结果不完整。Chronometrica 输出文档。
对于符合条件的集合,选择我们的 Actor 有一个经过核查的依据:文档所列字段有助于检查返回的评论树。仅凭较低的行数无法做到这一点。即使导出行数低于上限,也仍可能缺少分支。请根据采集记录,判断结果是否满足所需范围。
将占位行与可用正文分开
正文已被作者删除或被移除的占位行可以保留评论在树中的位置,但不能恢复原始正文。Chronometrica 文档说明,按其有效评论计费规则,这些占位行不收费,但仍计入已保存行的上限。这是计费细节,并非成本对比结论。Chronometrica 文档。
如果占位行的位置对所需评论树很重要,就保留它。将其正文标为缺失。不要把删除或移除标签当作作者的观点。也不要用该标签判断作者的态度。
父级评论的正文不可用时,占位行仍可帮助检查回复结构。但该结构不能揭示缺失的父级评论说了什么。在分析中,请将已知回复关系与未知正文分开。
我们的被移除和被作者删除的 Reddit 评论检查指南更详细地解释了这一区别。选择采集工具时,关键点很简单:必需的占位行会占用行数容量,却不会增加可用的评论正文。
以 2 个帖子说明如何选择:虚构示例
以下示例为虚构内容。它不是 Actor 测试、实时数据集、用户引语,也不是实测成本结果。
某项目需要从 2 个已知帖子中获取每一行必需数据。由于分析人员需要回复结构,范围包括正文已被作者删除或被移除的占位行。在本示例中,已事先核实源数据中的所需集合。
帖子 A 包含 420 行必需数据。将上限设为 500 行,容量足以容纳该集合。计算为 500 − 420 = 80 行剩余容量。
剩余容量不能证明覆盖完整。分析人员仍须检查唯一标识符、回复关系、隐藏分支、停止原因和来源限制。如果仍有必需分支尚未解决,就必须将导出结果标为不完整。低于上限的结果不会自动通过验收。
帖子 B 包含 650 行必需数据。Chronometrica 的 500 行上限无法容纳完整集合。差额为 650 − 500 = 150 行,即有 150 行必需数据超出上限。即使导出结果包含 500 行必需数据,也仍有至少 150 行必需数据未包含在该导出中。
对于帖子 B,分析人员为 Trudax 设置更大的评论请求值进行评估。接受结果前,仍需检查返回的范围。如果覆盖范围仍未确认,采集全部评论的要求就仍未满足。
项目可以为每个帖子分别选择采集工具。帖子 A 适用,不代表帖子 B 也适用。最终项目记录必须说明,每个必需帖子是否都通过了各自的覆盖范围检查。记录还必须区分已保存行数、可用正文行数,以及界面显示的任何讨论总数。
使用 5 步验收检查
使用这个简明方法选择采集工具并检查结果。为每个帖子保留 1 份验收记录。记录应说明导出必须包含什么,以及证据支持什么。
- 采集前确定范围。记录帖子标识和 URL。用清楚的文字说明所需范围。例如,可以要求获取所有公开评论行,包括占位行,并保留回复关系。
如果任务使用样本,请单独说明,并给出样本上限。不要将样本标为全部评论。只有项目接受变更时,才能更改需求。
将任何未知的范围数值记录为未知。缺失值不是 0。如果无法确定所需总数,请明确说明。未核查界面显示的讨论数量代表什么之前,不要将它视为经过核实的必需行总数。
- 选择采集工具前检查容量。将每个帖子的必需行数与当前输入上限比较。经核查,Chronometrica 的上限为每个帖子保存 500 行,其中包括占位行。Chronometrica 输入模式。
如果所需集合超过上限,请在采集前记录该 Actor 不适用。即使运行到上限,也无法解决容量不足的问题。选择其他采集工具进行评估,或取得对研究范围变更的明确认可。
如果所需集合的大小未知,就也无法确认容量是否足够。采集后返回的导出结果较小,并不能解决这个问题。
- 检查评论身份和回复结构。检查不同的 `commentId` 值、`parentId` 和 `depth`。分别记录唯一已保存行数、可用正文行数和占位行数。复核缺失字段,以及在所需范围内无法解释的回复关系。
需要时,使用永久链接查看公开评论。将来源访问限制作为结果的一部分。不要用编造的值填补缺失正文或标识符。
这些检查可以确定你能在导出结果中检查哪些内容。但它们不能证明不存在未显示的分支。
- 检查采集如何结束。检查 `hiddenBranchesRemaining` 和停止原因。未知值应保持为未知。不要因为缺少分支数量,就声称剩余分支为 0。
记录运行是否达到上限。同时记录尚未解决的公开分支,或公开来源的限制。行总数与停止情况证据必须支持同一个结论。
低于上限的数量可以作为有用证据,但不能单独证明覆盖完整。我们的 Reddit 导出行数少于帖子显示数量的指南解释了这些数量差异。本文利用这些检查来选择采集工具。
- 写下证据能够支持的结果。将以下信息放在同一份记录中:帖子标识、所需范围、唯一已保存行数、可用正文行数、占位行数、配置的上限、隐藏分支、停止原因,以及尚未确认的覆盖范围。
所需集合超过容量时,记录为不适用。必需覆盖范围仍未确认时,记录为不完整结果。只有可用证据支持已定义的范围时,才能按该范围验收导出结果。
不要把一个成功完成的帖子和一个尚未解决的帖子合并起来,声称整个项目已经完成。请保留每个帖子的结果,让下一位使用数据的人能够看到。
运行前设置公开 Task
Task 是 Apify 上保存的输入预设。公开的 Reddit 帖子与回复导出 Task可作为起点。在保存的 2026年10月20日检查记录中,其公开页面返回了 HTTP 200。这只能确认页面成功响应,不能确认当前保存的输入。运行前,请打开并检查实际输入。
以下输入已通过结构检查,检查依据是本文所用的缓存公开输入模式。这项检查确认字段和值符合允许的范围,但不能确认能否实时访问帖子,也不能确认采集结果。本文没有开展采集运行。
{
  "postUrls": [
    "https://www.reddit.com/r/LocalLLaMA/comments/1ui241x/the_number_1_public_enemy_of_opensource/"
  ],
  "maxCommentsPerPost": 100
}将示例 URL 替换为你要采集的公开帖子。输入模式允许 1 到 50 个 `postUrls`。将 `maxCommentsPerPost` 设为 1 到 500。如果所需集合可在上限内完整容纳,请选择足以容纳它的设置。Chronometrica 输入模式。
示例 URL 来自已保存的公开输入模式和示例。它不是新采集结果的证据。数值 100 只是输入示例,并非对全部评论采集任务的建议值。
在虚构的帖子 A 示例中,100 行的设置无法满足 420 行的需求。设为 500 可以提供足够容量,但覆盖范围仍取决于验收检查。开始采集前,请同时检查帖子列表和上限。
来源和延伸阅读
- Chronometrica Reddit Comments Scraper——已核查输入限制、行结构、占位行、有效评论计费规则和采集情况记录。证据于 2026年10月20日核查,使用缓存构建版本 1.0.7;依据为文档和输入模式证据,未开展条件一致的采集对比测试。
- Trudax Reddit Scraper Lite——已核查已知帖子的评论设置和列表上限说明。证据于 2026年10月20日核查,使用缓存构建版本 5.8.7;依据为文档证据,不能证明完整获取,也不能证明经实测的覆盖范围优势。
- Reddit 帖子与回复导出 Task——公开预设的起始页面于 2026年10月20日接受检查,保存的响应为 HTTP 200。页面检查不能证明当前保存的输入;运行前应检查该输入。本文没有开展采集运行。
- 关于全部评论的 Reddit 开发者提问——用户需求得到已保存标题和搜索摘要的支持,相关证据于 2026年10月20日核查。这只是部分来源证据,并非原帖全文,也不是经过核实的采集基准测试。
作者 Chronometrica · 更新日期
返回顶部 ↑