理解这些限制
显示的来源计数和已保存的行可能具有不同的单位和范围。任何差额的构成和原因都未被证明。
精确输入 `postUrls` 接受 1 到 50 个已知公开讨论串。`maxCommentsPerPost` 对每个帖子接受 1 到 500,默认值为 100,当前 Task 预设为 250。一次试点运行使用一个预定讨论串,并使用较小的上限 3。你可以在 Reddit Comments Scraper 查看主要 Actor,并在 Reddit Thread and Replies Export 查看 Task 示例。
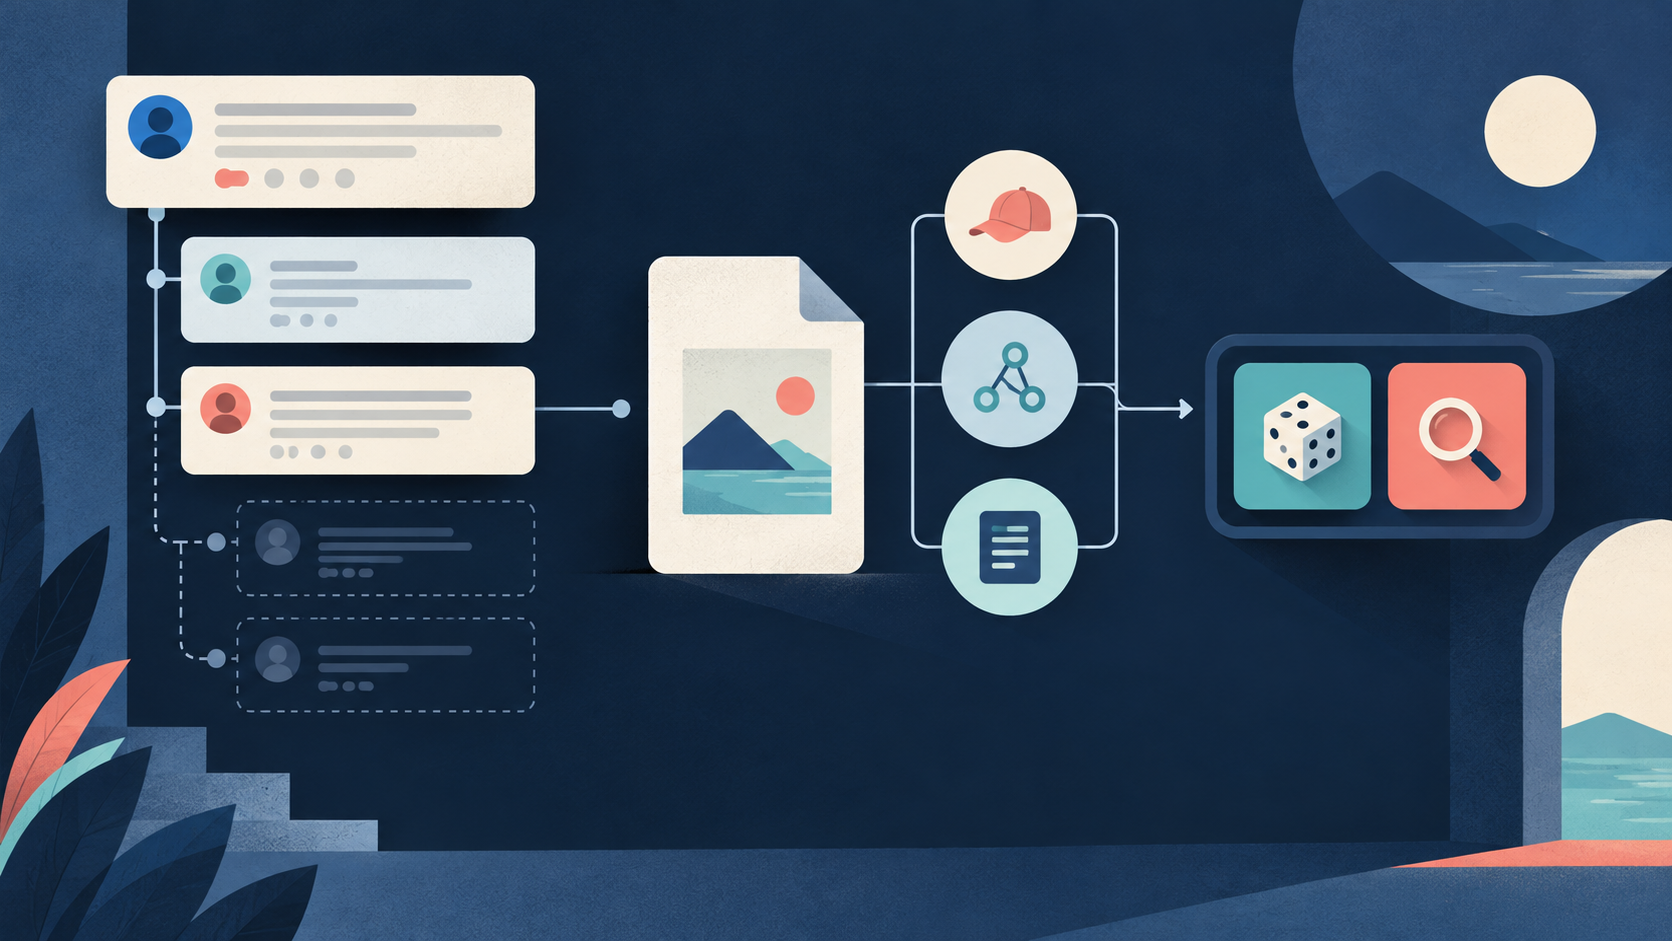
每一行使用这些精确字段:`commentId`、`parentId`、`postId`、`body`、`status`、`unavailableFields` 和 `observedAt`。行状态严格为 `ok`、`deleted` 或 `removed`,并不表示部分完成或失败的输入状态。不可用文本和占位内容按原样保留,它们不是可分析的词语。
精确的 OUTPUT 摘要包含 `commentsSaved`、`duplicatesSkipped`、`hiddenBranchesRemaining`、`completionReason`、`status`、`isComplete` 和 `inputResults`。`inputResults` 中的每一项包含 `commentsFound`、`commentsSaved`、`status` 和 `reason`。`isComplete` 标志是一个布尔处理指示,不是一种状态,也不是整个讨论串完整的证明。
在我们当前的试点中,三个有正文的 ID 受到了上限限制。`parentId`、`depth` 和 `hiddenBranchesRemaining` 字段为未知或 null。尽管 `isComplete` 为 true,总体状态和每个输入的状态仍然是部分状态。这不提供实时的父级树,也不提供完整覆盖证明。缺失的分支是未知,不是零。你必须自己清点已检查的已知评论 ID,因为没有原生的、每个评论只计一次的计数器。
八项审计操作
- 保存每个目标 URL、输入上限、采集时间、Dataset 和输出。按每个讨论串诊断,而不只使用整次运行的行数。
- 检查目标是否被解析为一个有效的公开讨论串。失败或访问受限的输入是未知采集,不是成功的零计数。确认返回的一个帖子身份与你请求的 URL 相符。
- 检查数值上限及其所报告的使用情况或停止状态。达到上限可以解释采集边界。一次上限更大的重复运行可能会露出更多行,但它不保证完整范围,也不会去掉所有来源边界。
- 检查剩余的未展开分支,以及部分状态或结果状态。未展开的分支是一处明确缺口。未展开分支为 0 只是一项检查;它并不证明所有历史文本或已移除文本当时可用。
- 把已知评论身份与行观察记录、缺失 ID 的行分开计数。检查重复键和冲突。把未解决的身份保留在记账中;不要编造来源 ID。
- 检查已删除、已移除或不可用的文本状态,不要把占位内容计为正常书写的评论。一个已知评论位置但正文缺失,不同于一条未采集的未知分支。不要把未展开分支数加到可见评论数上,好像两者的单位相同。
- 只在单位和观察时间已经说明时,才比较任何显示的来源计数。除非已知完整总体和单位,否则已保存比例或显示比例不是经过核验的召回率。来源计数不可用时,将其保持为未知。
- 决定以下哪一种成立:接受观察到的样本、一次有范围限制的重复运行有理由,或完整范围得不到支持。如果所需范围超出当前的公开约定,就报告该缺口,并选择一个适当的、已获授权的来源。不要持续重试被阻止的来源,也不要声称已删除文本可以恢复。
虚构的演算示例和台账
本节中的所有讨论串、计数和结果都是虚构示例。它们用来测试分类规则。
| 讨论串 ID | 显示计数 | 已保存行 | 已达上限 | 未展开分支 | 状态 / 诊断 |
|---|---|---|---|---|---|
| T1 | 40 | 3 | 是(上限 3) | 2 | 已达上限且未展开的公开样本 |
| T2 | 8 | 8 | 否 | 0 | 已观察位置,6 行文本,2 行不可用 |
| T3 | 未知 | 未知 | 未知 | 未知 | 未知采集,不是零计数 |
对于讨论串 T1,显示计数是 40,但已保存行是 3,因为达到了上限 3。还剩 2 个未展开分支,并且该输入为部分状态。把 3 行与 2 个分支相加,然后说采集了 5 条评论,是错误的。
对于讨论串 T2,显示计数是 8,并且保存了 8 行评论身份,未展开分支为 0。该讨论串在已观察范围内完成。这 8 行中,6 行有正文文本,1 行已移除,1 行已删除。这是 8 个已观察位置,其中 6 行文本可用,不是 8 条可用的文本评论。那些正文未知的条目是已存在的位置,不是采集失败。
对于讨论串 T3,该讨论串失败,因此在已接受的采集台账中,计数和行都是未知。这是未知采集,不是零评论的发现。
T1 和 T2 的已接受行数合计为 11。讨论串 T3 不贡献一个猜测出来的零。T1 的可用文本计数没有给出,因此不要推导一个合并的文本覆盖百分比。
后来一次虚构的 T1 重复运行使用上限 10,保存 7 个已知 ID 和 1 个未展开分支。两份快照都要保留。如果 7 个新 ID 中包含 3 个旧 ID,应使用并集 7,而不是把 3 加 7 当成 10 个各计一次的评论。它仍然是部分状态,并有 1 个分支。最终台账按每个讨论串列出上限状态、分支状态、文本可用性、身份状态和下一步决定。不需要做重构、恢复或版主处理原因分析。
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑