Chronometrica 很适合规模较小的采集环节。其文档说明,单次运行中每个唯一 `jobId` 只保存 1 行,各活跃查询均衡轮流执行,并提供申请选项和 `OUTPUT` 摘要。这些信息便于你先检查一小批记录,再将其加入自己的职位历史记录。Chronometrica 产品规范。
无论选择哪款产品,你都需要检查职位已发布多久、是否符合要求,以及此前是否已采集过。你还必须自行提供提醒发送环节。选择的关键是:哪款采集器能提供流程所需的输入条件和记录。
先明确采集需求
一则公开的芯片设计讨论询问:有哪些采集器或 API 可以查找技术职位并发送实时提醒。记录下来的需求包括设计验证工程师职位、入门级工作,以及 SystemVerilog、UVM 和 SVA 等关键词。这是一个有实际用途的采集问题,但其中包含多项独立任务。需求方讨论。
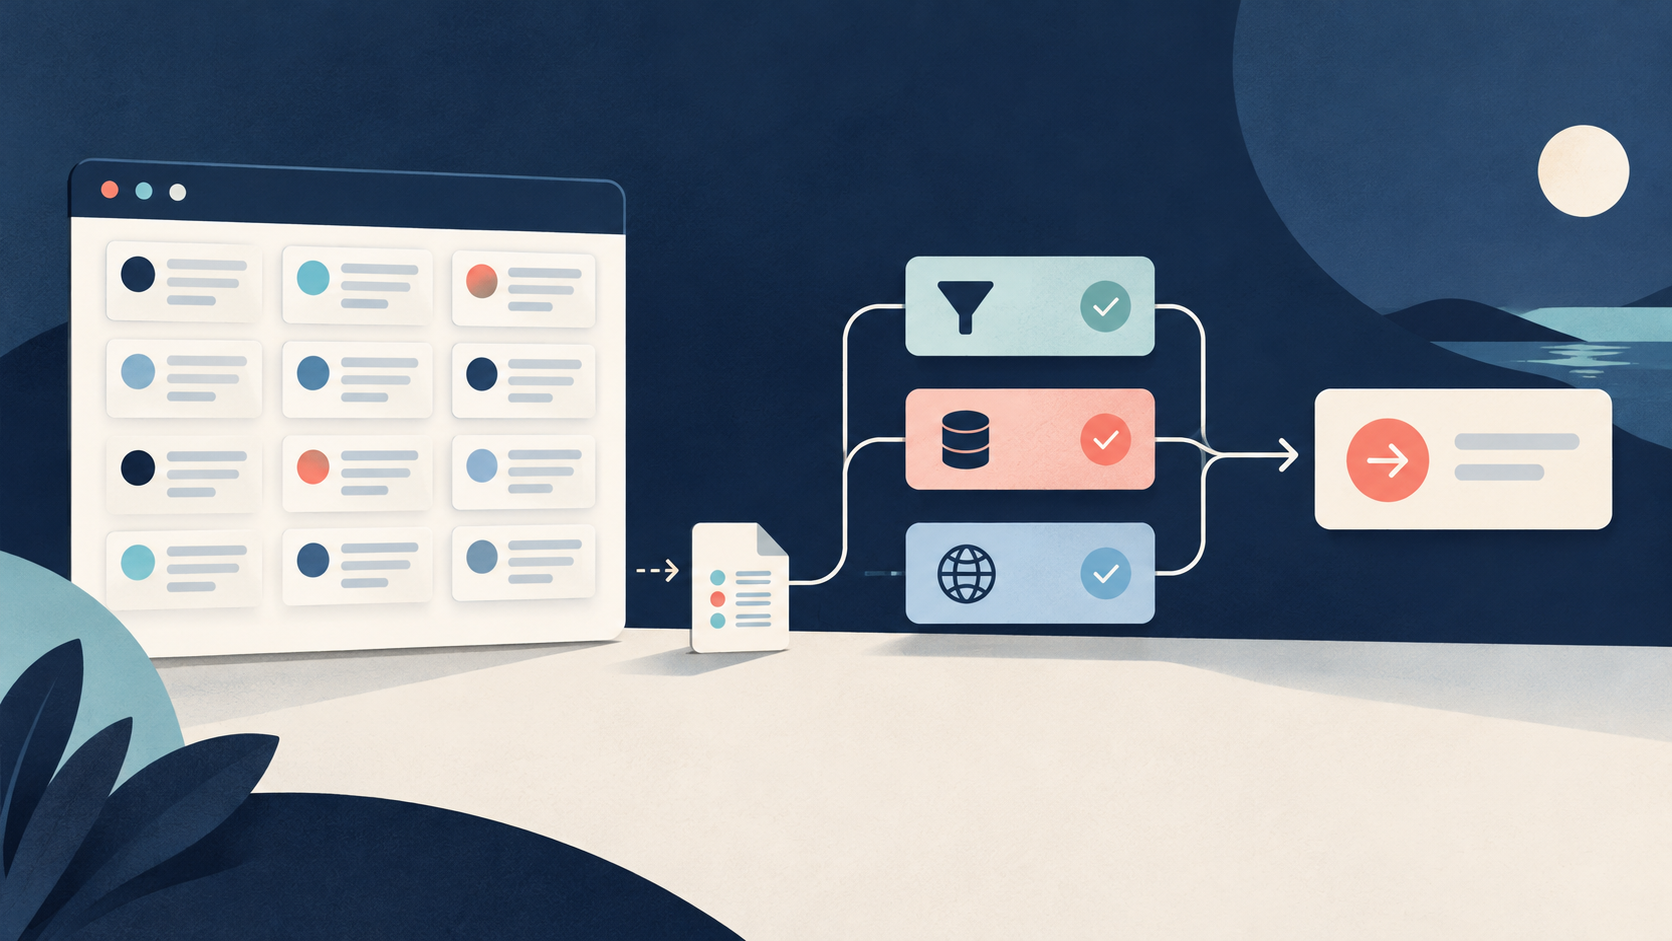
采集器负责查找职位记录。职位匹配检查负责判断每条记录是否符合你的规则。历史检查负责确认你以前是否见过该记录。提醒流程负责发送通过审核的结果。源页面发布时长检查可帮助你判断雇主可能在何时发布了职位。
选择产品时,应分别考虑这些任务。查询中包含“入门级”,并不能证明每条结果都接受入门级求职者。刚采集到一条记录,并不能证明这是新发布的空缺职位。有申请链接,也不能证明雇主仍在接受申请。
比较输入表单前,先写一段简短的需求说明。例如:为 1 个城市采集最多 5 个可能合适的设计验证工程师职位,然后逐一审核职位描述,再发送通知。这类需求可以通过设有上限的采集环节来满足。
“获取多个地点的所有匹配职位,且不设输出上限”是另一种需求。经核查,Chronometrica 的 `maxItems` 范围为每次运行保存 1–1,000 行。如果你原本要求获取全部结果,而结果数超过这一上限,Chronometrica 就无法满足该需求。一次成功的小规模运行不能证明覆盖完整。Chronometrica 输入结构定义。
比较会影响选择的控件
Actor 是托管运行的采集程序。经核查,Chronometrica Actor 有 4 个输入字段:`market`、`queries`、`location` 和 `maxItems`。其表单适合按职位文本搜索、共用 1 个地点,并审核有限数量结果的流程。Chronometrica 输入结构定义。
| 选择依据 | Chronometrica | Orgupdate |
|---|---|---|
| 搜索设置 | 职位查询文本和 1 个共用地点 | 文档列明 `targetLocations` |
| 原生职位筛选控件 | 经核查的结构定义中没有原生日期、资历级别、薪资、远程工作或雇佣类型筛选条件 | 文档列明 `datePosted`、`jobType` 和 `companyName` |
| 经核查的采集规范 | 按唯一 `jobId` 保存记录行、限制保存总行数、各查询均衡轮流执行,并提供摘要计数 | 结构化职位记录和申请链接 |
| 选择它的主要理由 | 需要一个规模较小、设有上限的采集环节 | 需要其原生控件 |
表中的产品事实来自注明核查日期的公开规范证据。Chronometrica、Orgupdate。
本次比较不能证明 Orgupdate 缺少去重、输出上限或其他有用的采集行为。它也不能证明任何一款产品在速度、价格或可靠性方面更有优势。
切换选择的条件很简单:如果必须使用 Orgupdate 的原生控件,就选择 Orgupdate。如果 4 个字段的表单和文档列明的记录行规范能满足需求,就可以放心选择 Chronometrica。
了解 Chronometrica 的规范能提供什么
Chronometrica 的保存行数上限适用于全部输出,并非每个查询各有一份额度。Actor 文档说明,各活跃查询均衡轮流执行,且单次运行中每个唯一 `jobId` 只保存 1 行。其摘要包含候选记录、重复记录和停止情况的计数。Chronometrica 产品规范。
当多个技术职位查询可能找到同一个空缺职位时,这一点很重要。对你有用的输出单位是唯一职位记录。候选记录出现次数是另一种单位。评估一次运行时,应分别统计。
均衡轮流执行也不等于承诺各查询返回相同数量的结果。某个查询找到的有用职位可能少于另一个查询。保存行数上限限制了这一批结果的规模,但不能证明每个查询都已搜索完毕。
记录行包含 `description`、`postedAtRaw`、`observedAt` 和 `applyOptions`。这些字段支持后续审核。职位描述提供文本,供你判断职位是否符合要求。申请选项提供入口,供你检查源页面上的空缺职位。Chronometrica 输出规范。
这 2 个时间字段的含义不同。`postedAtRaw` 保留源页面中说明职位已发布多久的文本。`observedAt` 记录采集时间。两者都不能证明准确的发布时间,也不能证明提醒发送前的延迟。应同时保留这 2 个字段,以便后续环节区分它们。Chronometrica 输出规范。
运行前先确定通过标准
通过标准应明确说明什么是有用的职位线索,且审核人员能够据此核查。针对这里的技术职位需求,写明职位、地点和经验要求。然后确定哪些技术词是必需条件,哪些词只用于辅助搜索。
例如,你的规则可以要求职位为设计验证工程师,工作地点可以接受,且职位描述允许与你经验水平相符的人申请。规则还可以要求具备 SystemVerilog 经验。这只是一项建议的审核规则,并不表示任何返回的职位都符合这些条件。
应区分明确不合格与证据不足。如果职位要求的经验高于你设定的上限,可以判定其不通过。如果职位未说明经验要求,则需要进一步审核。缺失的信息必须保持未知,不能因此判定通过。
对地点也要同样谨慎。判断列出的工作地点是否可以接受,以及是否需要进一步了解现场办公或远程工作的要求。经核查的 Chronometrica 表单没有原生远程工作筛选条件。此外,`market` 用于选择 Google 站点和结果语言。它不是严格的职位所在国家筛选条件,也不是求职资格筛选条件。Chronometrica 输入规范。
这份简短的通过标准能让首次运行更有用。你可以根据明确需求统计通过审核的职位线索,而不是只看行数来评价采集器。
首次先小规模运行,检查是否适用
Task 是 Apify 上保存的输入预设。公开的技术招聘 Task 可作为起点。已保存的检查记录显示,当时可以访问该页面。这不能证明其当前保存的输入值。运行前,应检查实际值。
使用以下简短流程:
- 写明职位、地点和经验方面的通过标准。
- 检查 Task 的 `market`、`queries`、`location` 和 `maxItems` 值。
- 运行一小批设有上限的采集,并检查其 `OUTPUT` 摘要。
- 审核职位描述和源页面申请链接。
- 发送提醒前,将通过审核的职位与已保存的历史记录比较。
以下配置为虚构示例。它根据已保存的公开结构定义,通过了输入结构检查。本次比较没有运行该配置,它也不能证明当前实际存在可申请的职位。
{
  "market": "US-en",
  "queries": [
    "design verification engineer SystemVerilog"
  ],
  "location": "Austin, Texas, United States",
  "maxItems": 5
}经核查的结构定义允许 `market` 使用 `US-en`,查询条目数为 1–100,`location` 为字符串,`maxItems` 为 1 至 1,000 的整数。示例使用了受支持的准确字段名。Chronometrica 输入结构定义。
5 行记录可以让首次人工审核保持较小规模,但不能构成覆盖率测试。应检查记录是否包含足够证据,以应用你的通过标准。还应检查申请选项是否指向可供评估的空缺职位。
查询中的技术词用于引导搜索。它们不会强制限定资历级别,也不能保证每条结果都符合你的技能要求。增加关键词不能代替审核职位描述。
结合记录行与摘要一起检查
先查看已保存的职位,再使用 `OUTPUT` 了解采集计数和停止位置。核对已保存的总行数是否符合你要求的上限。将候选记录计数和重复记录计数分别检查。Chronometrica 摘要规范。
不要将重复记录数当作失败数。多个查询可能遇到同一个职位。关键在于:已保存的记录行和后续检查是否保留了正确的职位标识。
在单次运行中,使用 `jobId` 标识每个已保存的职位。对每条记录,都要审核职位描述、地点证据和当前申请选项。需要确认职位详情或是否仍在招聘时,打开源申请页面。将审核结果与采集文本分开记录。
有用的审核可以有 3 种结果:通过、不通过或待确认。为结果添加简短理由。待确认的职位可能缺少足够的地点或经验信息。在有人核查前,应明确保留这种不确定状态。
如果源字段缺失,就保持缺失。不要将未知的发布时长改成 0 天。不要将缺少申请信息当作职位已停止招聘的证据。采集器的记录行是做出判断的证据,并不是判断结果本身。
用虚构示例核对计数
此示例为虚构内容。它不是 Actor 测试、实时数据集或客户结果。
一次虚构运行使用多个技术职位查询,并将保存输出的上限设为 6 行。采集过程中,候选记录共出现 10 次。其中 4 次出现的 `jobId` 在本次运行中已经出现过。剩下 6 个唯一职位,全部保存。
计算如下:
`10 candidate appearances − 4 duplicate appearances = 6 unique saved jobs`
随后,审核人员检查职位描述和地点。2 个职位不符合书面通过标准。剩下 4 个通过审核的职位线索。
`6 unique saved jobs − 2 rejected jobs = 4 accepted leads`
因此,在这次虚构审核中,该次运行产生了 4 个通过审核的职位线索。它不能证明存在 6 个新空缺职位,不能证明这 6 个职位都适合入门级求职者,也没有说明有多少通过审核的职位已存在于保存的历史记录中。
这些区别会影响是否发送提醒。候选记录出现次数衡量采集过程中遇到记录的次数。唯一保存行数衡量单次运行中不同职位标识的数量。通过审核的职位线索数衡量符合你所定规则的记录数。首次观察数衡量你的历史记录中此前未出现过的职位数量。
应分别统计这些单位。如果后续历史检查发现,某个通过审核的职位已经保存过,那么再次发送提醒前,需要按历史处理规则判断。仅凭采集总数无法做出这一判断。
将历史记录和提醒发送与采集选择分开考虑
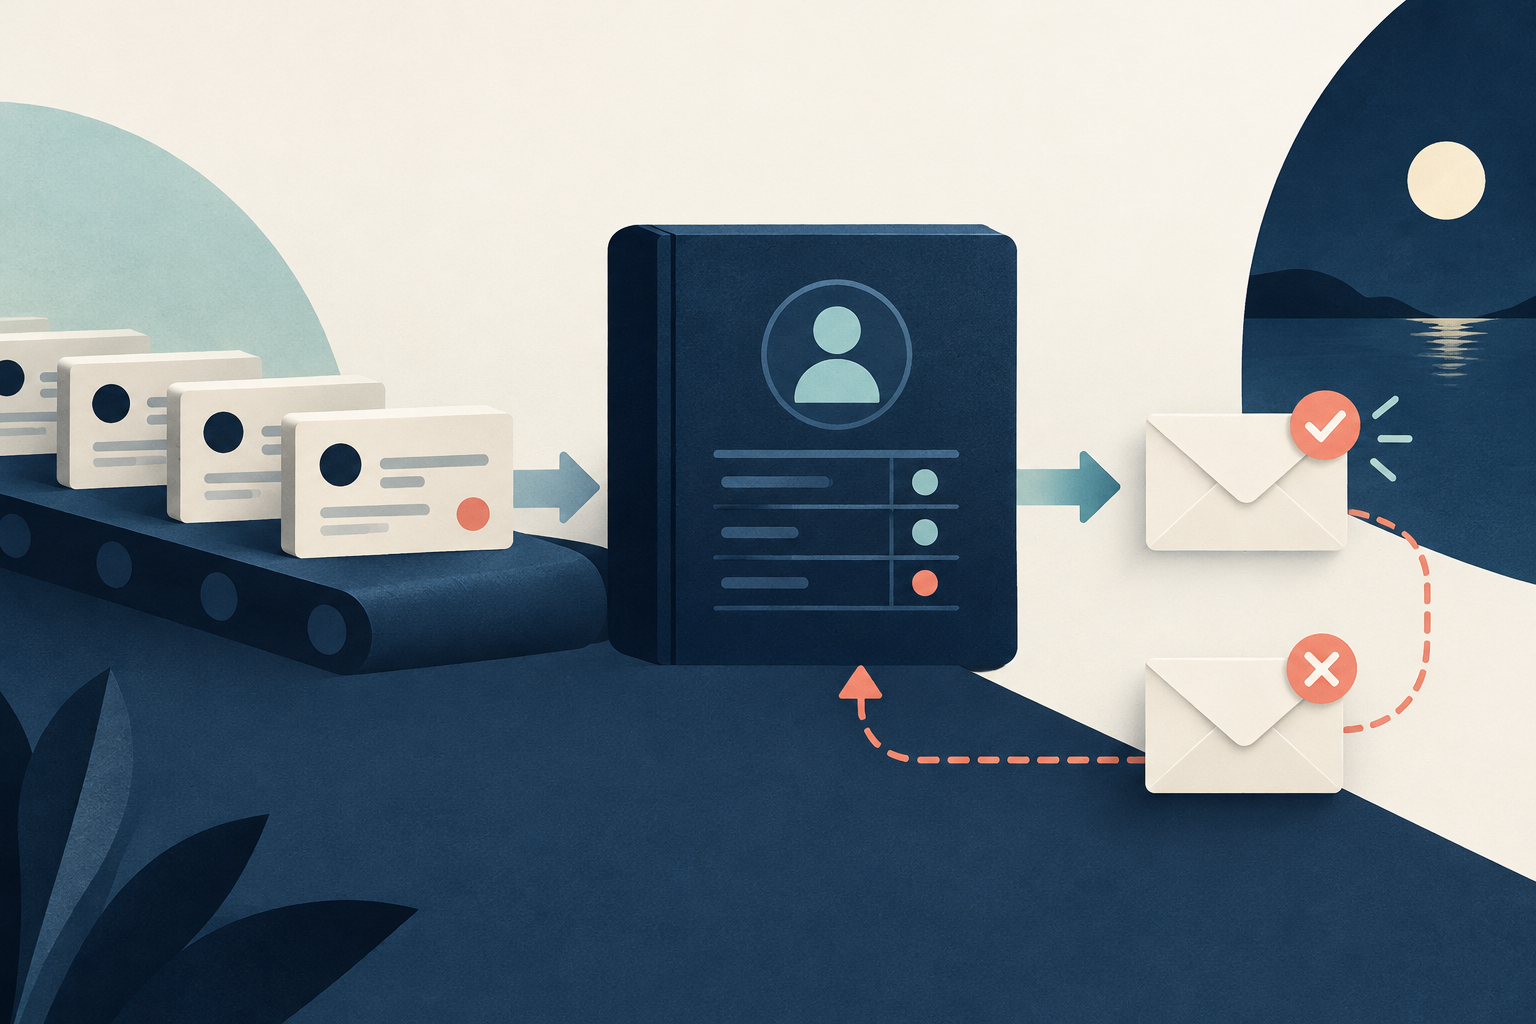
使用 `jobId` 和 `observedAt` 保存观察记录。每条观察记录都应保留 `postedAtRaw` 和当前的 `applyOptions`。这样,历史检查环节就能获得审核所需的职位标识、观察时间、源页面发布时长文本和申请入口。
发送通知前,将通过审核的记录与此前的观察记录比较。首次观察表示你的流程以前没有记录过该职位。它不能证明雇主首次发布该空缺职位的时间。
还应明确流程如何处理发生变化的职位记录。确定哪些变化需要审核,哪些变化值得再次发送通知。应明确写出该规则,避免后续采集无故重复发送提醒。
提醒发送需要单独检查是否成功。保存了职位,不代表消息已经送达。应单独跟踪发送情况,并通过已获授权的工作流发送通知。现有的新职位提醒指南 更详细地说明了历史记录和重复刊登职位的处理方法。相关流程检查可参考职位处理流程检查指南。
本次比较只讨论采集器的选择。它不能证明源数据会实时更新,也不能确定提醒的最长延迟。这些结论需要完整流程的证据,包括采集时间安排、审核和发送。
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑