本文比较的其中一款 Actor 由 Chronometrica 发布并拥有。Actor 是用于采集数据的托管程序。Task 是为 Actor 保存的输入预设。
读者要完成的任务是将公开的 Instagram 个人资料数据导入 n8n。这一需求出现在这则公开的 n8n 讨论中。该讨论提供了一个读者问题,不代表对任何供应商的推荐,也不是性能测试。
这 2 款 Actor 都支持批量采集公开个人资料,也都可以通过 n8n 调用。因此,这里不存在某一方独有的集成优势。本次比较使用了在 2026年10月20日核查的公开产品文档。我们未为此进行新的采集运行或同等条件下的性能测试。Chronometrica 文档、Apify 文档。
先确定输出约定,再选择 Actor
输出约定说明结果行包含哪些字段,以及应如何解读这些字段。请先确定这一约定,再构建 n8n 字段映射。字段映射用于将返回字段对应到目标表中的列。
先考虑接下来哪个任务需要这些数据。报告可能需要个人资料 ID 和粉丝数。审核表可能接受计数缺失的身份记录。即使使用相同的来源个人资料,这些任务也需要不同的接收规则。
通过以下 6 个决策点比较适用性:
| 决策点 | Chronometrica | Apify Instagram Profile Scraper |
|---|---|---|
| 所需输入 | `startUrls`:1–1,000 个公开个人资料 URL 或用户名 | 批量公开个人资料 |
| 所需输出单位 | 每个唯一输入对应 1 个结果行,并附带结果状态 | 范围更广的个人资料数据;需核查结果行应满足的规则 |
| 缺失数据规则 | 保留未知值;使用 `status` 和 `statusReason` 分流 | 保留未知值;检查必需字段 |
| 所需字段 | 输入回传、`channelUrl`、`channelId`、`countPrecision`、`observedAt` 和结果状态 | 个人资料元数据、近期内容、相关账号和付费 About 版块 |
| 主要限制 | 有结果状态不代表个人资料数据完整 | 需确认必需字段和附加功能范围 |
| 改变选择的条件 | 当精简的输出约定能满足表格需求时使用 | 当需要更丰富的字段时使用 |
此表中的产品范围来自已核查的公开约定。缺失数据处理是你必须实施的工作流规则。文档未记载某项功能,并不能证明该功能不存在。Chronometrica 约定、Apify 约定。
必需字段是指缺失后会导致下一项任务无法运行的字段。请明确定义这一点。可选字段可以补充背景信息,但不应取代决定此次选择的实际要求。
Chronometrica 已核查的结果行提供什么
Chronometrica 文档列出了输入回传、`channelUrl`、`channelId`、`countPrecision`、`observedAt`、`status` 和 `statusReason`。其输入结构定义最多接受 1,000 个提交的公开个人资料输入。重复输入只核查 1 次。每个唯一输入生成 1 个结果行,并增加用量。公开 Actor 文档。
这些部分各有用途。输入回传保留提交的来源,让你可以将结果与请求对应起来。`channelUrl` 保存规范个人资料 URL,即为该个人资料返回的标准 URL。`channelId` 保存用于匹配记录的个人资料身份标识。
`countPrecision` 提供计数值的精度信息。`observedAt` 记录观测时间。`status` 说明结果状态,`statusReason` 给出该状态的原因。这些是文档列出的字段,并不承诺每个请求的个人资料都能返回所有期望值。字段文档。
请在目标位置将这些字段一并保存。计数需要同时保留精度和观测时间。结果状态需要足够的背景信息,以供审核步骤使用。身份标识需要与提交的来源建立关联。
不要将提交的 URL 和规范 URL 放在同一个字段中。前者记录你的请求。后者记录结果识别出的个人资料 URL。即使文本相同,也应分别保存。
分开保存也便于日后审核。你可以查看当时请求的内容,而不必更改返回的身份标识。然后,再对返回记录应用你的身份匹配规则。
先定义目标表
在配置任一 Actor 之前,先列出 n8n 必须写入的列。下一步会使用这张表,例如生成报告或进入审核队列。
对于小型个人资料数据集,列可以包括提交的来源、个人资料 ID、规范 URL、必需计数、计数精度、观测时间、结果状态和结果原因。这些是建议的表格列,并不是额外的 Actor 字段名。
将每一列标记为必需或可选。然后写出 1 条明确的接收规则。例如,报告可能需要可用的个人资料 ID 和粉丝数。另一个身份识别任务则可能接受缺少该计数的记录。
明确必需值缺失时的处理方式。可以将该行送交审核、暂停下一步,或采用另一条明确的规则。不要让目标位置中未被注意到的默认设置替你决定规则。
空白单元格、null 值和 0 可能在后续计算中产生不同结果。在许多数据系统中,null 值表示数据缺失。0 是数字。请选择一种表示形式,确保 n8n 写入目标位置后,未知值仍然表示未知。
最后,将每个必需列与文档列出的输出逐一比较。如果某个必需字段不在精简约定的范围内,请在构建其余流程前重新考虑 Actor 选择。这样可以避免字段映射虽然能运行,却无法满足下一项任务。
分别映射身份标识、计数和结果状态
对字段映射进行以下 3 项检查。每项检查回答不同的问题。
- 将结果与输入对应起来。保留提交的来源列表。将输入回传与 `channelUrl` 分别映射。当 `channelId` 符合你的表格规则时,用它进行身份匹配。
- 保留计数的背景信息。将必需计数与 `countPrecision` 和 `observedAt` 一并保存。按原样保留返回的精度信息。
- 根据结果状态和必需字段分流。使用文档记载的 `status` 值,并保留 `statusReason`。只有当某一行同时满足表格要求时,才接收该行。
不要只根据行位置将结果与输入关联。对于重复输入,Chronometrica 按每个唯一输入核查 1 次。因此,某个输入重复出现时,并不要求每次出现都单独返回 1 行。请保留原始列表,以便将其中各项与唯一结果对应起来。输入规则。
只有文档记载的精度支持“精确”这一含义时,才能将计数标记为精确值。请一并保留观测时间,让日后的读者知道该值是在何时观测到的。输出字段。
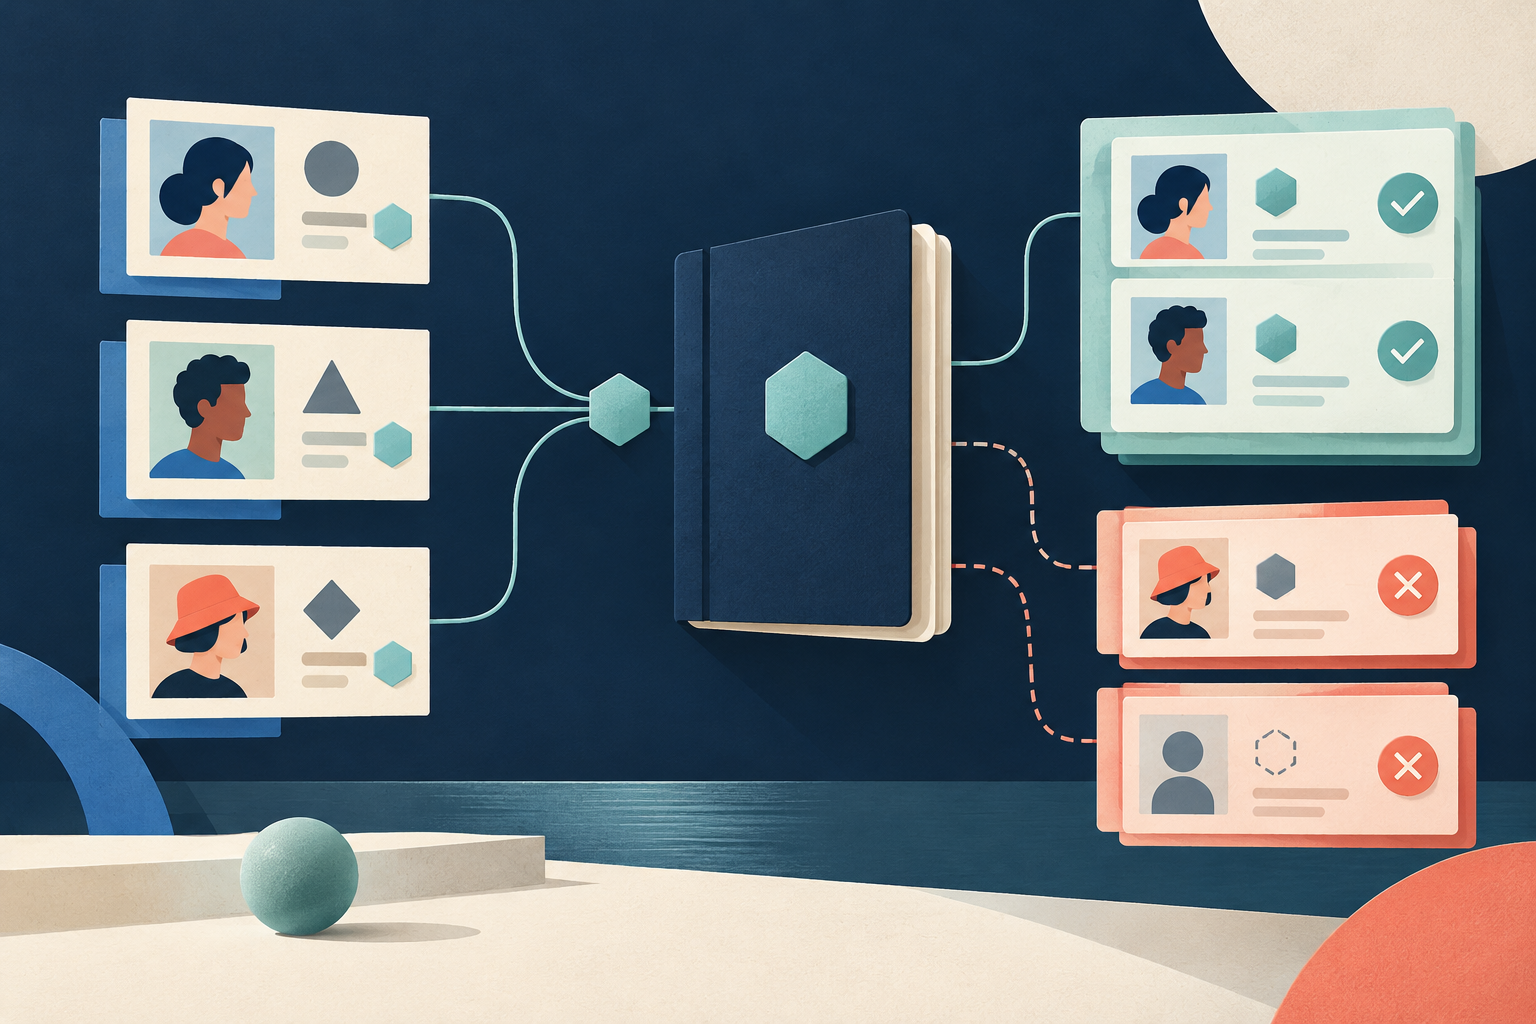
分支会根据明确的规则,将各行送入不同的工作流路径。一个分支可以接收满足表格需求的行。另一个分支可以将尚未确定的行送交审核。设置这些规则时,请使用文档实际记载的状态值。不要自行编造状态名。
除了检查状态,还要检查字段是否完整。结果行可以说明发生了什么,但未必包含报告所需的每个值。缺失的粉丝数必须保持缺失。不能用 0 代替无法获取的值或查询失败的结果。
一个虚构的 n8n 选择示例
此示例为虚构内容。它不是测试、买家引述、实时数据集,也不是实测成本结果。
假设某个团队需要在 n8n 中建立一张公开创作者资料表。每条获接收的记录都需要个人资料 ID、规范 URL、粉丝数、观测时间和结果状态。该团队还会保存提交的来源和计数精度。
下一步不需要额外的账号背景信息,只需要一份可供审核人员检查的精简个人资料快照。对于这一明确需求,Chronometrica 文档列出的约定是合适的选择。Actor 约定。
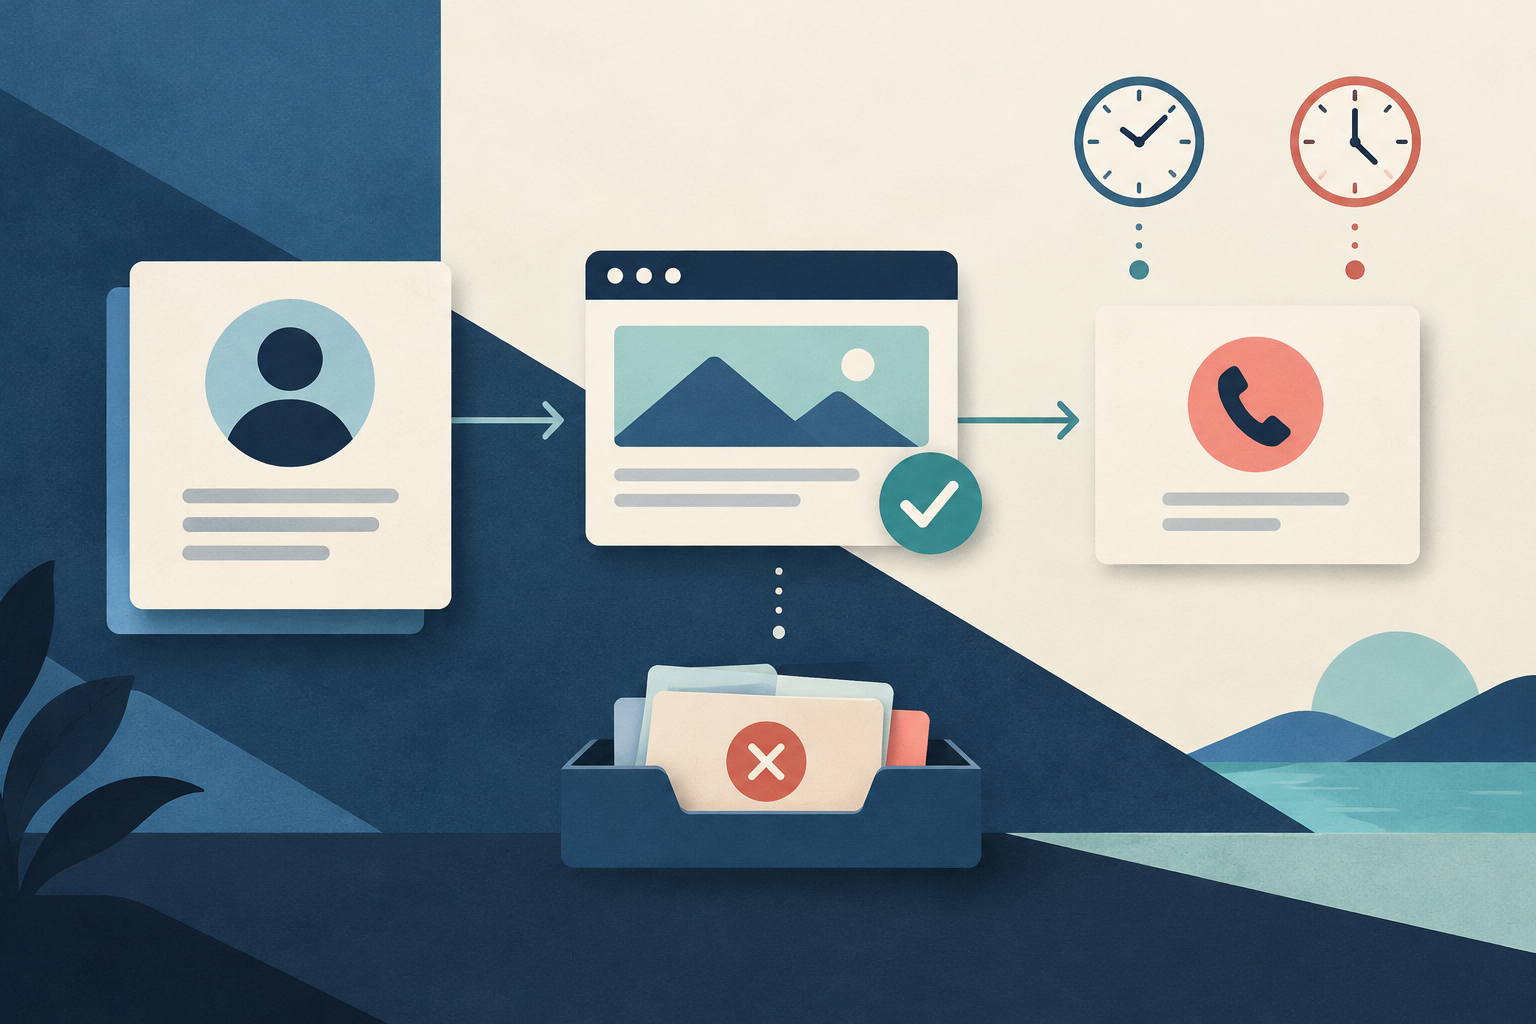
这个虚构流程提交了 3 个计划采集的公开个人资料。对于每个返回行,流程都会检查身份标识、必需计数和结果状态。满足所有要求的行进入创作者资料表。缺少必需计数的行送交审核。该计数保持未知。身份尚未确定的记录也送交审核。
团队检查输出单位:每个唯一输入都会生成 1 个经过核查的结果状态。该状态不保证个人资料数据完整。收到结果行意味着接收检查开始,而不是检查完成。
现在,假设下一项任务需要另一款产品的 About 版块或相关个人资料数据。团队会先考虑这套内容更丰富的约定,再扩展字段映射。必需字段改变了选择。Apify 个人资料范围。
此示例说明了如何根据字段进行选择,以及如何处理不完整的行。它不能得出有关速度、正常运行时间、准确性或节省成本的任何结论。
准备输入,并检查 1 个计划采集的个人资料
已发布的 Instagram 个人资料 n8n 自动化 Task可作为起始预设。页面检查返回了 HTTP 200,并确认 Task 标题符合预期。该检查不能确认当前保存的输入。运行前,请应用符合当前输入结构定义的输入。
这份最小输入通过了针对已核查公开输入结构定义的静态检查。静态检查只检查输入结构,不运行采集。检查涵盖字段名、必需字段、允许的选项、提交的列表大小、字符串格式规则和数值边界。这些检查并未确认示例来源目前可用。Actor 输入结构定义。
{
  "startUrls": [
    "https://www.instagram.com/mrbeast/"
  ]
}将示例替换为 1 个计划采集的公开个人资料。已核查的输入结构定义接受包含 1 至 1,000 个字符串的 `startUrls` 数组。支持输入公开个人资料 URL 或用户名。输入要求。
然后进行以下简短的接收检查:
- 选择 1 个计划使用的来源。使用确实需要纳入工作流的公开个人资料。默认示例无法证明计划使用的来源是否可用。
- 应用当前的输入结构定义。从 1 个输入开始,以便仔细检查其结果。
- 检查返回字段。找到输入回传、`channelId`、`channelUrl`、必需计数、`countPrecision`、`observedAt`、`status` 和 `statusReason`。将这些字段与表格要求进行比较。
- 检查这 2 条分流规则。确认接收规则要求所有必需字段都满足条件。确认审核流程会保留未知值和结果原因。1 个返回行可能无法验证全部 2 条路径。
- 写入 1 条完成映射的记录。检查保存后的记录。确认身份标识、缺失值、精度和观测时间的含义保持不变。
- 决定是否扩大输入范围。当字段满足需求且映射正常时,再继续。如果某个必需字段超出 Actor 的范围,就更换 Actor。
这项检查可以发现错误的字段映射,或目标位置将缺失值替换为 0 的情况。但仅凭 1 个个人资料,无法判断长期正常运行情况,也无法得出两款产品性能差异的结论。
将问题限定为:这条返回记录能否支持下一项任务?如需完整的身份分析方法,请参阅如何从创作者列表中移除重复的 Instagram 个人资料。该指南处理重复身份。本次比较则是在记录进入该处理流程之前,帮助你选择采集约定。
决策时保留这些限制条件
现有证据支持根据文档记载的范围进行选择。它不能证明任何一方在正常运行时间、规模扩展能力、速度、准确性、可靠性或覆盖范围上更好。也没有新的价格计算支持总成本更低的说法。
在 2026年10月19日自行开展的审查中,Chronometrica 将自有 Actor 评为运行正常。这些小规模对照检查不足以得出两款产品性能对比的结论。推荐依据仍然是公开的字段约定。Chronometrica Actor。
这个个人资料工作流不提供历史记录恢复、粉丝列表、私信或自动联系功能。只有公开展示的联系信息才可获取。关于这项独立任务,请参阅公开简介联系信息指南。
需要切换选择的主要条件,是某个必需字段不在精简快照的范围内。请将这一条件保留在工作流要求中。下一项任务发生变化时,请先重新检查字段列表,再扩展流程。
来源和延伸阅读
- Chronometrica Instagram Channel Scraper——公开文档和输入结构定义已于 2026年10月20日核查;支持文中所述字段、1–1,000 个提交输入、重复输入规则和用量单位;最小输入仅通过了静态检查;未进行新的采集运行或同等条件下的性能测试;10月19日自行开展的审查将该 Actor 评为运行正常,但小规模对照检查不足以得出两款产品性能对比的结论
- Apify Instagram Profile Scraper——公开文档已于 2026年10月20日核查;支持文中所述范围更广的个人资料数据和付费 About 附加功能;未进行同等条件下的运行或价格比较,也未推断文档未记载的功能不存在
- 关于在 n8n 中获取 Instagram 个人资料数据的公开读者问题——作为需求证据提供给 2026年10月20日的简报;未提供单独的页面检查日期;用于确认工作流问题,不代表对供应商的推荐,也不是经过验证的基准测试
- Instagram 个人资料 n8n 自动化 Task——提供的页面检查记录显示 HTTP 200,且 Task 标题符合预期;2026年10月20日的简报未提供该记录的单独检查日期;仅作为起始预设;未证明当前保存的输入,也未为本次比较执行运行
- 如何从创作者列表中移除重复的 Instagram 个人资料——随 2026年10月20日简报提供的现有指南;未提供单独的检查日期;讨论身份匹配,而非本文点名比较的 Actor 选择
作者 Chronometrica · 更新日期
返回顶部 ↑