设置你的职位数据收集
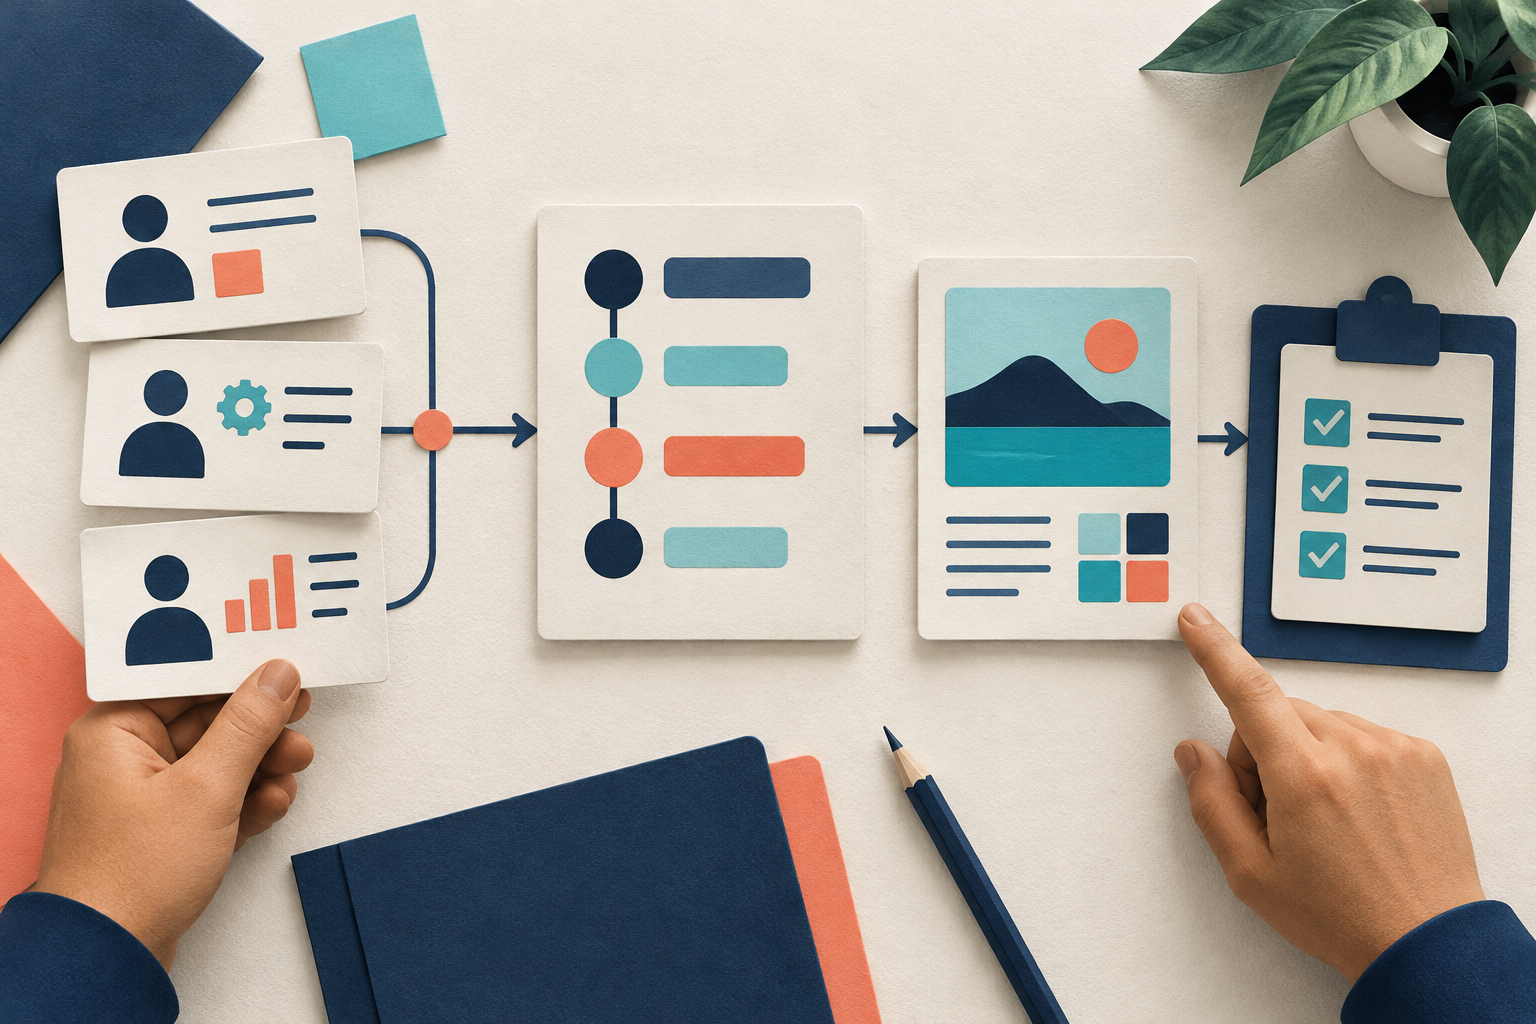
使用 LinkedIn Jobs Scraper Actor 和 LinkedIn Jobs by Experience Level Dataset Task 来收集职位信息。示例输入把 `searchTerm` 设为 data engineer,把 `experienceLevel` 设为 entry。读者应按自己的范围替换这两个值。
设置 `fetchJobDetails=true`、`maxItems=3` 和 `saveOnlyUniqueItems=true`。MaxItems 在整次收集中共用。保留这些字段:`jobId`、`jobUrl`、`title`、`companyName`、`locationRaw`、`seniority`、`employmentType`、`descriptionStatus`、`descriptionText`、`descriptionSnippet` 和 `scrapedAt`。值可以缺失。
Actor 提供的是来源文本和标签,不是简历分析或匹配分数。进行比较之前,需要与来源对应的完整描述。一段摘要不能表明一项未提及的技能不存在。当前这三条已接受的完整详情记录确立的是来源数据结构,不是一次真实的简历对照测试。
1. 建立你的证据清单
写下你的目标职位名称和不可让步的规则。做一份简短、如实的工作证据清单。列入你做过的任务、用过的工具、项目范围和相关日期。把你的自我评估与职位信息所要求的内容分开。
Actor 是一个托管程序,用于从网上收集数据。Task 是为该程序保存的输入预设。你可以用 Actor 收集职位记录,但必须自己做人工分析。这个数据收集器给你的是职位文本和来源标签。它不提供技能匹配分数,也不分析你的简历。
2. 收集一小份职位样本
收集一小份包含完整描述的职位信息。在用一条职位信息做要求对照之前,你必须先通过完整描述关口。如果描述缺失,应把证据标为不足,而不是因为缺少某些词语就拒绝该职位。
仔细核对职位信息的来源资历标签。来源资历标签可能与实际经验要求不同,因此你必须阅读完整的职责和条件。保留来源文本、状态和观察时间。不要把私人简历发给第三方模型。这种方法不需要模型,也不需要上传简历。
3. 拆分职位要求
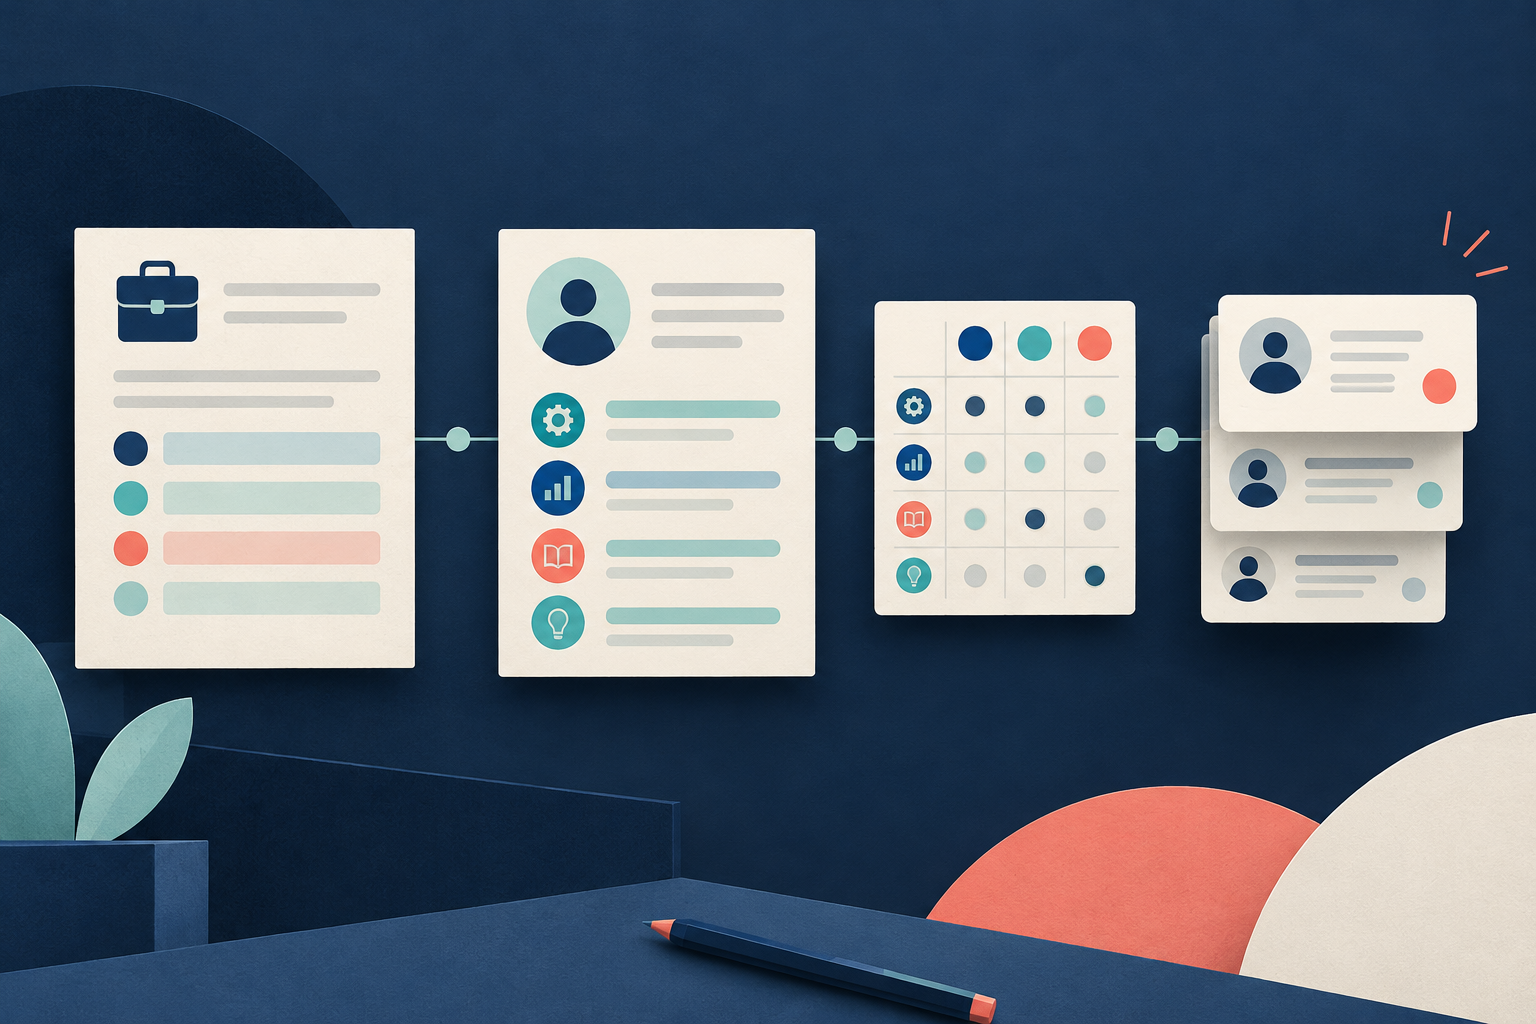
把职位信息分成三部分:必需条件、必需职责与技能,以及优先加分项。在每一条解释后的要求旁边保存支持它的文本段落。不要把公司介绍段落里提到的每一个工具都变成求职者的必备技能。
4. 执行硬性条件检查
先检查硬性要求。如果一条职位信息要求你无法满足的条件,就按你的规则把它排除。如果一项实质性条件不清楚,就标为稍后核实。通过这些检查的职位可以进入技能与职责审阅。这项检查并不是对资格或录用的承诺。
5. 把职责对应到你的证据
把每一项核心职责与你的工作证据对照。把每项职责评为:已证明、相关但有限、未证明,或不清楚。用一句话说明理由。旧工具名称的匹配,可能不如同一职责的近期证据有用。把这一判断说清楚,不要把它藏进一个数字里。
6. 把优先加分项分开
把优先加分项与核心要求分开。缺少一项优先工具,并不意味着硬性排除,除非职位信息写明该工具是必需的。不要编造权重,也不要把求和分数说成客观结果。
7. 选择你的短名单类别
把每条职位信息归入三类之一:短名单、超出当前已证明匹配的挑战职位/待核实,或搁置,并给出一个明确理由。把未知项和问题留到稍后检查。如果两个职位的匹配程度相近,就用职责匹配情况和尚未满足的职位要求来决定把阅读和申请时间花在哪里。不要使用虚假的录用概率。
8. 维护一张决策表
保留一张与来源关联的决策表。当雇主澄清一项要求,或你自己的证据发生变化时,更新这张表。结果是一份透明的短名单。申请和主动联系是你稍后另行采取的动作。
虚构示例与证据分析
本示例中的全部职位和求职者经历都是虚构的。
求职者证据清单
- 搭建过一条 Python 与 SQL 的每周报告流水线。
- 检查过数据质量,并记录了失败情况。
- 没有生产环境值班岗位经验。
- 没有团队管理经验。
- 目前正在学习云部署。
- 没有声称过的商业成功或数字。
示例职位信息
- 职位 A:要求 Python 与 SQL 报告以及来源质量检查;优先考虑云部署;资历字段为 entry。没有已知的硬性冲突。证据把必需职责对应到已证明的工作。云部署这一优先项的缺口已记录。
- 职位 B:要求生产环境云运维和值班事件处理;优先考虑 Python。求职者在 Python 上的匹配并不能满足两项主要职责。
- 职位 C:要求管理团队并负责预算;标题为 data lead;描述文本不完整。管理能力未被证明,完整的要求上下文也未经核实。
证据表
| 职位 | 要求或职责 | 求职者证据 | 匹配状态 | 决策与理由 |
|---|---|---|---|---|
| A | Python 与 SQL 报告 | 搭建过每周报告流水线 | 已证明 | 短名单:核心报告职责已证明 |
| A | 来源质量检查 | 检查过数据并记录了失败情况 | 已证明 | 短名单:质量检查已证明 |
| A | 云部署 | 正在学习云部署 | 相关但有限 | 短名单:云加分项待定 |
| B | 生产环境与值班 | 没有生产环境值班岗位经验 | 未证明 | 搁置:缺少必需的生产运维 |
| C | 管理与预算 | 没有管理经验 | 未证明 | 待定:因文本不完整,需要完整来源审阅 |
为什么按职责审阅很重要
如果只看关键词,Python 一词在职位 A 和职位 B 中都出现,会得到两个匹配。但是,按职责审阅只把职位 A 明确列为短名单的第一选择,因为职位 B 缺少生产环境与值班职责的证明。
本文读者使用“缺少核心职责”这一证据规则搁置职位 B,因为生产环境云运维和值班职责未被证明。共有的 Python 一词证据不足。职位 A 仍是明确列入短名单的职位,职位 C 仍待完整来源审阅。全部五行证据确认:Python 的两次关键词命中只产生一个明确列入短名单的职位,没有权重,也没有预测的面试几率。
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑