采集设置
要获取原始数据,请使用名为 Actor 的托管数据采集程序。Reddit Comments 抓取器可帮助你拉取公开讨论串。把任务预设改为使用一条已知讨论串 URL。将每篇帖子的最大评论数限制设在 1 到 500 之间,默认值为 100。对这个入门任务,使用 3 行的上限。输入项 postUrls 需要 1 到 50 条已知公开讨论串,maxCommentsPerPost 为每篇帖子 1 到 500,预设值 250 在本次试点中改为 3。
每条评论行都有确切字段名:postId、commentId、parentId、depth、body、status、unavailableFields 和 observedAt。保留确切名称,不要用带空格的别名。数据集 status 只有 ok、deleted 或 removed。部分完成或失败的运行,以及输入状态,都与行的 status 分开。
运行输出数据包括 commentsSaved、duplicatesSkipped、hiddenBranchesRemaining、completionReason、status、isComplete 和 inputResults。每个输入的字段包括 commentsFound、commentsSaved、status 和 reason。当前试点中,三个正文存在的 ID 的 parentId 和 depth 为 null,hiddenBranchesRemaining 为 null;尽管处理标志为 isComplete=true,总体结果或输入结果仍是部分完成。这并不能证明上下文完整,也不能证明分类器质量。如果需要匹配的父级,请做一次经授权的公开人工核对,或把上下文保持为未知。绝不要猜测相邻的一行。
定义目标与标签
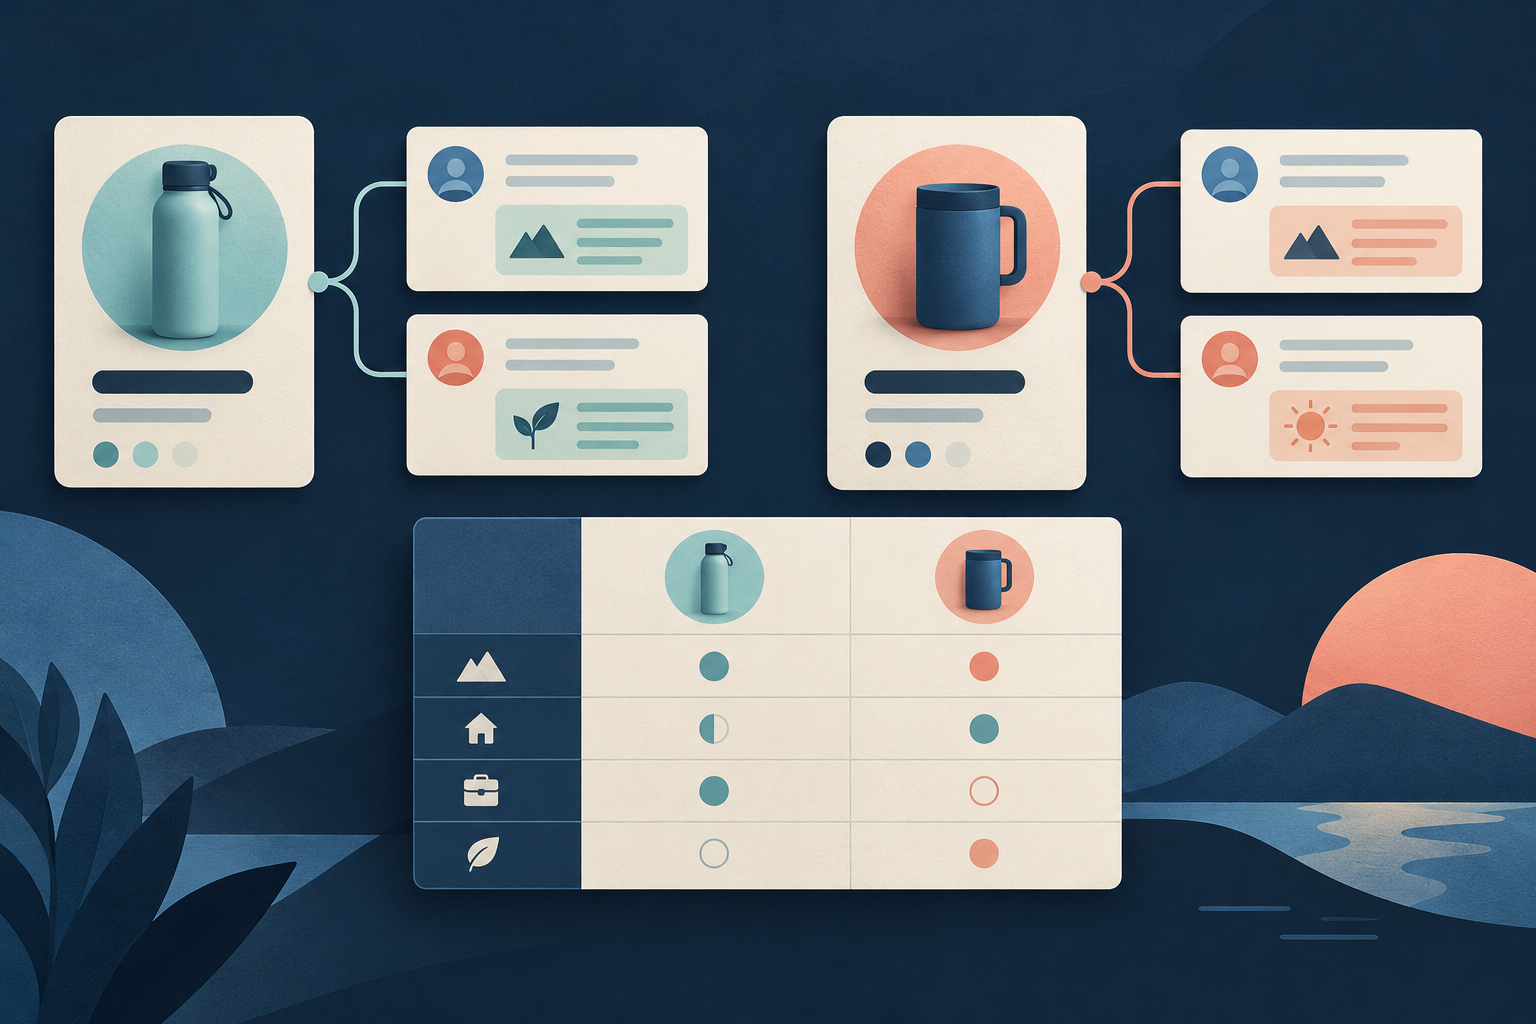
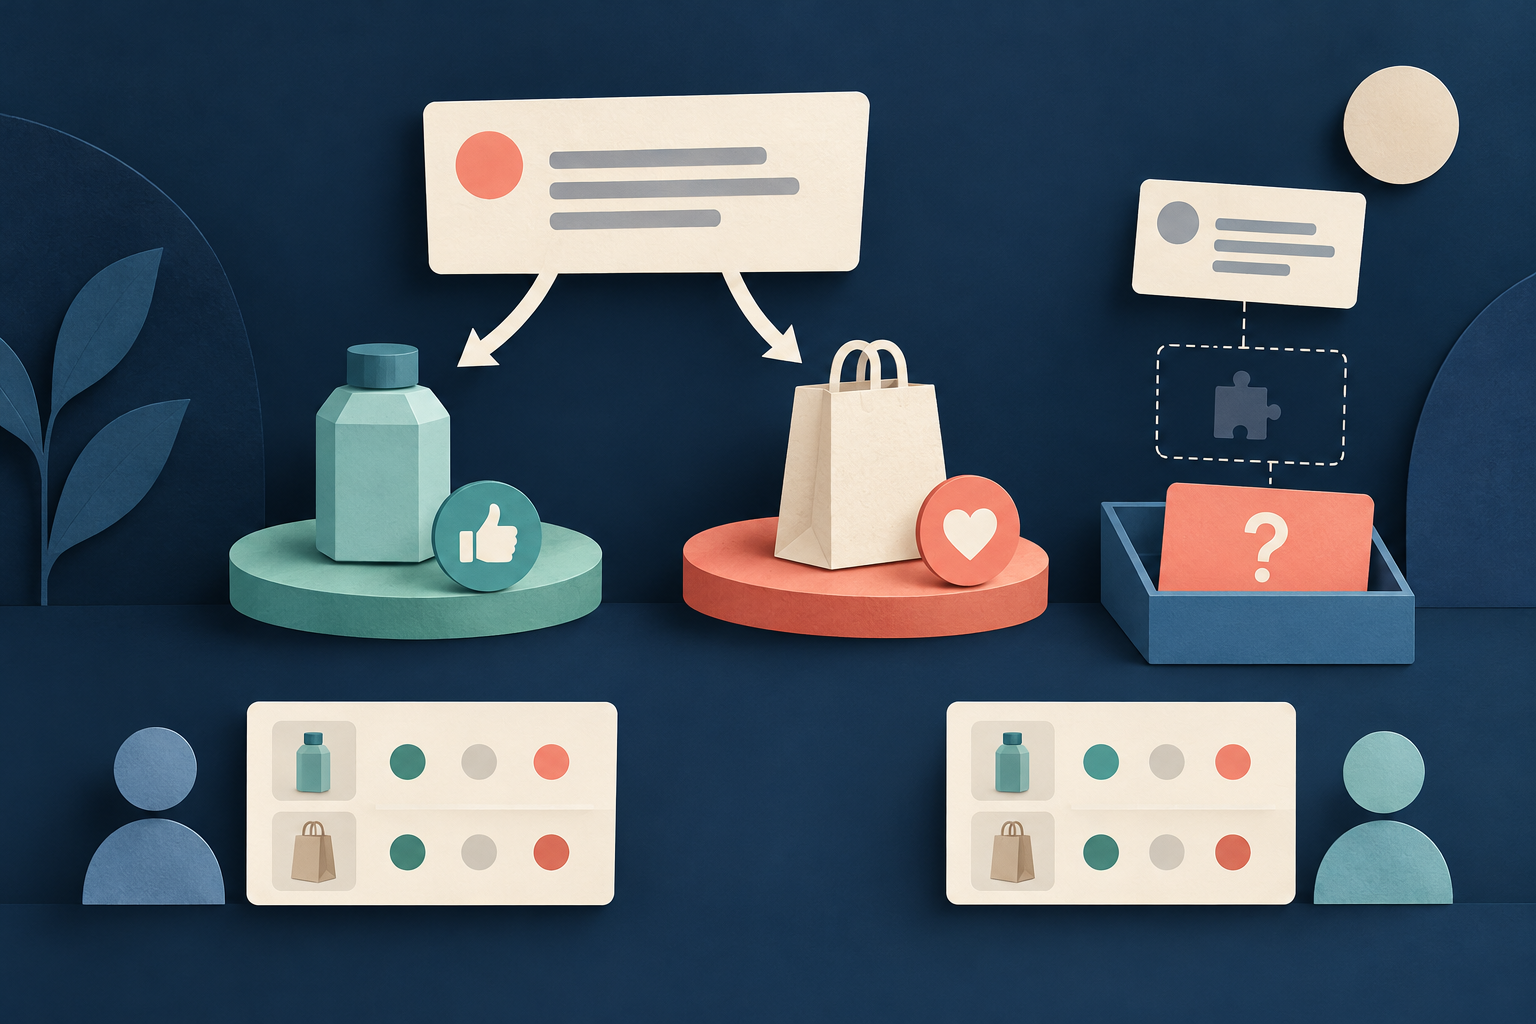
在阅读任何文本之前,先定义你的目标集合和标注单位。这里的一个单位是一条评论加上一个目标,不是一条评论,也不是一个人。用简明规则指定五个标签:
- 正面:表达了认可。
- 负面:表达了不认可。
- 中性:陈述事实,没有立场。
- 混合:同时持有正面和负面看法。
- 不确定:目标或立场不清楚。
目标是这些文字所谈论的特定人物、产品、政策或行动。
分析评论的八个步骤
- 在阅读之前,先定义你的问题、目标集合和标注单位。
- 保留来源行和输出数据。保留评论身份、文本、状态和缺失数据。制作一张工作用标签表,不要把猜测的情感写进原始字段。
- 在有匹配的父级上下文时阅读它。找出明确的目标提及和代词。如果不能安全地确定代词所指,就把目标和上下文保持为不确定。把讽刺当作需要复核的理由,而不是自动的负面标签。
- 拆分多目标陈述。一条评论可以称赞速度,同时不喜欢价格变动。不要赋予一个笼统的偏好。
- 保存评论 ID、目标、证据段落、上下文来源、标签和理由。把他人的引语与作者自己的立场分开。没有上下文时,不要把一个问题标成抱怨。
- 请第二位阅读者对一小部分共同子集进行编码。记录原始一致情况,并注明哪些规则造成了分歧。没有经过论证的参照标准时,不要声称高准确率。完善规则,并重新标注受影响的个案。
- 分别按评论—目标单位和每个只计一次的评论 ID 报告计数。多目标评论会产生比评论数更多的标签行。把不确定标签和不可用正文留在已解析分母之外,并保持可见。
- 交付一张目标—立场表、一本编码手册和分歧说明。这是在准备一份可供检查的数据集。它不提供产品优先级、有代表性的意见,或自动回复动作。
本示例中的全部文本和 ID 都是虚构的。设想父级上下文 P 询问产品 A 的新月度价格,以及产品 B 的上手。
| commentID | 匹配的上下文来源 | 目标 | 确切的来源段落 | 标签 | 理由 |
|---|---|---|---|---|---|
| C1 | 上下文 P | 产品 A | 「我仍然喜欢 A」 | 正面 | 对产品 A 表达正面立场 |
| C1 | 上下文 P | 价格变动(A) | 「新价格很差」 | 负面 | 对价格变动表达负面立场 |
| C2 | 上下文 P | 上手(B) | 「B 很容易学会」 | 正面 | 称赞上手容易 |
| C2 | 上下文 P | 速度(A) | 「对我们团队来说,A 更快」 | 正面 | 称赞速度,且仅限于该团队的体验 |
| C3 | 上下文 P(已确认) | 涨价 | 「太好了,又一次涨价」 | 负面 | 讽刺性抱怨,已由父级 P 确认 |
| C4 | 未知 | 未知 | 「它能离线使用吗?」 | 不确定 | 没有父级上下文,目标未能确定 |
请注意,C5 的正文状态为 removed,它位于情感表之外,作为一条可用性记录,没有情感标签。
虚构的演算示例
评论 C1 说:「我仍然喜欢 A,但新价格很差。」这产生两个单位。产品 A 为正面。A 的价格变动为负面。不要给产品 A 赋予一个笼统的负面立场。
评论 C2 说:「B 很容易学会;对我们团队来说,A 更快。」这把 B 的上手标为正面,把 A 的速度标为正面,并带有团队条件。没有说出总体胜者。
评论 C3 说:「太好了,又一次涨价。」只有在父级上下文 P 已确认时,才把这个目标价格变动计入。经人工复核后,把它标为负面或讽刺,否则保持为不确定。
评论 C4 说:「它能离线使用吗?」这里有一个未能确定的代词,且没有父级上下文。目标未知,因此标为不确定。不要把一个问题变成关于离线的负面反馈。
评论 C5 的正文已被移除,因此不做分析。在表中保留它的可用性位置。
在 C3 的父级已确认时,标签表有六个评论—目标单位,来自四条正文可用的评论。也就是 C1 两个、C2 两个、C3 一个、C4 一个。
已解析单位合计五个。三个为正面,分别是 C1 的 A、C2 的 B 和 C2 的 A。两个为负面,分别是 C1 的价格和 C3 的价格。一个为不确定,是 C4。
正面分数是 3 除以 5,等于仅已解析目标单位的 60%。它不是评论者的 60%,也不是社区意见的 60%。共有五个被观察到的位置,以及四条正文可用的评论,C5 因 removed 而位于情感之外。
编码一致性与限度
两位虚构编码员为五个已解析单位标注。他们最初的一致是 5 个中的 4 个,即 80%。他们对 C3 的差异涉及讽刺和上下文。他们复核实际的父级条件,并就一条规则达成一致。这并不能确立普遍的 80% 准确率。如果 C3 的父级缺失,它必须保持不确定。已解析分母降为 4。不要根据相邻行编造父级确认。
最终成果分别展示来源指针和每个目标,并把 C4 和 C5 放在未知与不可用的台账中。它不提供话题频率表或功能优先级表。真实讨论遵循类似的社区模式。你可以查看一次真实的情感项目讨论以获得更多上下文。
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑