Mise en place de la collecte
Pour obtenir les données brutes, utilisez un programme hébergé de collecte de données appelé un Actor. Le scraper Reddit Comments vous aide à extraire les fils publics. Modifiez le préréglage de la tâche pour utiliser l'URL d'un fil connu. Réglez la limite maximale de commentaires par publication entre 1 et 500, avec une valeur par défaut de 100. Pour cette tâche de démarrage, utilisez un plafond de 3 lignes. L'entrée postUrls exige de 1 à 50 fils publics connus, et maxCommentsPerPost va de 1 à 500 par publication, le préréglage 250 étant ramené à 3 pour le pilote.
Chaque ligne de commentaire a des noms de champs exacts : postId, commentId, parentId, depth, body, status, unavailableFields et observedAt. Conservez les noms exacts, et non des alias avec espaces. Le statut du jeu de données est seulement ok, deleted ou removed. Un état d'exécution ou d'entrée partiel ou en échec est distinct du statut de la ligne.
Les données de sortie de l'exécution comprennent commentsSaved, duplicatesSkipped, hiddenBranchesRemaining, completionReason, status, isComplete et inputResults. Les champs par entrée comprennent commentsFound, commentsSaved, status et reason. Dans le pilote actuel, les trois identifiants dont le corps est présent ont parentId et depth à null, hiddenBranchesRemaining à null, et les résultats globaux ou par entrée sont partiels malgré l'indicateur de traitement isComplete=true. Ceci n'est ni une preuve de contexte complet ni une preuve de qualité du classifieur. Si un parent correspondant est nécessaire, faites une vérification publique manuelle autorisée, ou laissez le contexte inconnu. Ne devinez jamais une ligne voisine.
Définition des cibles et des étiquettes
Avant de lire un texte, définissez votre ensemble de cibles et votre unité d'étiquetage. Ici, une unité est un commentaire plus une cible, et non un commentaire seul ni une personne. Précisez cinq étiquettes avec des règles simples :
- Positif : approbation exprimée.
- Négatif : désapprobation exprimée.
- Neutre : énoncé de faits sans prise de position.
- Mixte : avis à la fois positif et négatif.
- Incertain : la cible ou la position n'est pas claire.
Une cible est la personne, le produit, la politique ou l'action précise dont parlent les mots.
Huit étapes pour analyser les commentaires
- Définissez votre question, votre ensemble de cibles et votre unité d'étiquetage avant la lecture.
- Conservez les lignes sources et les données de sortie. Gardez l'identité du commentaire, le texte, le statut et les données manquantes. Faites un tableau d'étiquettes de travail au lieu d'écrire un sentiment deviné dans les champs d'origine.
- Lisez le contexte parent correspondant lorsqu'il est disponible. Repérez les mentions explicites de cibles et les pronoms. Si vous ne pouvez pas résoudre un pronom de façon sûre, laissez la cible et le contexte incertains. Traitez le sarcasme comme un motif de relecture, et non comme une étiquette négative automatique.
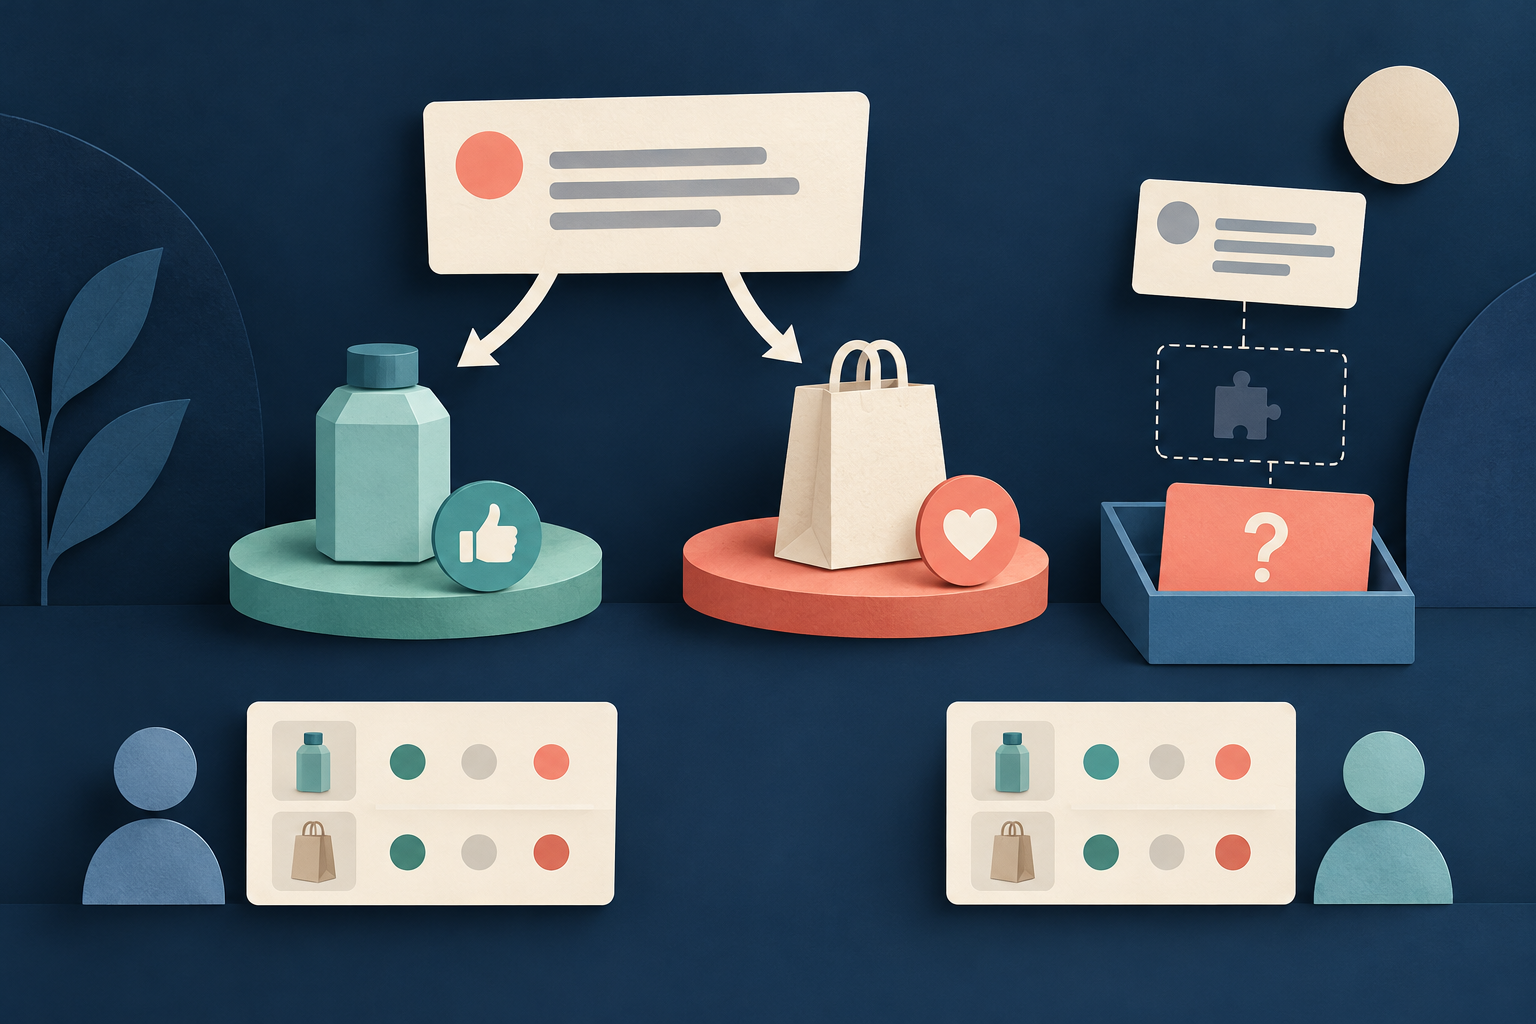
- Séparez les énoncés à plusieurs cibles. Un commentaire peut louer la vitesse et ne pas aimer un changement de prix. N'attribuez pas de préférence universelle.
- Enregistrez l'identifiant du commentaire, la cible, le passage de preuve, la source du contexte, l'étiquette et la raison. Gardez les mots cités d'autres personnes séparés de la position propre de l'auteur. N'étiquetez pas une question comme une plainte sans contexte.
- Faites coder un petit sous-ensemble commun par un second lecteur. Enregistrez l'accord brut et notez quelles règles ont causé les désaccords. Ne revendiquez pas une exactitude élevée sans un standard de référence justifié. Affinez vos règles et réétiquetez les cas concernés.
- Indiquez séparément les effectifs par unités commentaire-cible et par identifiants de commentaire distincts, chacun compté une fois. Les commentaires à plusieurs cibles ajoutent plus de lignes d'étiquette que de commentaires. Laissez les étiquettes incertaines et les corps indisponibles visibles en dehors des dénominateurs résolus.
- Livrez un tableau des positions par cible, un manuel de codage et des notes de désaccord. Cela prépare un jeu de données que l'on peut inspecter. Cela ne donne pas de priorités de produit, d'opinions représentatives ni d'actions de réponse automatisées.
Tous les textes et identifiants de cet exemple sont inventés. Imaginez que le contexte parent P porte sur le nouveau prix mensuel du produit A et sur la prise en main du produit B.
| commentID | source de contexte correspondante | cible | passage source exact | étiquette | raison |
|---|---|---|---|---|---|
| C1 | Contexte P | Produit A | "J'aime toujours A" | Positif | Exprime une position positive sur le produit A |
| C1 | Contexte P | Changement de prix (A) | "le nouveau prix est mauvais" | Négatif | Exprime une position négative sur le changement de prix |
| C2 | Contexte P | Prise en main (B) | "B était facile à apprendre" | Positif | Éloge de la facilité de prise en main |
| C2 | Contexte P | Vitesse (A) | "A était plus rapide pour notre équipe" | Positif | Éloge de la vitesse, limité à l'expérience de cette équipe |
| C3 | Contexte P (confirmé) | Hausse de prix | "Super, encore une hausse de prix" | Négatif | Plainte sarcastique confirmée par le parent P |
| C4 | Inconnu | Inconnu | "Cela fonctionne-t-il hors ligne ?" | Incertain | Cible non résolue sans contexte parent |
Notez que C5 a un statut de corps removed et reste hors du tableau de sentiment, comme enregistrement de disponibilité sans étiquette de sentiment.
Exemple fictif résolu
Le commentaire C1 dit : "J'aime toujours A, mais le nouveau prix est mauvais." Cela donne deux unités. Le produit A est positif. Le changement de prix pour A est négatif. N'attribuez pas une position négative universelle au produit A.
Le commentaire C2 dit : "B était facile à apprendre ; A était plus rapide pour notre équipe." Cela donne la prise en main de B comme positive et la vitesse de A comme positive, limitée à l'expérience de cette équipe. Aucun gagnant global n'est énoncé.
Le commentaire C3 dit : "Super, encore une hausse de prix." Ce changement de prix, comme cible, n'est compté que si le contexte parent P est confirmé. Étiquetez-le négatif ou sarcasme après relecture manuelle ; sinon, laissez-le incertain.
Le commentaire C4 dit : "Cela fonctionne-t-il hors ligne ?" Il contient un pronom non résolu, sans contexte parent. La cible est inconnue, donc étiquetez-le incertain. Ne transformez pas une question en retour négatif sur le hors-ligne.
Le corps du commentaire C5 est retiré, donc il n'est pas analysé. Conservez l'entrée qui documente son corps indisponible dans le tableau, sans lui attribuer de sentiment.
Avec un parent confirmé pour C3, le tableau d'étiquettes compte six unités commentaire-cible, issues de quatre commentaires dont le corps est disponible. Cela signifie deux pour C1, deux pour C2, une pour C3 et une pour C4.
Les unités résolues totalisent cinq. Trois sont positives pour C1 A, C2 B et C2 A. Deux sont négatives pour le prix de C1 et le prix de C3. Une est incertaine pour C4.
Le score positif est 3 divisé par 5, ce qui est égal à 60 % des seules unités de cible résolues. Ce n'est pas 60 % des auteurs de commentaires, ni de l'opinion de la communauté. Il y a cinq positions observées et quatre commentaires au corps disponible, avec C5 en statut removed hors du sentiment.
Accord de codage et limites
Deux codeurs fictifs étiquettent les cinq unités résolues. Leur accord initial est de 4 sur 5, ce qui est égal à 80 %. Leur différence sur C3 concerne le sarcasme et le contexte. Ils examinent la condition réelle du parent et conviennent d'une règle. Cela n'établit pas une exactitude générale de 80 %. Si le parent de C3 est absent, l'unité doit rester incertaine. Le dénominateur résolu tombe à 4. N'inventez pas une confirmation du parent à partir des lignes voisines.
L'artefact final montre des renvois aux sources et chaque cible séparément, avec C4 et C5 dans un registre des inconnus et des indisponibles. Il ne fournit pas de tableaux de fréquence des sujets ni de priorité des fonctionnalités. Les discussions réelles suivent des schémas communautaires semblables. Vous pouvez consulter une discussion réelle d'un projet de sentiment pour plus de contexte.
Sources et lectures complémentaires
Par Chronometrica · Mis à jour
Retour en haut ↑