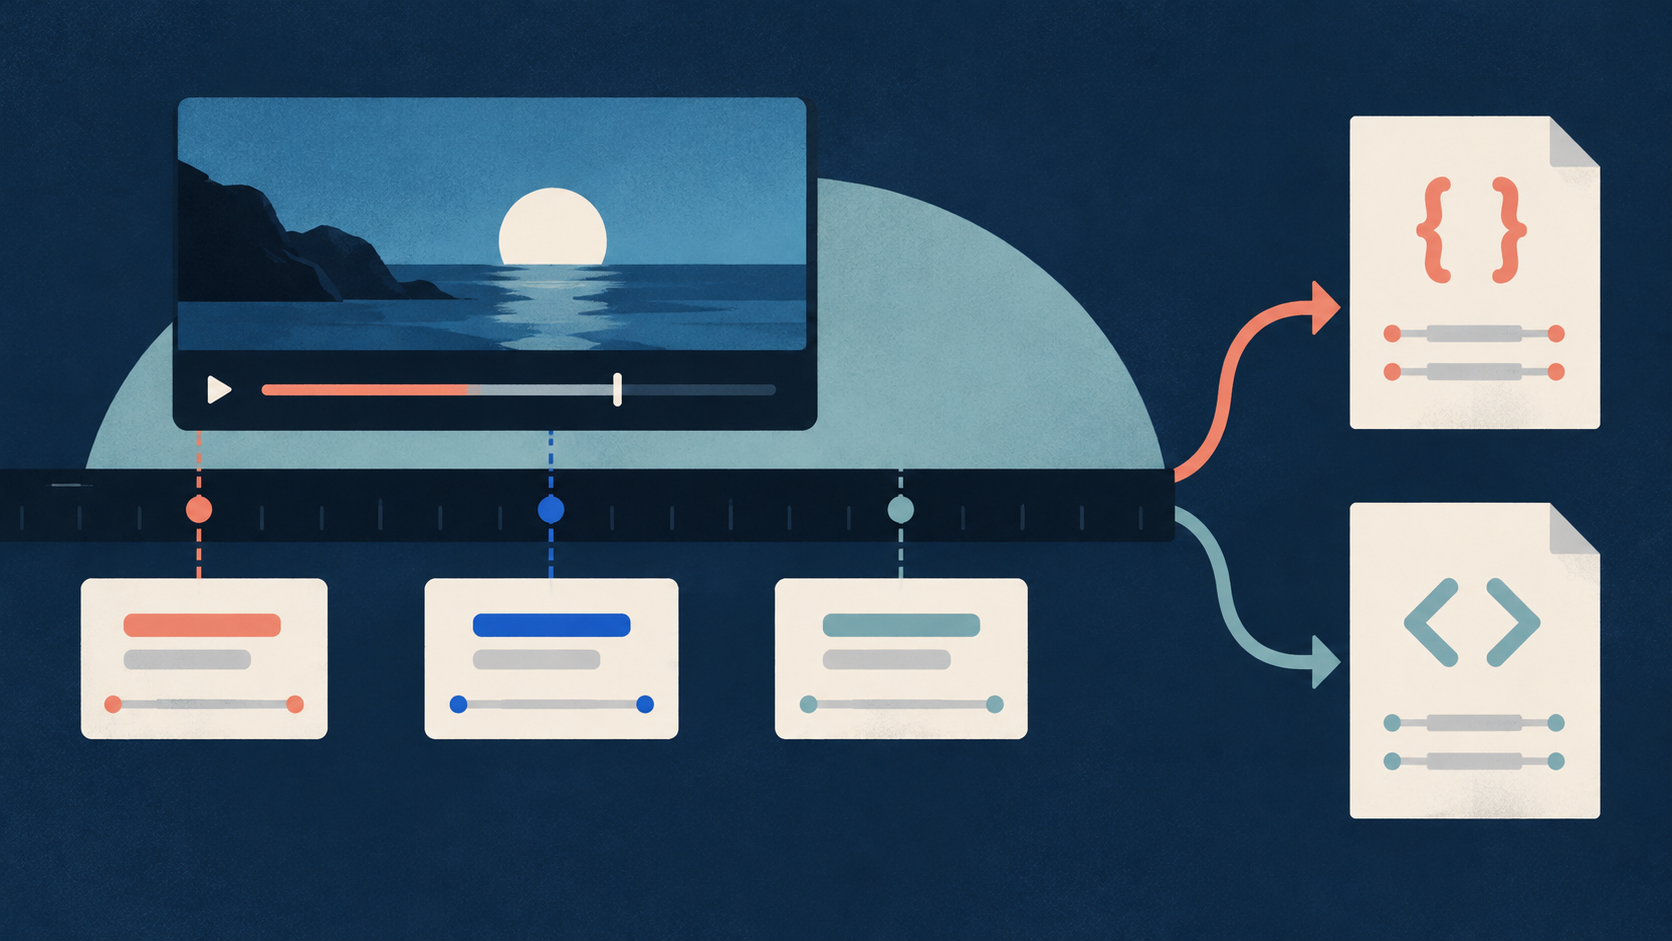
Mesmo um único vídeo pode exigir tanto uma cópia de texto limpa para leitura quanto uma cópia de origem com tempos para consulta. Você pode usar um Actor, que é um programa hospedado de coleta de dados, configurado por meio de uma Task, que é uma predefinição de entrada salva. Quando selecionado, JSON, que é um formato de texto estruturado, preserva os segmentos com tempo, enquanto as saídas somente de texto não os preservam.
Compreender as origens e as limitações das legendas
As legendas do YouTube vêm de faixas manuais enviadas pelo criador e do reconhecimento automático de fala gerado pelos algoritmos da plataforma. A documentação oficial afirma que vídeos com legendas têm uma transcrição disponível diretamente pelo menu da descrição do vídeo (Ajuda do YouTube: Ver transcrições). Porém, as legendas automáticas podem registrar a fala de forma incorreta por causa de pronúncias incorretas, sotaques, dialetos ou ruído de fundo (Ajuda do YouTube: Legendas automáticas). Além disso, um silêncio longo no início e vozes sobrepostas aparecem como possíveis problemas de geração de legendas nas referências oficiais. Essas listas gerais, por si sós, não diagnosticam um vídeo específico.
Acessar uma faixa de legendas públicas exige que o vídeo de destino realmente exponha legendas utilizáveis. Abrir um URL direto do vídeo não basta se a própria faixa estiver ausente ou desativada. Observe que o acesso às legendas públicas é diferente do acesso geral para assistir. Não agrupe vídeos não listados com vídeos privados, porque vídeos não listados ainda podem expor faixas de legendas públicas se o criador as ativar. Mantenha distintos os casos de legendas ausentes, de incompatibilidade de idioma e de falha de extração.
O método prático para obter e verificar transcrições
- Confirme o link direto exato do vídeo e registre o objetivo principal da pesquisa antes de começar a extração. Verifique se você está trabalhando com um URL de vídeo público conhecido, e não com uma playlist ou uma página de canal.
- Teste o vídeo de forma nativa: abra a página, role até a descrição e clique em Mostrar transcrição para verificar as faixas disponíveis. Se a ação não estiver presente, trate isso como um sinal para a próxima verificação, e não como um diagnóstico automático de privacidade.
- Escolha texto simples para leitura, evidência com tempos ou ambos, e selecione json e text juntos quando precisar tanto de um texto limpo para leitura quanto de segmentos com tempo.
- Configure a sua entrada com um único URL direto de vídeo usando o array startUrls, defina outputFormats como ["json", "text"] e mantenha includeFailedInputDetails ativado. Deixar preferredLanguages vazio permite que o coletor selecione a melhor faixa disponível, enquanto uma análise estrita em inglês exige defini-lo como ["en"].
- Execute a extração e inspecione tanto as linhas do dataset quanto o registro de resumo OUTPUT, usando campos como rowsWritten, successfulTranscriptRows, failedInputs e duplicateVideosSkipped para contabilizar as suas entradas.
- Observe que text é um campo da linha do dataset, e não um download automático de arquivo de texto. Abra uma linha bem-sucedida, copie o valor do campo text para o seu próprio documento de leitura e guarde uma exportação de origem em JSON separada, com segmentos para os tempos. Verifique o videoId, o transcriptLanguageCode real e o transcriptLanguageName. Compare amostras de áudio do início, do meio e do fim com os segmentos de legenda correspondentes quando o texto exato importa. Observe que verificações pontuais não certificam cada palavra. Mantenha as correções manuais separadas dos seus dados brutos de origem.
- Compare os códigos de erro com a tabela de falhas para determinar o próximo passo. Inspecione a propriedade isRetryable e faça uma nova tentativa posterior e limitada somente se esse valor for true.
- Guarde o URL, o ID do vídeo, o idioma real, o indicador automático ou manual, o horário de coleta scrapedAt, o estado do resultado, a cópia de origem e as notas de correção. Conclua com uma decisão clara sobre se a transcrição atende aos seus critérios de qualidade e de completude.
Automatizar a extração com Actors estruturados
Quando um ou mais vídeos conhecidos exigem texto de leitura salvo e evidência com tempos, o Chronometrica YouTube Transcript Scraper ajuda a coletar os dados. Este Actor lê faixas de legendas públicas existentes e pode fornecer uma cópia de texto legível e segmentos com tempo quando json e text são selecionados.
Este Actor lê faixas de legendas públicas existentes. Ele não cria reconhecimento de fala, não traduz texto, não baixa mídia e não descobre vídeos.
Para configurar o Actor, você fornece uma entrada. Você pode explorar predefinições especializadas, como o YouTube Transcript Scraper para um ponto de partida com JSON e text, o YouTube Transcripts as Plain Text para uma predefinição somente de texto, ou o YouTube Timestamped Transcript JSON para uma predefinição somente de JSON. Observe que a predefinição somente de texto não guarda segmentos com tempo; use json e text juntos quando precisar tanto de texto de leitura quanto de evidência de tempo.
A entrada startUrls recebe um array de strings de URL direto de vídeo. A entrada outputFormats aceita formatos como json e text. O parâmetro includeFailedInputDetails controla se relatórios detalhados de erro das entradas com falha aparecem no resumo da execução OUTPUT.
{
  "startUrls": [
    "VIDEO_URL_TO_REPLACE"
  ],
  "outputFormats": [
    "json",
    "text"
  ],
  "includeFailedInputDetails": true
}Substitua o token VIDEO_URL_TO_REPLACE inteiro por um URL público direto e conhecido de vídeo antes de executar, porque o token mostrado é apenas um espaço reservado.
Interpretar os resultados da execução e os campos de saída
Uma execução de Actor produz linhas do dataset e um registro de resumo da execução. Uma linha do dataset representa a transcrição bem-sucedida de um vídeo único, e não uma entrada ou um segmento. Entradas com falha não criam linhas do dataset.
O OUTPUT é o registro de resumo da execução que contabiliza sucessos, falhas e duplicatas ignoradas. Os principais campos do resumo incluem inputsReceived, uniqueVideosPlanned, rowsWritten, successfulTranscriptRows, failedInputs, duplicateVideosSkipped, statusCounts, errorCodeCounts e failedInputDetails. Não infira que um vídeo não tem legendas somente a partir de um dataset vazio.
Com a configuração de JSON e text deste artigo, cada linha bem-sucedida contém tanto a cópia de texto simples para leitura quanto os dados dos segmentos com tempo. Selecionar outros formatos de saída não significa, de forma automática, que os segmentos com tempo ficam retidos no seu dataset.
Verificar a qualidade da saída e as métricas (FICTÍCIO)
Para avaliar a confiabilidade da extração, você pode calcular métricas de amostra. Considere uma execução fictícia rotulada em que preferredLanguages está definido como ["en"]. Sete links de entrada contêm cinco vídeos únicos e duas entradas duplicadas. Três vídeos únicos produzem transcrições em inglês bem-sucedidas, um não tem legendas públicas e um não tem uma faixa correspondente em inglês, o que causa um erro LANGUAGE_UNAVAILABLE. Se a preferência vazia padrão fosse usada no lugar, outra faixa de idioma disponível poderia ser selecionada. Assim, a ausência de inglês, sozinha, não faria uma execução padrão falhar.
Nesta amostra fictícia:
- Total de entradas: 7
- Vídeos únicos: 5 (3 bem-sucedidos, 2 com falha)
- Entradas duplicadas: 2
- Linhas do dataset gravadas: 3
Disponibilidade de faixas utilizáveis = Vídeos únicos bem-sucedidos / Total de vídeos únicos = 3 / 5 = 60 por cento.
Este número de 60 por cento descreve a disponibilidade de faixas utilizáveis nesta amostra escolhida, não a precisão nem uma taxa de todo o YouTube.
Considere um exemplo fictício separado de tempo em que o primeiro segmento de legenda começa aos 2 segundos, o último segmento de legenda termina aos 92 segundos e a duração total do vídeo é de 100 segundos. O intervalo das legendas é 92 menos 2, o que equivale a 90 segundos. Esse intervalo, dividido pela duração total do vídeo de 100 segundos, dá a razão de 90 sobre 100, ou 0.90.
Uma razão do intervalo das legendas de 0.90 descreve somente o intervalo das legendas e não pode medir a precisão das palavras. Ainda podem existir lacunas e erros de reconhecimento de palavras dentro desse intervalo. Uma execução bem-sucedida na plataforma não significa que cada entrada produziu legendas.
Diagnosticar e tratar falhas
Um código de falha descreve a classe da falha observada, em vez de sempre fornecer a causa raiz exata. Revise a tabela documentada de código e de próxima ação, abaixo, para associar cada erro à sua resposta adequada.
| Código de erro | Condição relatada | Próxima verificação e ação |
|---|---|---|
| TRANSCRIPT_NOT_FOUND | Nenhuma faixa pública disponível após a consulta | Inspecione a página de origem nativa; solicite legendas ou use uma transcrição separada e autorizada, se necessário. |
| LANGUAGE_UNAVAILABLE | Nenhuma correspondência com o idioma solicitado foi encontrada | Verifique as faixas de origem disponíveis e mantenha o requisito, ou mude a política somente se isso for aceitável. |
| INVALID_INPUT / UNSUPPORTED_INPUT | Objeto de entrada incorreto foi fornecido | Substitua a entrada por uma string de URL direto de vídeo. |
| VIDEO_UNAVAILABLE | Vídeo inutilizável de causa desconhecida | Verifique a validade do link e o formato do ID do vídeo. |
| AGE_RESTRICTED / LOGIN_REQUIRED | Vídeo fora do escopo público | Escolha uma origem acessível; não existe promessa de contorno. |
| ACCESS_BLOCKED / TEMPORARY_FAILURE / TRANSCRIPT_PARSE_FAILED | Ocorreu uma falha de solicitação ou de análise | Inspecione isRetryable e execute uma nova tentativa posterior e limitada somente se o valor for true. |
Sempre verifique os seus diagnósticos de erro com estas categorias documentadas. Tome a ação corretiva precisa com base no código retornado, em vez de adivinhar causas não verificadas.
Fontes e leituras adicionais
Por Chronometrica · Atualizado
Voltar ao topo ↑