収集の設定
Reddit Comments Scraperは、既知の公開スレッドからコメントの行を返します。投稿自体の行を別途返すものではありません。入力には、`postUrls`(公開スレッドのURLを1~50件)と`maxCommentsPerPost`(投稿ごとに1~500件、デフォルト100件、プリセット250件、試験収集では既知の1スレッドに対して上限3件)が必要です。
エクスポートされる各行には、`postId`、`commentId`、`parentId`、`depth`、`body`、`status`、`unavailableFields`、`observedAt`という正確な名前のフィールドが含まれます。データセットの行の状態値は、`ok`、`deleted`、`removed`に厳密に限定されます。実行や入力結果の一部完了・失敗という状態は、行の状態値とは別に扱います。
今回の確認では、OUTPUTの`isComplete=true`フラグは処理が終了したことを示しますが、入力全体の結果は一部のみ取得された状態です。`inputResults`には`status`、`reason`、`commentsFound`、`commentsSaved`が含まれ、`hiddenBranchesRemaining`はnullの場合があります。現在の試験収集では、本文のあるIDが3件返され、`parentId`、`depth`、返信の分岐情報は取得できず、removed/deletedの行はありませんでした。この結果が示すのは範囲を限定した収集ができたことであり、モデレーションをリアルタイムで追跡するパネルや完全な履歴が得られたことではありません。投稿者の欠損と本文の欠損は異なります。原因を推測したり、欠損した文章を復元したりしてはいけません。
Reddit Moderation Research Dataset Taskを開き、公開されている実行プリセットを確認してください。
欠損テキストを記録する8つの手順
- 集計する前に、研究の単位とスナップショットの範囲を定義してください。指定したスレッドで、1回の収集時点に観測したコメントの識別情報を対象にします。識別情報を確定できないIDは別に扱ってください。取得元に表示された件数や未確認の返信分岐を、観測した行数を用いる分母に混ぜてはいけません。
- 取得元からのエクスポートと出力ファイルを、変更せずに保存してください。識別情報が判明している各コメントについて、状態、本文の利用可否、取得できなかったフィールド、観測時刻を保持します。本文だけの整った表にするために、除去や削除が示された位置を消してはいけません。
- 実際に利用できる本文だけを含む、テキスト分析用の作業サブセットを作成してください。本文の代わりに表示される文言は含めません。投稿者が欠損していることは、別の事実として保持してください。研究のルールによっては、投稿者が不明でも、表示されている本文は利用可能なテキストとして扱えます。
- 観測した識別済みの位置、本文を利用できる位置、除去マーカー、削除マーカー、その他の利用不可または不確実な位置の件数を報告してください。単純集計では互いに重ならない区分を使い、分類ルールを明記します。状態が重複していたり、識別情報が食い違っていたりする場合は、合計を無理に合わせず、該当する記録を確認してください。
- すべての割合に、分析で使った分母を併記してください。本文を利用できる行に占める割合と、観測したすべての位置に占める割合では、答える問いが異なります。どちらも、観測していない議論全体を推定するものではありません。
- 繰り返し確認する場合は、取得元で識別情報が判明しているコメントだけを結合し、観測した状態を比較してください。新たに観測されたキーと、観測されなくなったキーは、同じキーで確認された状態遷移とは別に扱います。後の件数上限付きスナップショットに存在しないことは、削除の証拠にはなりません。
- 帰属を裏付ける独立した証拠がない限り、状態の変化をモデレーター、投稿者、ポリシー、検閲、感情分類のいずれかに帰属させてはいけません。利用できない本文は、その前後の返信だけでは分類できません。
- スナップショットごとの本文の利用可否を示す表を作成し、裏付けがある場合は、キーを照合した状態遷移表も作成してください。収集の制約と不明点を明示し、どの本文を分析に含めたのかを別の研究者が理解できるようにします。
以下の表の識別情報、状態、指標はすべて説明用に作成した架空のものであり、実際に測定したモデレーションの結果を示すものではありません。
スナップショットA:10個のキーで観測した状態の表(架空)
| キーID | 取得元の状態 | 本文の利用可否 | 件数/割合 |
|---|---|---|---|
| C1–C7 | ok | 利用可能 | 7行(70%) |
| C8–C9 | removed | 利用不可 | 除去マーカー2件(20%) |
| C10 | deleted | 利用不可 | 削除マーカー1件(10%) |
- 分母の詳細:本文を利用できる割合は7/10 = 70%、利用できない割合は3/10 = 30%です。架空の感情分類器が、利用可能な本文7件のうち4件を肯定的と分類したとします。4/7は約57.1%であり、これは分析可能なテキストだけを対象とした割合です。「全コメントの40%が肯定的」と記述してはいけません。また、内容が不明な本文にラベルを付けてはいけません。
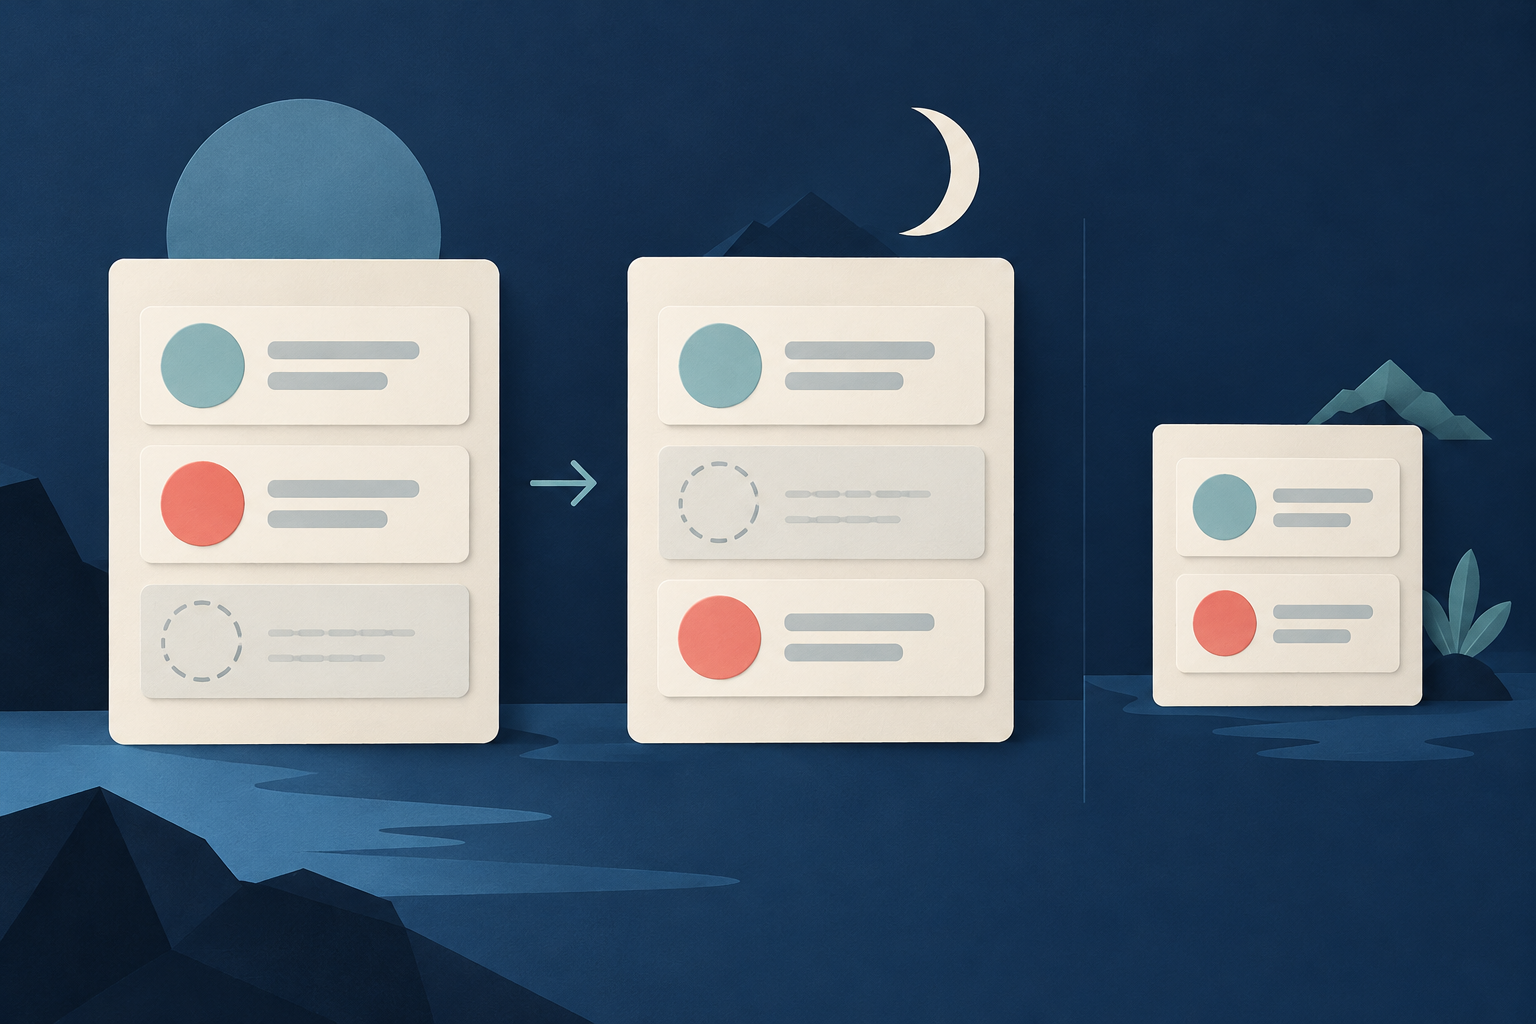
スナップショットB:照合した10個のキーの状態表と状態遷移台帳(架空)
スナップショットB:照合したキーをグループ化した表(架空)
| キーID | SnapshotAstatus | SnapshotBstatus | 状態遷移 |
|---|---|---|---|
| C1–C6 | ok | ok | 変化なし |
| C7 | ok | removed | 変化あり |
| C8–C9 | removed | removed | 変化なし |
| C10 | deleted | deleted | 変化なし |
- スナップショットBの指標:利用可能6件、除去3件、削除1件(変化のないキー9個と、変化したキー1個)。この架空の表は、分母を使った計算を説明するものであり、実際のモデレーションの結果を示すものではありません。
- スナップショットBの指標:利用可能6件、除去3件、削除1件。本文を利用できる割合は6/10 = 60%で、スナップショットAから10パーセントポイント低下しています。これは、実測したモデレーションの効果、除去の原因、コミュニティの傾向を示すものではありません。
スナップショットC:範囲の比較に関する注記(架空)
- スナップショットCでは合計8個のキーが返されます(以前のキー7個と新しいキーC11が含まれ、C1、C2、C3は含まれません)。
- この範囲を限定したスナップショットにC1、C2、C3が存在しないことは、削除の証拠にはなりません。
- Cには本文の区分が示されていないため、本文を利用できる割合は計算しないでください。
出典と参考資料
著者 Chronometrica · 更新日
ページの先頭へ ↑