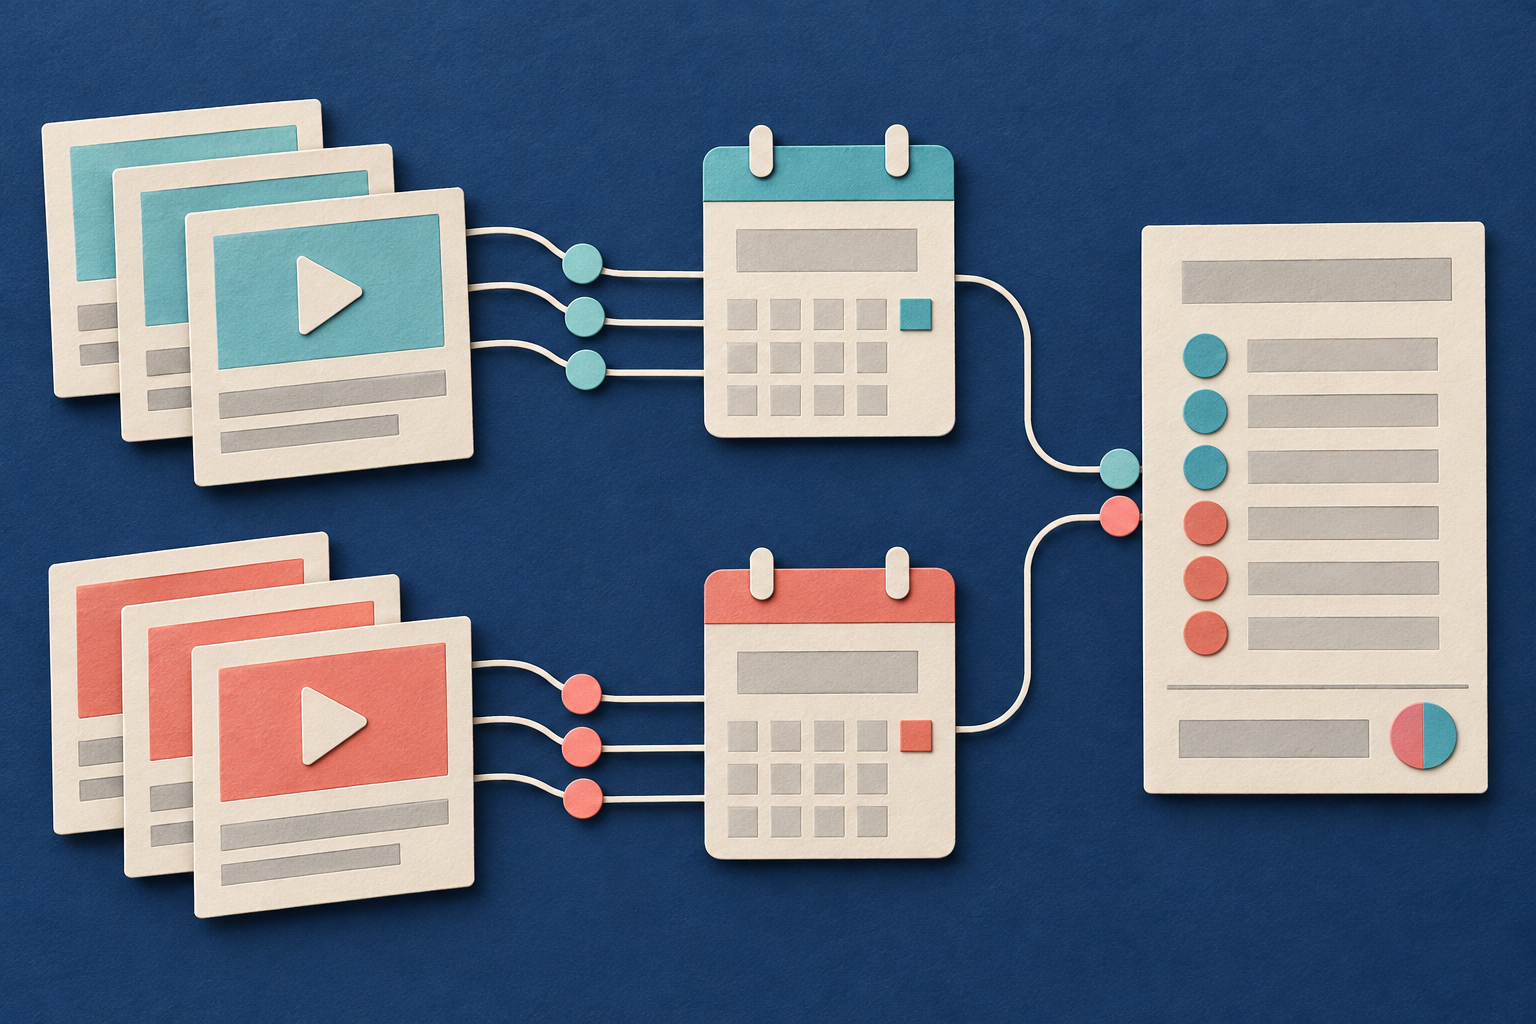
スナップショットとは、ある収集時点の測定値を保存したものです。観測記録とは、その測定値を保存したレコードです。本ガイドでは、Instagramの公開指標をすでに収集している開発者向けに、インポート方法を提案します。この方法は履歴を保持し、同じデータの再インポートを新たな確認として誤って記録することを防ぎます。
収集プログラムは、収集元の行を返します。以下で説明する固定のキー、保存ルール、再開時の確認は、インポート処理に組み込む必要があります。この記事のための収集実行やインポートテストは行っていません。
保存する各行の意味を定める
公開の投稿で、ある読者が「新しいInstagramのKPIに似た曲線を作るため、投稿のパフォーマンスを24時間ごとに分析する」ことについて質問していました。この文面から、繰り返し測定する必要性が読み取れます。ただし、再試行の設計は示されていません。ここで紹介する安全なインポート方法は、その要件を広げた設計案です。読者の質問:2026年8月12日に確認。投稿日は不明。製品の利用も未確認。
毎日実行するように設定するだけでは、信頼できる履歴は作れません。次の2つの出来事も区別する必要があります。
- 新しい収集:プログラムが投稿を再び確認します。新しい観測記録を保存します。
- 同じデータの再インポート:アプリが保存済みの行を再び読み込みます。既存の観測記録を保持します。
この2つの出来事では、数値が同じ場合もあります。2回の確認でどちらも閲覧数が100だった場合でも、観測記録は2件です。収集済みの1行を2回読み込んだ場合は、観測記録は1件のままです。
回数と人数を区別します。公開されている閲覧数は、重複を除いた人数ではありません。`views`、`plays`、`playsInstagram`は別々のフィールドとして保持します。レポートのルールを定めずに、これらを合算したり、互いの代わりに使ったりしないでください。
この方法が扱うのは公開されている数値です。アカウントの非公開インサイトを取得したり、保存していない過去の数値を復元したりするものではありません。所有者だけが閲覧できる記録には、別の認可されたデータソースが必要です。確認した公開仕様は、現在の公開指標の収集に対応しています。過去の数値の復元に対応するものではありません。Instagram Metrics Scraperの仕様:2026年10月25日に確認。公開ビルドの調査のみ。有料実行は未実施。
最近の投稿を探す方法と、保存済みURLを確認する方法のどちらを使うか決まっていない場合は、Instagramの定期収集ガイドを参照してください。インポートを設計する前に、この選択を済ませます。
観測テーブルとインポート処理記録を保持する
役割が異なる2種類の記録を使います。観測テーブルには、収集した測定値を保存します。インポート処理記録には、収集元の実行結果をアプリがどのように処理したかを記録します。
実行とは、収集プログラムを1回動かすことです。データセットとは、そのプログラムが返した行を保存した一覧です。保存した観測記録を収集元までたどれるように、両方の識別子を保持します。
以下の名前は、保存用フィールドの提案です。`run_id`や`item_position`などのフィールドは、ワークフローのメタデータ、つまり収集とインポートに関する情報です。Actorの新しい出力フィールドではありません。Actorとは、ホスティング環境で動く収集プログラムです。
| 保存フィールド | 保持する内容 | 目的 |
|---|---|---|
| `observation_key` | 収集元の行を一意に識別するキー | 同じ行の重複挿入を防ぐ |
| `run_id` | 完了済みの収集元の実行IDを文字列として保持 | 収集の実行を識別する |
| `dataset_id` | 収集元のデータセットIDを文字列として保持 | 収集元の一覧を識別する |
| `item_position` | 元の行の絶対位置 | 変更前の行を識別する |
| `postId` | 元の投稿IDを文字列として保持 | 複数の実行に含まれる同じコンテンツを対応付ける |
| `postUrl` | 元のコンテンツURL | コンテンツの参照先を保持する |
| `scrapedAt` | 元の収集時刻 | 履歴上の測定時点を示す |
| 各指標の数値 | 返された各指標の数値を個別に保持 | 指標の意味を保つ |
| ステータスフィールド | 元の指標と行のステータス | 値が欠損している理由や利用できない理由を示す |
| `original_json` | 元の行全体 | 収集元の証拠を保持する |
| `imported_at` | アプリが行を保存した時刻 | インポート作業を別に追跡する |
JSONは、構造化データを表すテキスト形式です。フィールド名の変更、フィールドの削除、収集元の1行を複数のレコードに展開する処理を行う前に、元のJSONを保存します。
`postMetricStatus`、`status`、`statusReason`が返された場合は保持します。その他のステータスフィールドも、元のJSON内に保持します。ステータス値を作り出したり、文書にないステータス構造を想定したりしないでください。確認した出力仕様には、コンテンツの識別情報、各指標の数値、収集時刻、ステータスフィールドが含まれています。公開デフォルトビルド:2026年10月25日に確認。文書に記載されたフィールドのみ。実行テストは未実施。
インポートを試みるたびに、次の詳細を含む処理記録を保存します。
- 実行ID、データセットID、収集元の完了状態。
- 固定したエクスポート設定と、インポート対象の収集元の行範囲。
- 受け入れた行、重複した行、拒否した行。
- 処理結果の永続保存が完了した、収集元の最後の位置。
- インポートの開始時刻、終了時刻、完了状態。
- 行を拒否した理由。
「受け入れ」は、新しい観測記録を保存したことを意味します。「重複」は、同じ収集元の観測記録がすでに保存されていたことを意味します。「拒否」は、定めたルールに従って、その行の修正や確認が必要なことを意味します。
インポートを試みた回ごとに、件数を分けて保持します。複数回の再試行の処理記録を合計しても、重複を除いた観測記録の件数にはなりません。
行を読み込む前に観測キーを決める
キーとは、1件のレコードを識別する値です。観測キーは、Instagramの投稿だけでなく、収集元の行を識別する必要があります。
`postId`だけを使うと、その投稿に対する以後の確認がすべて統合されてしまいます。インポート時刻を使うと、再試行のたびに新しい観測記録が作られます。キャプションや、クリエイターのプロフィール一覧での位置も、収集済みの観測記録を識別するためには使えません。
内容が安定した完了済みのデータセットでは、実行IDと、データセット内の元の項目位置を使います。そのキーとともにデータセットIDも保持します。実用的な保存ルールとして、実行ID、データセットID、項目位置の組み合わせを一意にします。
一意性のルールは、同じ組み合わせを持つ2件のレコードがテーブルに保存されることを防ぎます。挿入前のアプリコードによる確認だけに頼らず、保存先でこのルールを適用します。
次の手順で進めます。
- レポートのルールで安定した完了済みデータが必要な場合は、完了済みの収集元の実行を選びます。
- その実行IDとデータセットIDを保存します。
- 生データのエクスポート設定を固定し、収集元の順序を昇順に固定します。
- インポートする予定の収集元の範囲を記録します。
- 行の並べ替え、絞り込み、展開を行う前に、元の絶対位置を割り当てます。
- 再試行のたびに、これらの位置を変更せずに使います。
絶対位置とは、収集元の一覧全体での位置です。あるページに位置0から99が含まれる場合、次のページは100から始まります。0には戻りません。位置を0と1のどちらから数えるかを明記します。
Apifyの文書では、データセットの保存は追記専用とされています。項目は追加できますが、既存の項目は変更も削除もできません。この性質は、収集元の行の保持に役立ちます。ただし、それだけで、絞り込みや並べ替えを行ったエクスポートの位置を、安全なインポート用識別情報として使えるわけではありません。Apifyのデータセット文書:2026年10月25日に確認。追記専用の保存と取得に関する事実を示すもので、インポートを保証するものではない。
収集元の位置を固定して保持できない場合は、表現形式を固定した元の行からハッシュを作り、その方法を文書化します。ハッシュとは、内容から計算して作る識別子です。再試行のたびに、同じフィールド、同じテキスト表現、同じ計算方法を使います。実行とデータセットの参照情報も保持します。
この代替方法には注意が必要です。内容が同じ行は、収集元での位置が違っていても、同じハッシュになる場合があります。この方法を使う前に、それらの行を1件の観測記録とするか、2件とするかを定めます。返された行をすべて保持する必要がある場合は、固定した収集元の位置を使う方法を優先します。
既存のキーに対応する元の内容が異なる場合は、処理を止めて矛盾を確認します。保存済みの観測記録を黙って上書きしたり、通常の重複として扱ったりしないでください。
行と進捗を1つの操作で保存する
再開時の主なリスクは、行の保存と進捗の保存の間にあります。一方が成功し、もう一方が終わる前に、アプリが停止することがあります。
トランザクションとは、関連する変更を1つの操作として保存する仕組みです。保存先のツールがトランザクションに対応している場合は、受け入れた観測記録と、その進捗位置をまとめて確定します。関連するインポート処理記録の変更も、その確定内容と整合させます。
次の順序でインポートします。
- 収集元の次の行を、元の位置とともに読み込みます。
- 各行が受け入れルールを満たすか確認します。
- その行の観測キーを作ります。
- そのキーが存在しなければ、新しい観測記録を挿入します。
- 一致する既存の観測記録があれば、重複として数えます。
- 拒否した行と、その理由を記録します。
- 行と拒否記録の永続保存が完了してから、進捗を保存します。
永続保存とは、インポート処理が停止しても変更が残るように、保存システムが変更を保存することです。
ある指標の数値が欠損しているだけで、それ以外は有効な収集元の行を拒否すべきではありません。その行には、収集を試みた事実や、取得できた他の数値を記録できます。欠損値と、そのステータスを保持します。
拒否した行を確認できるように、収集元の情報を十分に保持します。進捗位置が拒否した行を越えても、その行が確認できなくなってはいけません。進捗を進める前に拒否記録を保存するか、問題を解決するまでその位置で停止します。
保存先のツールで行と進捗をまとめて確定できない場合は、進捗を進める前に行を保存します。停止後は、処理済みか不確かな範囲を、同じ一意のキーで再処理します。重複は発生しても、余分な観測記録が作られてはいけません。
再処理の際に、新しい`scrapedAt`を作らないでください。`imported_at`は試行ごとに変わってもかまいません。収集時刻は変更できません。
インポートと再開を例で確認する
以下は、この記事で作成した架空の例です。Actorの出力でも、顧客の成果でも、テスト結果でもありません。すべての時刻は、共通の時刻基準であるUTCで示した、同じ架空の日の時刻です。
実行Aには2行あります。この例では、収集元の位置を0から数えます。
| 実行 | 元の位置 | 投稿 | 収集時刻 | 閲覧数 |
|---|---|---|---|---|
| A | 0 | P1 | 10:00 UTC | 100 |
| A | 1 | P2 | 10:01 UTC | 欠損 |
| B | 0 | P1 | 11:00 UTC | 120 |
まず、実行Aをインポートします。テーブルには、P1とP2が2件の観測記録として保存されます。P2の閲覧数は取得できていません。閲覧数が欠損した観測記録として保存されたままになります。
次に、実行Aを再処理します。収集元の2行のキーは、どちらもすでに存在します。観測記録は追加されず、重複が2件報告されます。
続いて、実行Bをインポートします。実行BのP1の行は、実行を示す識別情報が異なります。テーブルにP1がすでに存在していても、新しい観測記録として保存します。
| インポートの試行 | 新しい観測記録 | 重複した行 | 保存済み観測記録の合計 |
|---|---|---|---|
| Aの初回インポート | 2 | 0 | 2 |
| Aの再処理 | 0 | 2 | 2 |
| Bの初回インポート | 1 | 0 | 3 |
計算は次のとおりです。
- 初回インポート:観測記録0件 + 新しい観測記録2件 = 観測記録2件。
- 再処理:観測記録2件 + 新しい観測記録0件 = 観測記録2件。
- 新しい実行:観測記録2件 + 新しい観測記録1件 = 観測記録3件。
2回の実行から、3件の観測記録が得られます。3回の試行で行を処理した回数は合計5回ですが、観測記録が5件あるわけではありません。P2の閲覧数は欠損したままです。0にはなりません。
次に、同じ架空の例で、別の再開手順を考えます。Aの初回インポートが、P1を保存した後に停止したとします。P2はまだ保存されていません。
保存済みの進捗が信頼できる場合は、P2から再開します。この再開で観測記録が1件追加されます。最終的に、テーブルにはAの観測記録が2件保存されます。
進捗が不確かな場合は、Aを最初から再処理します。P1は重複1件として扱われ、P2は新しい観測記録1件になります。この場合も、最終的にテーブルにはAの観測記録が2件保存されます。
Bをインポートした後は、どちらの再開手順でも、同じ3件の観測記録が保存されます。再試行の確認では、この結果を検証します。
履歴を変更せずに最新値を表示する
ビューとは、保存済みのレコードから組み立てた結果です。古い観測記録を置き換えずに、最新の測定値を示すビューを作ります。
有効な観測時刻は、インポート時刻ではなく`scrapedAt`で並べます。昨日の完了済みの実行を今日インポートしても、昨日の数値が今日収集した測定値より新しく見えてはいけません。
投稿ごとに、次の2つの事実を分けて表示します。
- 保存済みの記録のうち、最も新しい収集の試み。
- 必要な指標ごとの、利用可能な最新の測定値と、その値の元の時刻。
新しい行では閲覧数が欠損し、古い行には利用可能な閲覧数がある場合があります。参考として古い値を保持できますが、その古い時刻と、新しい行では欠損していることを表示します。古い値を、新たに測定した値として表示しないでください。
「利用可能な最新の値」は、指標によって異なる場合があります。利用可能ないいね数を含む最新の行と、利用可能な閲覧数を含む最新の行は、同じとは限りません。それぞれの時刻を分けて保持します。
リリース前に、次の場合の並べ方を文書化します。
- 収集時刻が同じ場合:収集元の両方の観測記録を保持します。同時刻であることを表示するか、明記した表示ルールを適用します。表示ルールは、どちらが後の測定だったかを証明するものではありません。
- 収集時刻が欠損している場合:収集元の行は保持します。ただし、確認が済むまでは、時刻に基づく並べ替えの対象から除きます。
- 収集時刻が無効な場合:問題を記録します。明確な表示をせずに、インポート時刻で代用しないでください。
- 行が返されなかった場合:収集の欠落を別に記録します。観測記録や数値0を作り出さないでください。
その後の計算には、Instagramの月次レポートガイドを参照してください。このインポート方法は観測記録を保持するものです。欠損している月の境界時点の測定値を確定するものではありません。指標の履歴ガイドでも、確認に空白期間がある場合に、実際の観測時刻が重要になる理由を説明しています。
小規模な収集入力を使い、インポートを確認する
ChronometricaのInstagram Metrics Scraperには、コンテンツを直接指定する入力と、この保存方法の案に必要なフィールドが文書化されています。文書上で要件に合っているからといって、履歴テーブルの作成やインポートキーの強制まで行うわけではありません。
Taskとは、Actorの入力設定を保存したプリセットです。公開されているInstagram Post Metrics Tracker Taskを出発点として使えます。提示されたページの確認では、公開されていることだけを確認しました。認証が必要な保存済み設定の確認や、プリセットの実行は行っていません。Instagram Post Metrics Tracker:2026年10月25日に確認。公開ページの存在のみ。認証を伴う入力確認と有料実行は未実施。
提示された次の小規模な入力を使います。
{"maxItems":1,"mode":"contentUrls","startUrls":["https://www.instagram.com/reel/DIwcCZgxVZP/"]}`mode`は、Actorが入力を処理する方法を指定します。`contentUrls`は、コンテンツを直接確認する方法を選びます。`startUrls`には、対象コンテンツのURLを指定します。`maxItems`は、返される指標データの行数を制限します。
サンプルURLを、公開されていることが分かっている投稿またはリールのURL1つに置き換えます。リールはInstagramの動画形式です。サンプルURLの横に自分のURLを追加するのではなく、サンプルの一覧を置き換えます。使用前に保存済み設定を確認します。
この入力は、静的なスキーマ検証に合格しています。スキーマとは、データの構造や形式を定めたものです。この検証は、提示された公開スキーマに入力形式が合っていることを確認するものです。実際のコンテンツが利用可能なことや、収集が成功することを確認したものではありません。公開入力スキーマ:2026年10月25日に確認。静的検証のみ。有料実行は未実施。
読者が行う確認として、次の手順を提案します。
- 対象の公開コンテンツを1件収集し、完了済みの実行とデータセットの参照情報を保持します。
- その行をインポートし、受け入れ、重複、拒否の件数を記録します。
- 同じ収集元を再びインポートします。新しい観測記録が0件であることを確認します。
- インポートを途中で停止し、再開します。最終的な収集元の行キーが、一度に最後までインポートした場合と一致することを確認します。
- 同じコンテンツを新たな実行で収集します。新しい観測記録が作られることを確認します。
- 保存したすべての`scrapedAt`の値が、収集元の行と一致することを確認します。
- 欠損している指標の数値が欠損したままであることを確認します。古い利用可能な数値が、元の時刻を保持していることも確認します。
実行が完了していても、指定したすべてのコンテンツで利用可能な指標の数値が得られたとは限りません。対象コンテンツの一覧と返された行を比較し、欠落を別に記録します。
出典と参考資料
- Instagram Metrics Scraperの公開仕様:2026年10月25日に確認。公開の入力と出力を文書で確認。有料実行と、現在の実行時の正常性を確認するテストは未実施
- 公開デフォルトビルド1.0.35:2026年10月25日に確認。スキーマと文書に記載されたフィールドの根拠。実行時の動作を測定したものではない
- Apifyのデータセット文書:2026年10月25日に確認。追記専用の保存と取得に関する根拠。インポート用の識別情報を固定するには、収集元の順序の固定も必要
- Instagram Post Metrics Tracker Task:2026年10月25日に確認。公開プリセットの存在のみを確認。認証を伴う保存済み設定の確認と有料実行は未実施
- 繰り返し測定に関する質問:2026年8月12日に確認。投稿日は不明。公開の質問1件であり、需要や製品利用の証拠ではない
著者 Chronometrica · 更新日
ページの先頭へ ↑