プロフィールの繰り返しスキャンで要件を満たせる場合は、WebDataLabs Instagram Posts and Reels Scraperを選びます。公開仕様には、プロフィールからの投稿検索で得られるリールの閲覧数とメディアリンクが記載されています。一方、投稿やリールの直接リンクからは、リールの閲覧数を取得できないと明記されています。WebDataLabsのActor
選択を左右する主な制限があります。Chronometricaも、保存済みコンテンツURLからの閲覧数取得を保証していません。閲覧数が必須で、直接URLを使う方法では欠損する場合は、その手順を採用する前に、プロフィールからの投稿検索や別のデータソースを試してください。ChronometricaのActor
Replitアプリでは、スケジュールに沿ってデータを収集し、その後APIを通じてアプリを更新する設計から始めるとよいでしょう。APIは、あるプログラムが別のプログラムに処理やデータを要求するための仕組みです。重要なのは、各収集処理で何を確認するかです。クリエイターの最近のコンテンツを確認するのか、それとも保存済みの投稿リストを確認するのかを決めます。
まず、アプリの定期更新に必要なことを決める
インフルエンサー追跡アプリについての公開ディスカッションでは、定期的なデータ収集をReplitと連携する方法が質問されています。Webhookとスケジュール実行するAPIポーリングのどちらを使うかも論点です。ここで必要なのは、他者のインフルエンサー投稿に関する公開指標の更新です。これは、連携方法を考えるうえで有用な質問です。ただし、ベンダーの推奨でも、検証済みの製品テストでもありません。読者のディスカッション
この比較で対象とする指標は、公開されているいいね数、コメント数、取得可能な閲覧数または再生数です。提案する設計には、非公開の投資収益率データ、コンバージョン、リーチ、保存数、シェア数、クリエイターの全履歴は含みません。
読者は、固定のコンテンツURLリストが必要だと明示していません。URLの保存は、定期更新のために提案する設計です。クリエイターのプロフィールに新しい投稿が追加された後も、同じ投稿を確認し続ける必要があるアプリに適しています。
Actorを選ぶ前に、アプリの役割を1文で定義してください。例えば、「予定した各確認で、キャンペーンに保存済みの投稿の公開数値を更新する」と書きます。この要件には、個別コンテンツの入力が適しています。一方、クリエイターの最新投稿を見つけるという要件には、プロフィールからの投稿検索が適しています。
この違いは、製品がInstagramのURLを入力として受け付けるという事実よりも重要です。プロフィールURLとコンテンツURLでは、収集プログラムに要求する処理が異なります。
投稿検索と保存済みコンテンツリストを選び分ける
プロフィールからの投稿検索とは、クリエイターのプロフィールを起点にコンテンツを見つける方法です。新しく公開された投稿が必要なフィードに適しています。各検索では、「このクリエイターの最近の投稿のうち、今どの投稿を見つけられるか」といった問いに答えます。
個別コンテンツの確認では、既存の投稿やリールのURLを起点にします。確認のたびに対象を変えてはいけないキャンペーンリストに適しています。各実行では、「これらの保存済み投稿について、今どの公開数値を取得できるか」を確認します。
クリエイターが投稿を増やすと、ある投稿が最新投稿の取得範囲から外れることがあります。アプリでその投稿を追跡し続ける必要がある場合は、URLを保存すると次回の確認対象を明確にできます。保存済みURLはコンテンツを特定するものです。すべての指標が取得できることを保証するものではありません。
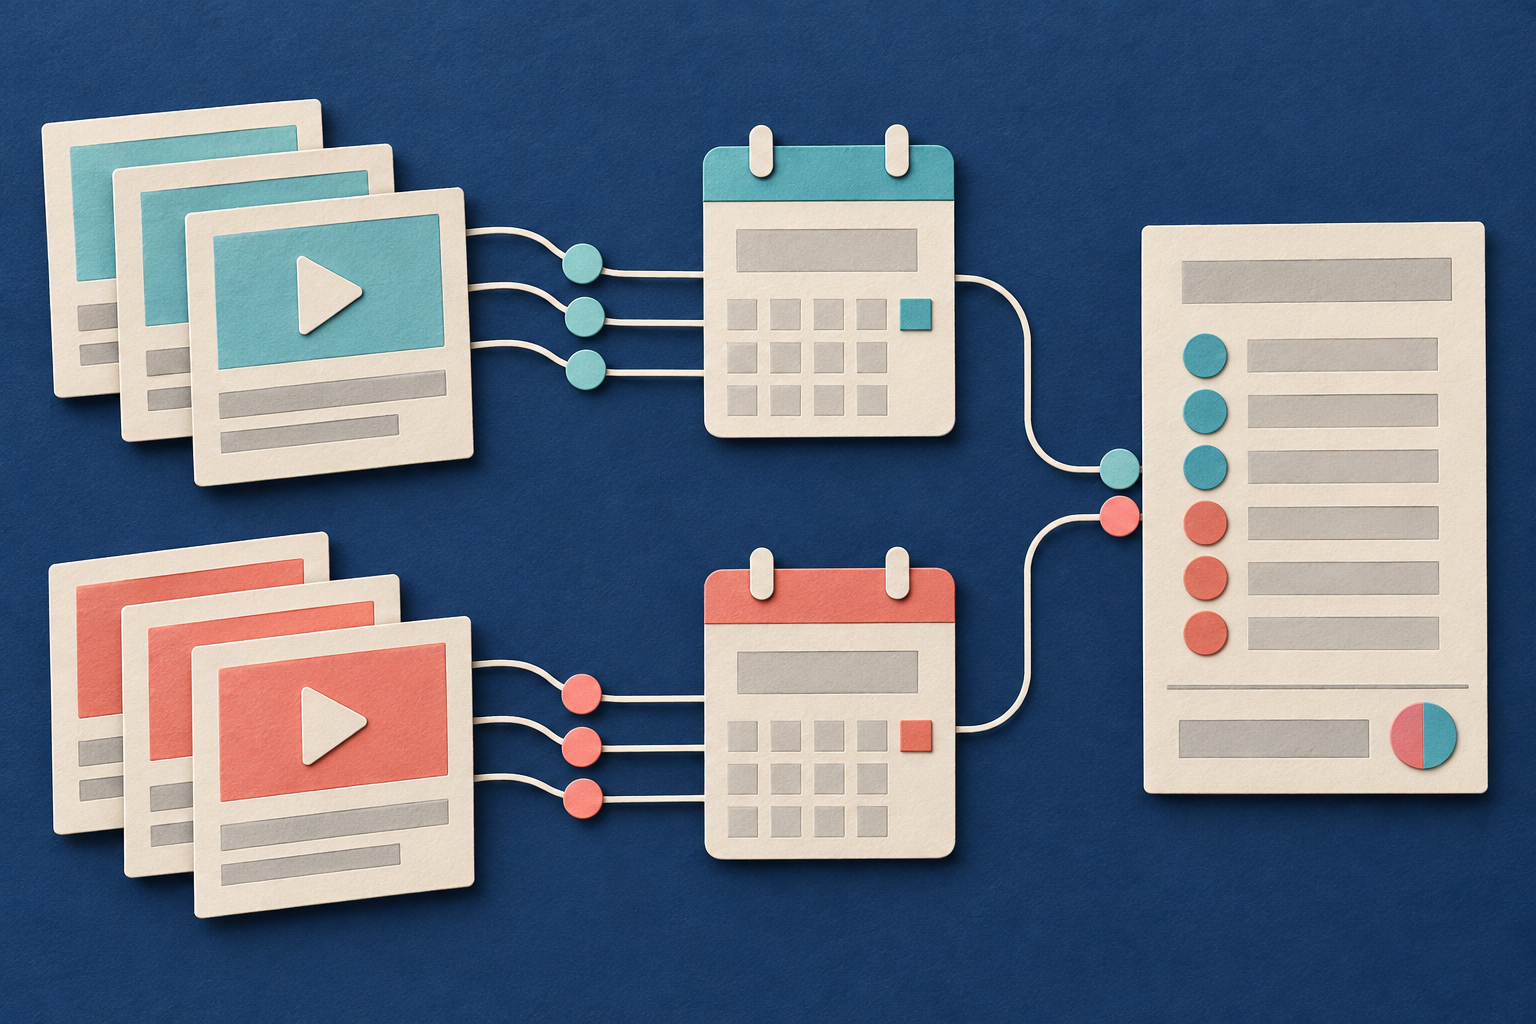
提案する1つの手順の中で、両方の方法を使えます。まず投稿検索を実行して、新しいコンテンツを見つけます。アプリで追跡するコンテンツを確認して保存します。その後の確認には、保存済みリストを使います。追跡対象を決める判断と、計測結果は分けて扱ってください。
Chronometricaは、プロフィールからの投稿検索と個別コンテンツの入力の両方に対応しています。このため、提案する手順に適しています。ただし、実際の出力で必要な数値を確認することが条件です。ChronometricaのActor
データ収集の仕様を比較する
データ収集の仕様には、受け付ける入力と、文書に記載された出力が示されています。収集方法を選ぶために役立ちます。ただし、実際に使う予定のデータソースでの性能を証明するものではありません。
| 判断項目 | Chronometrica Instagram Metrics Scraper | WebDataLabs Instagram Posts and Reels Scraper |
|---|---|---|
| 必要な入力 | 投稿検索にはプロフィール、その後の確認にはコンテンツURL | 文書に記載されたリール閲覧数の取得方法ではプロフィール |
| 必要な出力の単位 | ある収集時点における1件のコンテンツの観測データ | プロフィールから見つけたリールの観測データ |
| 必要なフィールド | コンテンツの識別情報、`scrapedAt`、必要な数値、各数値の取得可否 | 必要なリール閲覧数とメディアリンク |
| 欠損データの扱い | 取得できない数値は欠損のまま保持 | 直接リンクからのリール閲覧数は取得不可と文書に記載 |
| 主な制限 | 個別コンテンツを入力しても、閲覧数の取得は保証されない | 直接リンクからはリールの閲覧数を取得できない |
| 選択を変える条件 | 選んだ方法で必要な数値を取得できない場合 | プロフィールの繰り返しスキャンでアプリの要件を満たせる場合 |
上記の製品情報は、確認済みの公開仕様に基づきます。どちらの製品も、スケジュール実行とAPIの利用に対応しています。自動化できるかどうかだけでは、この比較の結論は決まりません。Chronometricaの仕様、WebDataLabsの仕様
出力の単位の行をよく確認してください。返されたコンテンツのデータ行は、投稿の特定や一部の数値の更新に役立つことがあります。それでも、その行が閲覧数の要件を満たさない場合があります。グラフにつなぐ前に、観測データを利用可能と判断する条件を決めてください。
小規模な定期処理でデータ収集をReplitと連携する
この要件では、スケジュール実行するAPIポーリングから設計を始めるのが妥当です。ポーリングとは、リクエストを繰り返して結果を確認する方法です。以下は、提案する連携手順です。この記事でReplitとの接続をテストしたという意味ではありません。
- アプリのレポート要件に合う収集スケジュールを設定します。新しい投稿を見つけるのか、保存済み投稿を確認するのか、それぞれを別の処理として両方行うのかを決めます。
- 選んだ入力をActorに送信します。要求した項目と返された項目をアプリで比較できるよう、要求したコンテンツのリストを保持します。
- 収集が完了してから出力を受け入れます。収集開始のリクエストを送っただけでは、計測は完了していません。
- APIを通じて、完了した処理の出力を読み取ります。コンテンツの識別情報、収集日時、必須フィールド、数値の取得可否を確認します。
- 採用した各観測データを、収集日時とともに保存します。保存した観測データからアプリを更新します。
- 保存データとアプリの両方で、数値の欠損を明示します。0を表示するのではなく、値を取得できないことを示します。
Webhookとは、イベントの発生時に、あるサービスから別のサービスへ送信するメッセージです。提供された資料では、この比較に使えるWebhookの設定方法は確認できません。提案するポーリング設計なら、未確認の通知機能に依存せず、連携方法の疑問に対応できます。
直近の収集試行と、直近で採用した観測データは、別々に記録します。確認に失敗した場合や、利用できる数値が返されなかった場合は、以前の観測データを元の日時とともに保持できます。ただし、その古い値を新しい計測値として表示してはいけません。
アプリに履歴が必要かどうかも決めてください。前のデータ行を置き換えるだけでも、最新の数値は表示できます。時間の経過に伴う数値を比較するには、以前の観測データを保持する必要があります。今の収集処理で、過去に収集しなかった観測データを作ることはできません。
繰り返し実行を設定する前に、実際の用途に合うサンプルを確認する
最初の受け入れ確認では、アプリの実際の処理を代表するコンテンツを使います。追跡する予定の公開データソースを使ってください。保存済みリールを追跡するアプリなら、その直接URLを確認します。最近の投稿を見つけるアプリなら、プロフィールからの投稿検索を確認します。
まず、コンテンツの識別情報を確認します。返された各項目が、意図した投稿と一致するかを確認してください。コンテンツの正規URLを保存します。これは、確認のたびに同じコンテンツを特定するための、一貫したURLです。プロフィールの投稿リスト内での位置を、投稿の識別情報に使ってはいけません。その位置は変わることがあります。
次に、収集日時を確認します。Chronometricaは`scrapedAt`を出力します。この値を観測データとともに保持し、後から見る人が収集日時を確認できるようにします。公開日時と収集日時は分けて扱ってください。投稿自体が古くても、収集した数値は現在の値である場合があります。Chronometricaの出力仕様
続いて、必要な数値を確認します。Chronometricaは`views`、`plays`、`playsInstagram`を別々のフィールドで出力し、各数値の取得可否も示します。保存時にも、これらのフィールド名を分けて保持してください。レポート上のルールを定義せずに、同じ意味だと見なしたり、合算したり、互いに置き換えたりしてはいけません。Chronometricaの出力仕様
数値ごとに成功条件を定義します。アプリに閲覧数が必要なら、必要な閲覧数の値が取得できた場合にだけ、閲覧数の観測データとして採用します。いいね数とコメント数が使えるデータ行でも、それらの要件は満たす一方、閲覧数の要件は満たさないことがあります。
欠損値は、専用の扱いが必要です。0は、その数値が0であることを示します。欠損は、その数値が不明、または取得できないことを示します。欠損を0に変えると、根拠となるデータが変わり、合計、平均、順位が不正確になるおそれがあります。
最後に、一部だけ取得できた結果をアプリがどう表示するかを確認します。クリエイターのページでは、数値の欠損を明示する必要があります。一部の投稿で有効な閲覧数の観測データがないのに、すべての保存済み投稿が集計に含まれていると受け取れる表示をしてはいけません。表示結果の根拠となる観測データを説明できるだけの情報を保持してください。
観測データの収集後にレポートを作成する方法は、Instagramの月次閲覧数レポートで新旧の投稿を分ける方法を参照してください。そのガイドでは集計方法を扱います。この比較では、定期確認に使う入力を扱います。
架空の例:後で再確認する必要がある10件の投稿
以下は架空の例です。テスト結果、顧客の成果、実測したコスト比較ではありません。
あるアプリが、最初にクリエイターの公開投稿を10件見つけます。アプリの所有者はリストを確認し、その10件を追跡すると決めます。アプリはコンテンツURLと、最初に採用した観測データの収集日時を保存します。
次回の確認予定までに、クリエイターが新しい投稿を公開します。それでも、アプリには元の10件の更新が必要です。最新投稿をスキャンすると、検索結果に含まれるコンテンツが変わる可能性があります。保存済みリストがあれば、意図した対象を明確に保てます。
アプリは、保存済みの10件のURLを個別コンテンツの確認用に送信します。返された各データ行を、最初のサンプルと同じ受け入れルールで評価します。処理が完了しただけで、必要なすべての指標を収集できたとは判断しません。
後の確認で返されたあるデータ行に、利用できるいいね数とコメント数がある一方、閲覧数は取得できなかったとします。アプリは、いいね数とコメント数を採用できます。閲覧数は欠損のままにする必要があります。その行がアプリの別の部分に役立つとしても、閲覧数の観測に成功したことにはなりません。
追跡するすべての項目で閲覧数が必須なら、次に、プロフィールからの投稿検索で欠損している数値を取得できるか試します。その方法でも要件を満たせない場合は、別のデータソースを使うか、レポートで提供すると約束する範囲を狭める必要があります。
この例は、Chronometricaが保存済みリストを使う手順に適している理由を示しています。直接入力の方法によって、確認するコンテンツを指定できます。受け入れ確認によって、アプリで使える計測値を判断します。この2つは別の判断です。
保存済みTaskを初期設定として使う
Taskとは、Actor用に保存した入力設定です。公開されているInstagram Reels Performance Tracker Taskを出発点として使えます。
ページの確認では、Taskページが意図したタイトルで閲覧できることを確認しました。ただし、現在保存されている入力や、例に使われているリールを取得できるかどうかは確認していません。実行前に、以下の現行スキーマに沿った入力を適用してください。
{
  "mode": "contentUrls",
  "startUrls": [
    "https://www.instagram.com/reel/DIwcCZgxVZP/"
  ]
}この入力は、提供された公開スキーマに対する静的チェックに合格しています。静的チェックとは、フィールド名や許可された値など、入力の形式を確認するものです。実際のデータ収集は行いません。この記事のための収集処理は実行していません。
例のURLを、取得したい公開コンテンツのURLに置き換えてください。ここでは、`mode`で個別コンテンツの確認を選び、`startUrls`でコンテンツリストを指定します。文書に記載されたモードの選択肢は、`auto`、`contentUrls`、`profileUrls`です。Chronometricaの入力スキーマ
処理を繰り返す前に、最初のサンプルで出力を確認します。採用したコンテンツの識別情報、収集日時、数値、取得可否を保存します。その後、次回の確認予定時に保存済みURLを再送信します。アプリを更新する前に、返されたコンテンツを要求したリストと比較してください。
必要な観測データを基準に最終判断する
アプリに必要な観測データが得られる方法を選んでください。接続の成功が示すのは、プログラム間でリクエストと結果をやり取りできることだけです。必要な公開数値が存在することは証明しません。
保存済みコンテンツリストには、この比較ではChronometricaを最初の候補として推奨します。確認済みの仕様が直接入力に対応し、数値の取得可否を明示するためです。ただし、必要なフィールドを満たすサンプルが得られることを、推奨の条件にしてください。ChronometricaのActor
必要な閲覧数がない場合は、収集方法を変えるか、別のデータソースを試してください。連携が完成したように見せるために、その受け入れルールを外してはいけません。同様に、プロフィールから最近の投稿を検索するだけでアプリの目的を達成できるなら、固定リストを使う処理を追加する必要はありません。
判断すべきことは具体的です。各実行でどのコンテンツを再確認するのか。どの数値を返す必要があるのか。その数値が欠損した場合にアプリはどう対応するのか。
出典と参考資料
- Chronometrica Instagram Metrics Scraper:2026年10月20日に公開の入出力仕様を確認。プロフィールと個別コンテンツの入力に対応。ただし、直接URLからの閲覧数取得は保証しない。新たな比較実行は行っていない。
- WebDataLabs Instagram Posts and Reels Scraper:2026年10月20日に公開仕様を確認。プロフィールから見つけたリールの閲覧数とメディアリンクが文書に記載されている。直接リンクからはリールの閲覧数を取得できない。新たな比較実行は行っていない。
- Replitのインフルエンサー追跡アプリに関するディスカッション:公開指標の定期取得を連携する方法についての質問。背景情報は2026年10月20日に提供された。別途、実際のページを確認したという報告はない。ベンダーの推奨でも、検証済みの製品テストでもない。
- Instagram Reels Performance Tracker Task:初期設定に使うプリセットのページ。2026年10月20日に提供されたページ確認の資料では、ページを閲覧できることと、意図したタイトルを確認している。ただし、現在保存されている入力や、例のリールを取得できるかどうかは確認していない。収集処理は実行していない。
- Instagramの月次閲覧数レポートで新旧の投稿を分ける方法:観測データ収集後の分析を扱う。ガイドの対象範囲は2026年10月20日に提供された。新たにページを確認したという報告はない。スナップショットの取得後に、レポートの集計方法を考えるために使う。
著者 Chronometrica · 更新日
ページの先頭へ ↑