Prepará tu plan de recolección
La entrada pública guardada de la Task usa tres consultas de muestra, `expandQueries` en false, un tope compartido de `maxResults` de 150 videos distintos, `resultsPerQuery` en 50, `maxPagesPerQuery` en 1 y `searchDistribution` en "balanced". Reemplazá esas consultas de muestra por tus términos objetivo antes de ejecutar un panel completo.
Para verificar tu configuración en el build público de Search 1.1.5, empezá con una ejecución piloto acotada. Reemplazá la lista de consultas de muestra por un término previsto. Configurá `expandQueries` en false, `maxExpandedQueries` en 0, `maxResults` en 2, `resultsPerQuery` en 2, `maxPagesPerQuery` en 1 y `searchDistribution` en "balanced".
Una comprobación de referencia con "python tutorial" devolvió dos filas de metadatos con identificadores de publicación, URL de publicación, identificadores de autor, nombres de usuario, fechas de publicación de mayo y de agosto, y un motivo de detención de OUTPUT igual a `max_results_reached`. Este piloto confirma los campos básicos de búsqueda y la procedencia, pero no es una referencia de tendencias de varias consultas ni una prueba de campaña publicitaria.
Campos nativos del conjunto de datos y evidencia de la ejecución
Los registros nativos del conjunto de datos incluyen `postId`, `postUrl`, `authorId`, `profileHandle`, `publishedAt` y `observedAt`. Los campos de procedencia de la búsqueda registran el contexto de la consulta: `rootQuery` es la familia original, `query` es el término de búsqueda ejecutado y `querySource` identifica el origen de ese término. Los campos `pageIndex` y `pageRank` registran la posición en la página de origen recolectada. Los campos `status` y `statusReason` informan los estados de resultado a nivel de ítem. Los campos opcionales quedan en null si faltan en el origen.
El objeto `OUTPUT` aporta evidencia de la ejecución y no un mapeo automático de consultas. Los campos clave incluyen:
- `queriesSearched`: arreglo de términos realmente ejecutados.
- `queryPlans`: lista planificada de definiciones de consulta, raíz y origen.
- `effectiveResultsPerQuery`: límite reducido de videos guardados por término, calculado durante la distribución equilibrada.
- `rowsSaved`: total de videos distintos escritos en el conjunto de datos.
- `duplicatesSkipped`: videos candidatos omitidos por la desduplicación global.
- `stopReason`: estado de detención general de la ejecución, por ejemplo `max_results_reached`.
- `sourceStatusCounts`: estados de origen agregados, por ejemplo `{ok: 1}`.
- `status` y `statusReason`: resultado de ejecución de nivel superior, por ejemplo `status: "ok"` y `statusReason: null`.
En la ejecución de control de una sola consulta, `OUTPUT` informó `stopReason: "max_results_reached"`, `rowsSaved: 2`, `sourceStatusCounts: {ok: 1}`, `status: "ok"` y `statusReason: null`.
Una fracción útil se define como los videos relevantes revisados con ID conocido, divididos por la muestra comparable de candidatos revisables de ese término intentado; los términos fallidos o no intentados no tienen una fracción válida.
Prepará tu plan de recolección
- Definí tu pregunta de investigación y las familias de consultas antes de buscar. Agrupá términos solo cuando representan el mismo concepto y conservá una lista explícita de consultas.
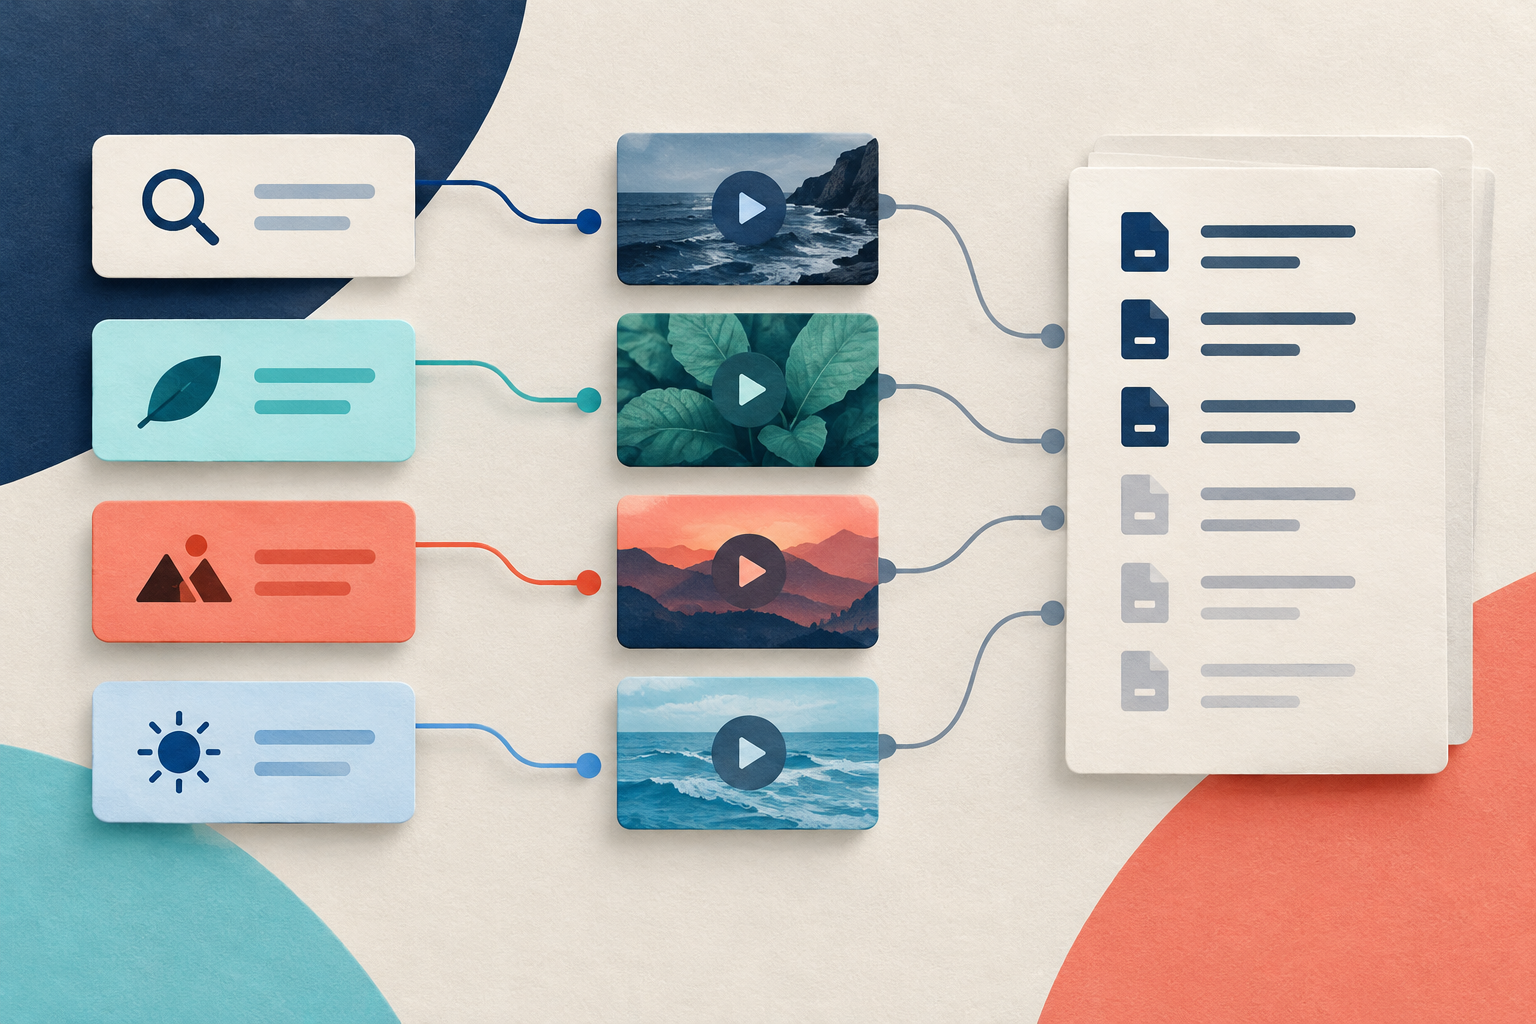
- Configurá el `maxResults` compartido, `resultsPerQuery`, `maxPagesPerQuery`, la opción de expansión y `searchDistribution`. Desactivá la expansión cuando compares una lista fija exacta. Un `maxResults` compartido actúa como tope total de videos guardados entre todas las consultas, mientras que `resultsPerQuery` limita cada término.
- Elegí la distribución equilibrada cuando necesitás una cuota planificada entre términos. Elegí la distribución secuencial solo cuando tu objetivo sea completar primero los términos anteriores. La distribución equilibrada puede reducir `effectiveResultsPerQuery` para repartir el límite total, pero no garantiza que se completen las cuotas ni que la asignación no usada se reasigne.
- Separá el presupuesto planificado de los datos útiles reales. Registrá el estado de intento, las filas guardadas, los ID de video conocidos, los duplicados, la identidad faltante y los estados de falla del origen. Cero filas útiles después de una falla del origen indica disponibilidad desconocida, no un interés nulo en el tema.
- Conservá la procedencia y tratá con cuidado la desduplicación global. Procedencia significa conservar el origen guardado exacto y la hora de recolección registrada en `observedAt`. La desduplicación global nativa guarda un video una sola vez, bajo la primera consulta en la que se observó. Para capturar cada aparición en una consulta, conservá registros de ejecución separados por consulta.
- Aplicá la misma regla manual de relevancia a todos los grupos. Distinguí los videos candidatos de los ítems útiles comprobando los valores exactos de `postId` y `postUrl`. Calculá las fracciones útiles solo con datos intentados y utilizables, y tratá los términos fallidos o no intentados como desconocidos.
- Informá las brechas antes de comparar grupos. Marcá los términos no intentados como `not_attempted` y no como cero, y mantené visibles los topes del origen. Nunca ordenes los grupos de consultas solo por totales brutos cuando los límites de recolección o las fallas son distintos.
- Guardá tu plan de consultas y el registro real de la muestra. Revisá campos de `OUTPUT` como `queriesSearched`, `queryPlans`, `rowsSaved`, `duplicatesSkipped` y `stopReason` para anotar la evidencia exacta de detención antes de hacer un análisis de tendencias o un análisis de piezas publicitarias.
Registros de recolección ficticios originales
Todos los valores de abajo son ficción original creada para ilustrar presupuestos de recolección, estados de detención y límites de la desduplicación global. No representan referencias del producto en vivo ni resultados del piloto.
Considerá tres términos, A, B y C, con `maxPagesPerQuery` en 1, expansión desactivada, `maxResults` en 6 y `resultsPerQuery` solicitado en 6.
- Ejecución equilibrada: el `effectiveResultsPerQuery` informado es 2 y crea un límite planificado de 2 videos guardados por término. Si cada término devuelve 2 videos relevantes distintos, el registro muestra A=2, B=2, C=2 y guarda 6 videos en total. La fracción útil es 2/2 para cada término.
- Ejecución secuencial: el límite configurado por término es 6 para los términos A, B y C. El término A devuelve 6 videos guardados y completa el tope compartido de `maxResults` de 6. Los términos B y C nunca se intentan. El registro anota un máximo planificado de 6 para cada término, con A=6 guardados, B=0 guardados (`not_attempted`) y C=0 guardados (`not_attempted`). Anotar 0 filas guardadas para B y C es contabilidad; la disponibilidad de su muestra sigue siendo desconocida.
- Falla de origen en la ejecución equilibrada: el término A guarda 2 videos útiles (fracción 2/2), el término C guarda 2 videos útiles (fracción 2/2) y el término B encuentra un error de origen. El término B registra 0 filas guardadas, 0 filas útiles y una fracción de relevancia desconocida. La etiqueta `source_failed` es una notación del registro para el lector, no un valor enumerado nativo del conjunto de datos.
| Término de consulta | Modo | Máximo planificado | Intentado | Filas guardadas | Filas útiles | Motivo o estado de detención |
|---|---|---|---|---|---|---|
| Término A | Equilibrado | 2 | Sí | 2 | 2 | Límite por consulta alcanzado |
| Término B | Equilibrado | 2 | Sí | 2 | 2 | Límite por consulta alcanzado |
| Término C | Equilibrado | 2 | Sí | 2 | 2 | Límite por consulta alcanzado |
| Término A | Secuencial | 6 | Sí | 6 | 6 | Tope compartido de `maxResults` alcanzado |
| Término B | Secuencial | 6 | No | 0 | Desconocido | `not_attempted` |
| Término C | Secuencial | 6 | No | 0 | Desconocido | `not_attempted` |
| Término A | Equilibrado (falla B) | 2 | Sí | 2 | 2 | Límite por consulta alcanzado |
| Término B | Equilibrado (falla B) | 2 | Sí | 0 | Desconocido | `source_failed` |
| Término C | Equilibrado (falla B) | 2 | Sí | 2 | 2 | Límite por consulta alcanzado |
Registro ficticio de pertenencia a consultas
Una ejecución ficticia de consultas, separada, evalúa las apariciones de videos entre términos sin que la desduplicación global excluya las superposiciones.
| ID de video | Pertenencia al término A | Pertenencia al término B | Pertenencia al término C | Primera consulta conservada |
|---|---|---|---|---|
| V1 | Presente | Ausente | Ausente | Término A |
| V2 | Presente | Presente | Ausente | Término A |
| V3 | Ausente | Presente | Ausente | Término B |
| V4 | Ausente | Ausente | Presente | Término C |
| V5 | Ausente | Ausente | Presente | Término C |
Esta tabla de pertenencia contiene 6 pertenencias en total entre 5 ID de video distintos. Una exportación única con desduplicación global conserva V2 solo bajo el término A. Conservar la procedencia del término A para V2 no prueba que V2 estuviera ausente del término B. La pertenencia completa a las consultas solo se puede seguir si se guardan registros de ejecución acotados y separados para cada consulta.
Fuentes y lecturas adicionales
Por Chronometrica · Actualizado
Volver arriba ↑