先看下一步要做什麼,再做選擇。需要比較職稱、公司和地點的代理,需要的是職缺紀錄。需要尋找更多雇主的代理,需要的是可能有用的來源頁面。這是不同的工作單位。選對單位,下一步就會清楚。
Chronometrica 是我們的工具。我們推薦用它處理本文所述的結構化職缺任務。主要限制在於蒐集範圍:它只蒐集 Google Jobs 在所選搜尋條件與筆數上限下傳回的內容。它不提供完整的雇主索引,也不提供經核實仍在招募的職缺。Actor 文件
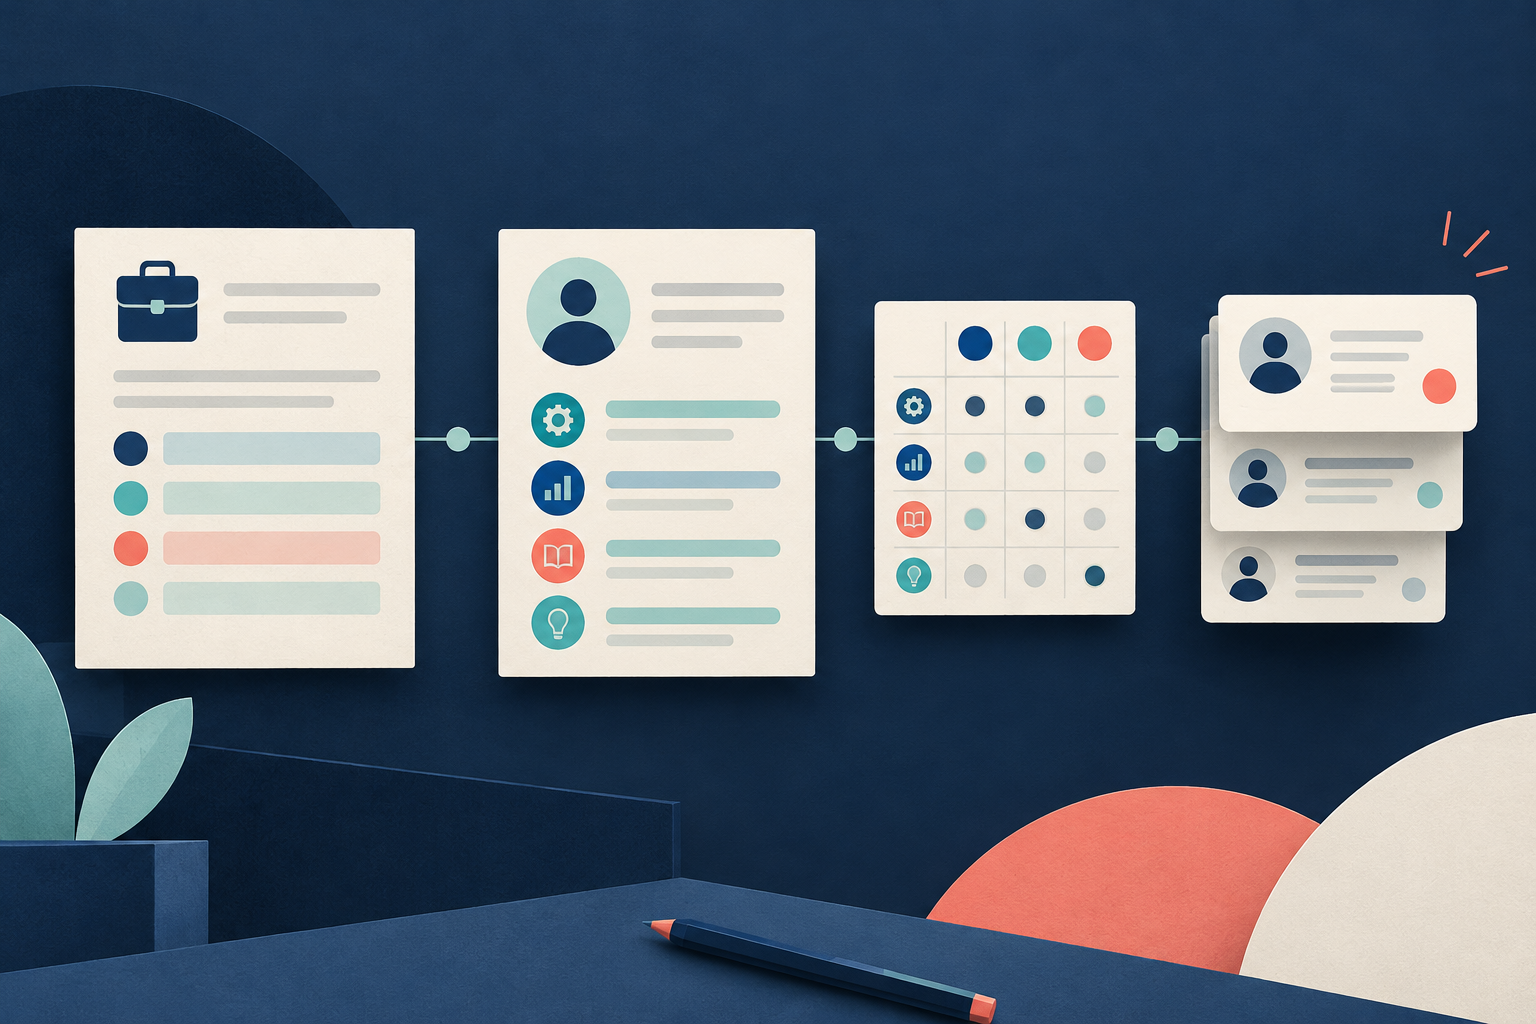
!職缺要求連接到技能證據卡、審查表格,以及一小疊依序堆放的項目。
選擇下一步所需的紀錄
Actor 是在 Apify 上託管執行的資料蒐集程式。在這項比較中,實用的問題是:每筆蒐集到的紀錄,能讓你的代理接著做什麼?
Chronometrica 的文件說明,同一次執行中的每個 Google `jobId` 只會有 1 筆紀錄。每筆職缺紀錄包含 `title`、`companyName`、`location`、`description`、`postedAtRaw`、`applyOptions`、來源 URL 及 `observedAt`。這些欄位適合組成供代理篩選的職缺表。文件所列的輸出
Apify Google Search 的文件說明,其一般自然搜尋路徑會提供搜尋結果觀測紀錄與頁面連結。它也提供更豐富的搜尋控制選項,並可選擇蒐集網站內容。因此,它適合用來尋找徵才頁面和其他可能有用的來源。文件所述的搜尋路徑
| 選擇依據 | Chronometrica Google Jobs | Apify Google Search |
|---|---|---|
| 文件所述的起始資料單位 | 1 筆結構化 Google 職缺紀錄 | 1 筆附有頁面連結的搜尋結果觀測紀錄 |
| 本文中最適合的用途 | 依傳回的職缺欄位進行篩選 | 尋找可能有用的來源頁面 |
| 仍需取得的證據 | 來源目前狀態的查核與資格審查 | 擷取頁面、辨識職缺及審查資格 |
本表的產品資訊來自 Chronometrica 文件及 Apify 文件。
提出範圍廣泛的蒐集要求之前,先分清這些差異。「找出 5 筆職缺紀錄供審查」給了代理明確的輸出目標。「找出 5 個徵才頁面供檢查」則要求不同的輸出。「找出 5 個好機會」這類要求,沒有明確說明蒐集單位與通過審核的規則。
切換條件很簡單。需要數量有限的職缺資料列時,先用 Chronometrica。需求超出這批傳回結果時,再改為尋找來源頁面。同一套工作流程可以包含這 2 個階段,但應將各階段的紀錄分開保存。
為什麼更多搜尋連結未必能解決求職任務
一篇關於求職代理的公開親身經驗文章,描述了先嘗試固定公司來源,再改用一般網路搜尋的過程。作者仍遇到無法完成查核的頁面、無法確定資料是否最新,以及職務或地點不符等問題。這篇文章有助於理解工作流程的問題,但不是受控的產品比較。公開經驗文章
實務上的重點是先定義搜尋步驟必須交付什麼。找到頁面,不代表頁面上有合適的職缺。找到職缺紀錄,也不代表雇主仍接受應徵。
例如,代理可能找到某家公司的徵才頁面,頁面列出了數個部門。接著,它必須找出特定職缺。該職缺可能要求在另一個城市工作,或要求不同程度的經驗。即使沒有產生通過審核的候選職缺,這個頁面仍是有效的來源探索結果。
這項區分有助於找出尚未完成的工作。如果代理缺少雇主來源,尋找來源就有用。如果它已有足夠的來源,卻無法評估職缺,更多連結可能只會增加審查工作,無助於做出決定。
這篇經驗文章支持依工作流程階段做出選擇。它沒有證明任一 Actor 在成本、速度、涵蓋範圍或準確度上有優勢。本文沒有將該文所述的支出與蒐集結果用作效能基準。
Chronometrica 適合哪些需求,以及何時必須考慮其限制
如果你眼前需要的是有明確筆數上限的職缺表,就可以放心選擇 Chronometrica。文件所列的職缺欄位,讓代理可以直接開始審查欄位。輸入共有 4 個欄位:`market`、`queries`、所有查詢共用的 `location`,以及 `maxItems`。輸入與輸出規格
當要求是「所有結果」時,這個範圍限制很重要。已查核的結構定義允許 `maxItems` 設為 1 到 1000。如果原始需求是單次執行取得超過 1000 筆資料,這個 Actor 就不符合需求。將要求降為 1000 筆,是更改需求,並沒有滿足原始需求。即使在此上限內,傳回的紀錄也不能證明已完整涵蓋所有結果。已查核的輸入限制
設定較低的筆數上限,仍能滿足實用需求。審查者可能想先檢查 5 筆紀錄,再決定是否蒐集更多。這是一項範圍有限、停止條件明確的審查任務。它不需要宣稱已掌握市場上的所有職缺。
本次比較所審查的證據蒐集於 2026 年 10 月 20 日。Google Jobs 查核包含 3 筆有用的資料列,來自一次設有筆數上限的蒐集。這只能支持對傳回紀錄所做的有限觀察,無法證明已建立完整的跨公司索引、職缺經核實仍在招募,或資料新鮮度有優勢。本文未另外執行資料蒐集。本文也沒有在相同條件下測試競爭產品。
這 2 個 Actor 都無法單獨確認履歷是否適合、雇主的意向,或應徵是否成功。職缺配對與應徵操作應放在各自經查核的工作流程中。蒐集結果應先經過審查,才能支持這些決策。
先用符合要求的小規模輸入
Task 是儲存在 Apify 上的輸入預設設定。公開的 Google Jobs 科技徵才 Task 提供起始預設設定。執行前,請檢查實際儲存的輸入。公開的 Task 頁面不能證明目前儲存了哪些輸入值。
假設有一項虛構要求:取得多倫多最多 5 筆資料分析師職缺紀錄。可使用以下輸入:
{
  "market": "CA-en",
  "queries": [
    "data analyst"
  ],
  "location": "Toronto, Ontario, Canada",
  "maxItems": 5
}這份輸入已通過快取版公開 JSON Schema 的檢查。JSON Schema 定義了允許的欄位與值。本文並未執行這份輸入。檢查只能確認輸入結構,不能證明即時來源會傳回 5 筆紀錄。
已查核的結構定義允許將 `market` 設為 `CA-en`,在 `queries` 中放入 1 到 100 個項目,將 `location` 設為文字值,並將 `maxItems` 設為 1 到 1000 的整數。所有查詢都使用同一個共用地點。目前結構定義的證據
這些設定應視為蒐集指示。`market` 選擇 Google 站點與語言。它不是嚴格的地點、國籍或工作資格篩選條件。地點設定也需要稍後對照職缺本身進行查核。搜尋詞可以引導蒐集,但不能證明每筆傳回的職缺都符合使用者的規則。
蒐集前,先寫下預期單位與上限:「最多 5 筆職缺觀測紀錄,供後續審查。」這樣即使傳回的紀錄少於上限,也能清楚理解結果。同時可避免後續流程將要求的筆數上限,視為必定取得 5 筆符合資格的求職機會。
保留 3 張意義明確的資料表
將來源頁面觀測紀錄、職缺觀測紀錄,以及通過審核的候選職缺分別存入不同的資料表。觀測紀錄記下流程在指定時間找到的內容。是否通過審核,則是之後依使用者規則做出的決定。
來源頁面觀測紀錄應保留搜尋查詢、結果排名與來源 URL。加上審查狀態,讓代理能區分尚未讀取與已檢查的頁面。1 個頁面可能沒有職缺,也可能包含 1 個或數個職缺。擷取紀錄時,應保留這種關係。
職缺觀測紀錄應保留 `jobId`、職缺欄位、來源 URL 與 `applyOptions`。將 `observedAt` 與蒐集紀錄一同保存。這些欄位讓後續查核能指向同一筆觀測紀錄,不必只依賴職稱。文件所述的識別規則適用於同一次執行,不能據此建立不同次執行之間的歷史紀錄。Chronometrica 紀錄規格
對於通過審核的候選職缺,請保存對應的職缺觀測紀錄參照,以及通過審核所依據的證據。記下審查時間與簡短的決定理由。如果缺少必要事實,請保留為未知。不要將缺失值改成 0,也不要將尚未釐清的資格問題視為通過。
未能判定的紀錄應有獨立狀態。例如,除非有其他證據足以支持決定,否則無法讀取的頁面應標為未能判定。這與職缺明確不符合地點規則的情況不同。分清這 2 種情況,有助於下一位審查者決定應重試擷取,還是停止處理該職缺。
這種資料表設計也能讓計數保持準確。10 個來源頁面、10 筆職缺觀測紀錄,以及 10 個通過審核的候選職缺,代表不同的結果。每個數量都應標明單位。
採用簡短的來源查核與資格審查流程
產生所需的觀測紀錄後,蒐集階段就完成了。每筆觀測紀錄都有證據支持的決定,或明確標為未能判定後,審查階段才算完成。
- 說明下一步。決定代理需要篩選職缺欄位,還是尋找更多雇主來源。先選紀錄類型,再選 Actor。
- 明確列出蒐集要求。若需要職缺資料列,請檢查 Task 的查詢、市場、共用地點與筆數上限。若要尋找頁面,請保存完整且精確的一般搜尋查詢。
- 保留來源參照。職缺資料列應一併保存職缺識別資料與應徵選項。頁面觀測紀錄應一併保存查詢、排名與來源 URL。
- 檢查來源目前的證據。開啟評估該職缺所需的雇主頁面或來源頁面。記下支持審查結果的內容。
- 套用使用者的規則。檢查職務、職級、地點與資格。保存通過、未通過及未能判定的決定,並附上觀測時間與審查時間。
審查前先定義規則。「多倫多」可能指在多倫多辦公、明確說明的混合辦公安排,或允許的遠端工作地點。如果這項差異會影響是否通過審核,就應詢問使用者。職級與必要工作資格也應如此處理。明確的規則能減少缺乏依據的決定。
請謹慎解讀時間欄位。`postedAtRaw` 是來源中表示刊登至今多久的原始文字。`observedAt` 是蒐集時間。這 2 個欄位都無法確認確切刊登時間,也不能證明職缺仍在招募。請依來源目前的證據做出這項判斷。欄位文件
頁面擷取部分,請使用現有指南:為網路搜尋代理提供經查核的頁面證據。該指南說明取得證據的步驟。本篇比較則用來決定應將哪種蒐集單位送入該步驟。
職缺配對、歷史紀錄與應徵操作,都應透過各自經查核的工作流程加入。先將這項初步決定的範圍控制在可驗證的程度。
一個核對各項單位的虛構範例
以下範例純屬虛構。它不是 Actor 測試、實際蒐集的資料集、買家引述,也不是實測成本結果。
某個虛構代理需要 5 筆職缺觀測紀錄,供稍後審查。使用者已定義職務與地點規則。Google Jobs 路徑傳回 5 筆結構化觀測紀錄。另行查核來源目前狀態並審查資格後,3 筆通過,2 筆未通過。
結果如下:
5 筆職缺觀測紀錄 − 2 筆未通過的觀測紀錄 = 3 個通過審核的候選職缺。
範例到此為止。它不能證明這個 Actor 的實測通過率。不同的查詢、使用者規則或蒐集時間,都可能產生不同結果。
再看另一條來源探索路徑,它提供了 5 個待查的徵才頁面連結。代理仍須擷取這些頁面並抽取職缺,才能將它們當作職缺資料列來比較。1 個頁面可能有數個相關職缺,另 1 個頁面則可能完全沒有。因此,5 個連結不等於 5 個職缺。
不論哪條路徑,傳回 5 筆紀錄都不代表取得 5 筆符合資格的求職機會。哪些紀錄符合使用者規則,必須由審查決定。因此,應先比較所需的輸出單位,再評估取得的證據。
如果代理已有足夠的職缺觀測紀錄可供下一輪審查,就使用這些紀錄。如果它需要尋找這批結果以外的雇主,就開始探索來源。根據尚未完成的工作做出選擇。
來源與延伸閱讀
作者 Chronometrica · 更新日期
返回頂端 ↑