收集設定
開啟 YouTube Search Scraper 或 YouTube Content Idea Research Task。目前的預設輸入包括 queries(複數形式)、maxResults 150、resultsPerQuery 40、maxPagesPerQuery 2,以及設為 true 的 enableQueryExpansion 和設為 true 的 enrichWithVideoMetrics。
進行先導測試時,將 queries 的內容換成 1 個觀眾問題,將 maxResults 設為 2、resultsPerQuery 設為 2、maxPagesPerQuery 設為 1,並將 enableQueryExpansion 設為 false、enrichWithVideoMetrics 設為 false,以及選填的 enrichMissingChannelFields 設為 false,以停用查詢擴展及指標補充。maxResults 是同一次執行中所有查詢共用的上限,resultsPerQuery 則限制每項搜尋的結果數量。不同執行各有獨立的 maxResults 上限。
保留以下輸出欄位,名稱須完全一致:rootQuery、query、querySource、pageIndex、pageRank、postId、postUrl、postType、isShort、title、description、publishedAt、channelId、status、statusReason 及 observedAt。來源排名表示位置,並不代表需求或內容質素。目前包含 2 個候選結果的對照測試沒有使用查詢擴展或資料補充,發佈日期均為 null。它只核實了限定範圍內的來源資料結構,並未核實構思質素或實際檢視過的影片內容。缺少的日期仍屬未知,不能推定為 0。實際解答須由人手檢視。
收集並整理觀眾問題
- 選定 1 位觀眾,以及 1 個你能回答的真實問題。寫下相關的操作、已有知識及適用範圍。將該問題轉成 2 至 3 個簡單的搜尋詞組。這些只是擬用詞組,並非經驗證的搜尋量數據。
- 為每個詞組收集少量樣本,並明確記錄查詢、數量上限及時間。保留來源影片的識別資料,以及同一影片在不同查詢中重複出現的背景資料。比較 Shorts 與長篇教學影片時,須註明格式差異,不要假設兩者的內容深度相同。
- 在可取得影片的情況下,檢視每段影片的實際解答。標題可能承諾回答某個問題,但影片內容卻遺漏關鍵條件。若你無法檢視影片,就將涵蓋情況保留為未檢視,不要根據標題或描述推斷。
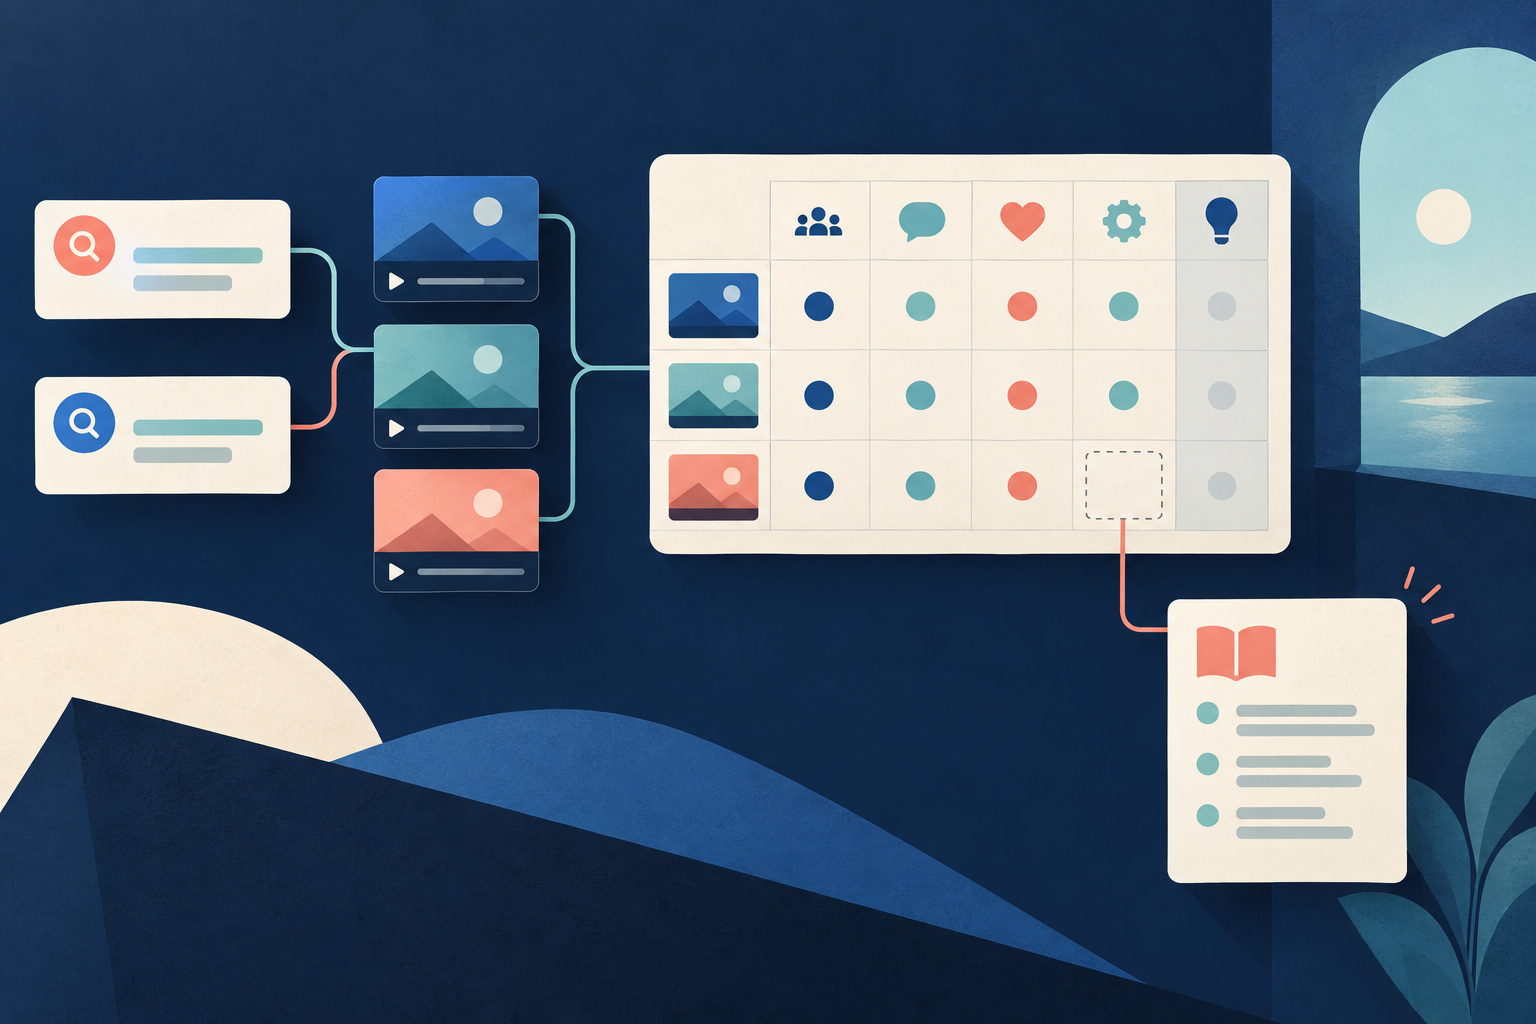
- 建立問題組成部分矩陣。各列代表觀眾的要求,各欄代表已檢視的來源影片。每個儲存格標為已解答、部分解答、未涵蓋或未檢視,並附上來源段落或場景筆記。這些標記由讀者建立,並非 Actor 的輸出。
- 找出已觀察例子沒有解說的具體條件或步驟。要分清楚你樣本中的缺口,與整個 YouTube 都沒有相關內容的情況。較少見的問題,可能在你的樣本以外已有一個出色解答;這並不能證明相關需求未獲充分滿足。
- 用你自己已核查的方法、例子或第一手來源,核實你擬提供的解答。不要只因某個相反主張有別於已收集影片的說法,就將它發佈。目的是提供更清楚、有用的教學,而非抄襲結構或提出沒有根據的新說法。
- 撰寫原創教學大綱:直接解答、必要條件、逐步解題示例、檢查或失敗個案,以及最後行動。自然地使用關鍵字,因為它表達了該問題;不要堆砌字詞或承諾流量。
- 將涵蓋情況矩陣及來源限制與構思一併儲存。你可能需要自己觀眾的回應或搜尋需求數據,才能按商業價值決定優先次序;這個數據集本身無法做到這一點。最終成果是一份有依據、針對特定問題的大綱,而非一個能帶來成功的關鍵字。
問題組成部分矩陣示例
以下用一個虛構測試說明做法。觀眾是試算表新手。問題是如何比較 2 個匯出檔案,而不遺漏已變更的資料列。查詢組 A 使用 compare CSV files。查詢組 B 使用 find changed spreadsheet rows。候選結果共出現 5 次,涉及 4 段不同影片。人手檢視涵蓋影片 1、影片 2 及影片 4。影片 3 仍未檢視。實際觀看須由人手進行。日期或指標若為 null,仍屬未知,並非 0。
要求包括配對穩定的鍵值、比較儲存格的值、處理缺失的鍵值,以及檢查重複記錄。
| 要求 | 影片 1 | 影片 2 | 影片 4 | 影片 3 |
|---|---|---|---|---|
| 配對穩定的鍵值 | 已解答 | 部分解答 | 已解答 | 未檢視 |
| 比較儲存格的值 | 已解答 | 部分解答 | 已解答 | 未檢視 |
| 處理缺失的鍵值 | 未涵蓋 | 未涵蓋 | 未涵蓋 | 未檢視 |
| 檢查重複記錄 | 未涵蓋 | 未涵蓋 | 已解答 | 未檢視 |
影片 1 回答了首 2 項規則,但遺漏了最後 2 項。影片 2 只示範逐列比較,因此對全部 4 項要求的解答,最多只能算部分解答或未涵蓋,因為資料列的次序可能改變。影片 4 解答了穩定鍵值及重複記錄的問題,卻沒有說明如何決定缺失鍵值的處理方式。影片 3 的儲存格屬於未檢視,並非未涵蓋。
觀察到的樣本缺口是:3 段已檢視影片都沒有示範缺失鍵值的覆核記錄表。這並不表示 YouTube 沒有這類影片。
原創教學大綱及簡化示例
原創大綱有 5 個部分。直接解答是配對已知的資料列鍵值,並將缺失鍵值的記錄保留待覆核。必要條件是鍵值必須能識別記錄。逐步解題示例使用 2 個次序不同的虛構匯出檔案。檢查重點是不能按位置為缺失的鍵值賦值。最後行動是建立已變更及未解決記錄表。
假設舊資料列中,鍵值 1 的數值是 10,鍵值 2 的數值是 20。新資料列中,鍵值 2 的數值是 21,鍵值 1 的數值是 10,而一個未知鍵值的數值是 20。
Old: K1=10, K2=20
New: K2=21, K1=10, Unknown=20確認鍵值 1 沒有變更。確認鍵值 2 的數值由 20 變成 21。將新增的未知資料列保留為未解決。不要只因 20 看起來像舊數值,就將未知資料列配對至鍵值 2。最終成果包含 4 個影片涵蓋情況欄,記錄已檢視來源數量為 3,另有 1 個未檢視欄,以及分為 5 部分的原創大綱。這些資料不能推導出實際內容表現、搜尋量或估計觀看次數。
來源與延伸閱讀
作者 Chronometrica · 更新日期
返回頂端 ↑