先人工核查视频、音频和字幕。字幕轨是选定的一套字幕,通常使用一种语言。字幕条目是带有开始时间和结束时间的文字块。现有条目可以作为起点,但不能证明字幕已经传达了所有必要的声音或说话人变化。
这套方法会形成一份保存下来的核查记录,以及一份单独的字幕修订版。它还会指出哪些视觉信息需要通过其他形式提供。这是字幕内容核查,不能证明符合法律要求,也不能证明符合《网页内容无障碍指南》(简称 WCAG)。
核查前先确定范围
有读者抱怨字幕“只是偶尔出现”。这提示了一项有用的检查:核查整个视频,包括字幕条目之间的空白时段。这条投诉只代表观察到的一个读者问题,不能说明该问题出现的频率。公开的读者投诉。
如果没有需要传达的音频内容,字幕条目之间留有空白可能是正确的。但空白时段也可能包含被遗漏的警告声、画外说话声,或能解释某个动作的其他声音。仅阅读字幕文字,无法判断属于哪种情况。
- 选择一个视频和一种字幕语言。
- 记录视频网址、视频标题和所选字幕轨。
- 将核查范围设为当前的完整视频。记录开始时间和结束时间。
- 修改前,先保存带时间信息的原始字幕。
- 记录核查日期和字幕来源。
- 说明要制作哪种成果:字幕修订版、描述性文字稿,或两者都制作。
将范围限定在能够明确描述的程度。如果只核查视频的一部分,应写明该时间范围,并将其余部分标为未核查。不要把抽查称为完整核查。
如果找不到公开字幕,请使用字幕可用性指南检查来源。没有字幕与字幕遗漏声音背景信息是不同的问题。提取失败也需要单独查明原因。
原样保存带时间信息的源文字
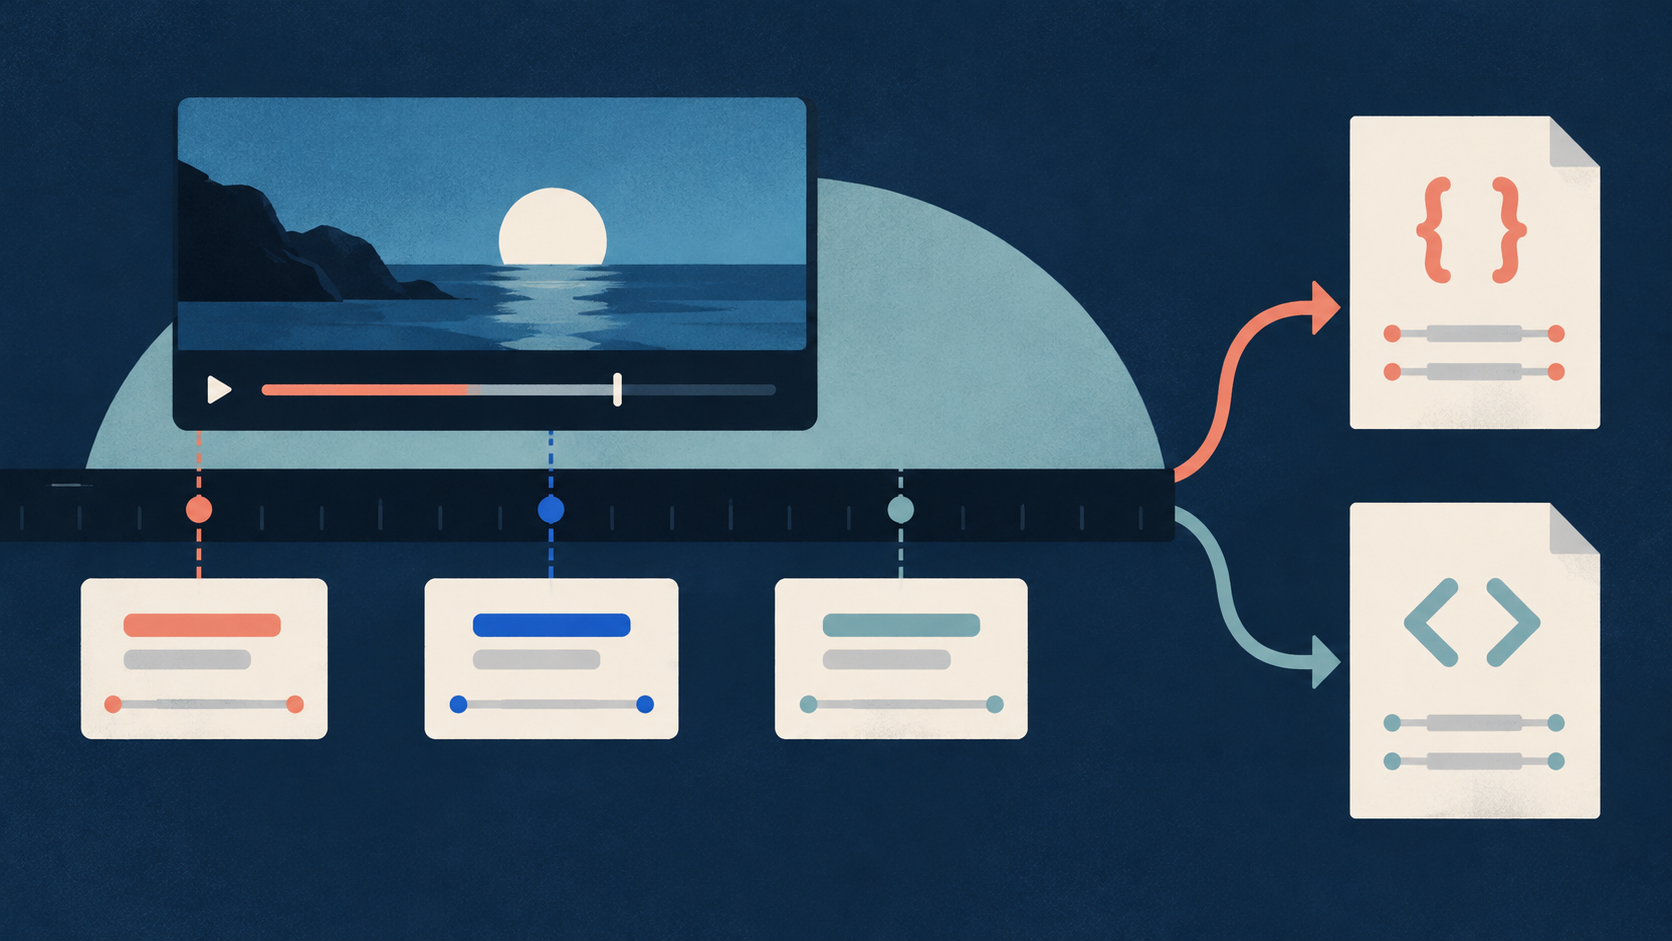
你可以在视频播放器中人工核查字幕。如果还需要保存一份带时间信息的副本,Chronometrica YouTube Transcript Scraper 可以采集现有的公开字幕轨。Actor 是一种托管运行的数据采集程序。它为这项核查提供源文字;你仍然必须观看视频并听取音频。
根据当前文档,该 Actor 读取直接指向 YouTube 视频的网址或视频 ID。它不接受频道、播放列表或搜索输入。它不进行语音转文字,也不下载音频或视频。它不会听辨声音,也不会生成说话人标签。文档表明,它在此适合用于保存现有字幕的文字和时间信息。
下面这个简短的输入示例选择了 JSON 格式。JSON 是一种结构化文本格式,可以保留字幕分段。这是建议的输入,不是运行结果。
{
  "startUrls": [
    "https://www.youtube.com/watch?v=dQw4w9WgXcQ"
  ],
  "preferredLanguages": [],
  "outputFormats": ["json"],
  "includeFailedInputDetails": true
}使用前,请将示例网址替换为目标视频的网址。这个示例不能证明该核查方法曾在这个视频上得到有用的结果。
将 `preferredLanguages` 列表留空,可让 Actor 选择可用字幕轨中的最佳选项。如果核查要求特定语言,请设置对应的语言代码,并核对返回的语言。程序会按顺序尝试各项偏好。如果均不匹配,Actor 会报告带有明确类型的语言不可用错误,而不会选择另一种语言。
保持 `includeFailedInputDetails` 启用,让运行的 `OUTPUT` 记录可以包含失败输入的详细信息。成功采集的每个不重复视频会生成数据集行,失败的输入则不会。因此,仅凭数据集为空,不能认定没有字幕。
如有返回,请保存以下字段:`videoUrl`、`videoId`、`transcriptLanguageCode`、`transcriptLanguageName`、`isAutoGenerated`、`scrapedAt` 和 `segments`。每个分段包含 `startSeconds`、`endSeconds`、`durationSeconds` 和 `text`。保留原始值。时长缺失不等于时长为零秒。
带时间戳的 JSON 预设是文档提供的一个起点。固定来源证据仅确认了其公开页面和预设 ID,未证实其已保存的输入、付费运行或当前执行成功情况。
观看完整视频并记录候选项
候选项是可能需要声音提示、说话人提示或单独视觉说明的片段。先记录候选项,再决定保留哪些修改。
- 从核查范围的起点到终点,观看视频并听取音频。
- 在整个播放过程中,将音频与所选字幕进行比较。
- 记录每一处影响理解的说话人变化。
- 如果说话人可能不明确,记录画外话语。
- 记录可能解释动作或语气的非言语声音。
- 将所需的视觉信息单独分类记录。
- 作决定前,重播每个有疑问的片段。
检查开头、停顿、场景切换和结尾。核查字幕间的空白时段时,要与核查有字幕的话语同样仔细。警告声可能出现在停顿期间。下一个说话人尚未出现在画面中时,声音就可能已经响起。
为每个候选项保存开始时间、结束时间,以及对所听或所见内容的简明描述。将观察与解释分开。例如,先记录讲解者改变方向前出现了一声短促的蜂鸣,再判断来源是否支持将它称为警告声。
自动字幕需要核查。YouTube 列出的准确性影响因素包括发音、口音、方言和背景噪声。成功提取字幕并不代表已核查文字或声音背景信息。YouTube 自动字幕指南。
标出听不确定的词语,留待单独核对。本次核查应聚焦于说话人背景信息和所需声音。不要将它扩展为另一套完整的技术术语纠正或引文核查方法。
确定字幕需要传达哪些信息
对每个声音都问同一个问题:它是否有助于读者理解发生了什么、某个人表达了什么意思,或接下来为什么会发生某个动作?
警报声可能解释突然停止的原因。敲门声可能解释某人为什么转过身。笑声可能改变一句回应的含义。音乐若传达了理解场景所需的信息,也可能很重要。这些都是需要核查的候选项,并不是要求对每一处警报声、笑声或音乐都采用相同的标注方式。
偶然出现的咔嗒声可能不增加任何含义。如果核查时考虑过它,应记录排除原因。这样,下一位核查者就能检查这个决定。
使用简短且有来源支持的描述。无法确认声音来源时,不要指明来源。如果听到蜂鸣声却无法确定其用途,应在核查记录中保留这项不确定性。含义不清的提示应暂缓采用,留待再次核查,不要把猜测写成事实。
说话人标签也需要同样谨慎。只有来源确认身份时,才能使用姓名。不要仅凭声音识别人。如果姓名未知,请使用明确的临时标签,例如“画外说话人 1”。临时表示该标签可能在进一步核查后更改。
只要证据仍支持该标签,就应保持一致。如果无法确认两个片段是否由同一个人说话,应记录这项不确定性。不要将标签数量当作已确认的人数。
W3C 说明,字幕包括对话、说话人信息和有意义的非言语声音。这项指南支持核查这些要素,但不能证明任何特定字幕轨已经包含它们。W3C 预录字幕指南。
保留核查表和单独的修订版
每个候选项保存一行。核查表是你创建的编辑记录,不是 Actor 输出表。
| 保存字段 | 记录内容 |
|---|---|
| 核查编号 | 用于持续引用该候选项的固定编号 |
| 来源和字幕轨 | 视频网址、字幕语言和源副本引用信息 |
| 时间范围 | 开始时间和结束时间,并注明单位 |
| 候选项类型 | 说话人、非言语声音或视觉信息 |
| 原始字幕文字 | 未经修改的源文字,或明确注明没有字幕 |
| 来源观察 | 该时段听到或看到的内容 |
| 拟议修改 | 字幕条目草稿,或单独的描述性文字稿备注 |
| 决定 | 采用、排除或未解决 |
| 原因 | 该信息为何重要,或为何将其排除 |
| 核查状态 | 核查者、日期和播放检查结果 |
区分字幕空白时段与源数据不可用。“已保存的这个时段没有字幕条目”表示你检查了可用的源副本,确认其中没有条目。“字幕源不可用”表示你无法进行这项检查。这两种状态都不表示音频中没有有意义的声音。
将拟议的字幕条目文字放在单独的修订版中。保留原始字幕,让另一位核查者能够对照来源比较修改。替换临时说话人标签或修改声音描述时,应保存原因。
不要用字幕条目数、词数或 `videoCoverageRatio` 证明内容完整。覆盖率数值可以描述字幕跨越的时间范围,但其中仍可能缺少重要信息。缺失值也应保持缺失,不要用零替代。
检查字幕条目时间和所需视觉信息
声音描述即使正确,若出现时间不对,仍可能误导读者。显示修订后的字幕,重播每个修改过的片段。
- 检查声音提示是否在相关声音发生时出现。
- 检查说话人提示是否对应正确的话语片段。
- 将提示与同时显示的话语文字一起阅读。
- 检查新增文字是否遮挡所需文字,或与其发生冲突。
- 重播修改位置前后的衔接片段。
- 记录仍然存在的时间或阅读问题。
不要假定一种字幕样式适合所有读者。通过预览评估实际的修订字幕轨。在交接记录中明确列出尚未解决的样式问题。
如果需要用于播放的字幕文件,请参照 SRT 和 VTT 转换指南。SRT 和 VTT 是带时间信息的字幕文件格式。该指南另行介绍文件处理;本次核查则决定字幕条目需要传达哪些声音和说话人信息。
单独核查无声的视觉信息。例如,图示可能显示一条无人读出的指示。添加声音提示并不能提供这条指示。必要时,在单独标明的描述性文字稿中记录视觉信息的时间范围和所需说明。
基本文字稿包含话语和所需的非言语音频信息。描述性文字稿还会补充所需的视觉信息。因此,导出的字幕可能需要补充内容,才能成为完整的阅读文档。W3C 文字稿指南。
操作示例:一节虚构的安全课
原创虚构示例:本例中的所有时间、观察、字幕和决定均为教学而编造。未测试任何源视频或 Actor 运行。本例涵盖一节完整的 60 秒安全课和一条字幕轨。
讲解者在一声蜂鸣后改变方向。随后,一名画外人物给出一条简短指示。一句回应中出现了笑声。接近结尾时出现一声轻微的咔嗒声。一张无声图示还包含一条必要指示。
| 编号 | 时间范围(秒) | 虚构观察 | 拟议处理 | 决定 |
|---|---|---|---|---|
| A1 | 12 至 13 | 警告蜂鸣声解释了改变方向的原因 | 在声音响起时添加“[警告蜂鸣声]” | 采用 |
| A2 | 20 至 22 | 一名姓名不明的画外说话人说:“在这里等。” | 在话语字幕条目中添加“画外说话人 1:” | 采用 |
| A3 | 42 至 44 | 笑声可能改变回应的语气,但仍不确定 | 暂缓采用声音描述,留待再次核查 | 未解决 |
| A4 | 50 至 50.5 | 一声轻微的咔嗒声没有增加必要含义 | 不添加声音提示 | 排除 |
| V1 | 30 至 34 | 一张无声图示给出了一条必要指示 | 在单独的描述性文字稿中说明这条指示 | 单独采用 |
这个虚构来源明确说明蜂鸣声是警告声。如果没有这项证据,核查者就需要使用更笼统的描述,或将决定标为未解决。由于人物姓名尚未确认,画外说话人标签仍是临时标签。
蜂鸣声持续时间为 13 秒减去 12 秒,等于 1 秒。画外话语片段持续时间为 22 秒减去 20 秒,等于 2 秒。这些时间范围用于定位证据,不能证明拟议的字幕条目便于阅读。
音频候选项共有 4 项:2 项采用 + 1 项未解决 + 1 项排除 = 4 项候选项。单独的视觉项目不计入音频数量。这些数字统计的是核查项目,不是人数、字幕准确率或无障碍使用效果。
在这个虚构示例中,核查者检查了全部 60 秒。未核查时长为 60 秒减去 60 秒,等于 0 秒。这个零来自示例明确设定的完整核查,不能用来替代真实记录中未知的核查时长。
下一步是解决 A3,并再次检查完整的修订字幕轨。本例不能支持在必要的声音决定仍未解决时,将该版本称为完整版本。
解决失败问题并检查完整修订版
使用能准确描述已知情况的失败状态。将来源访问问题与编辑判断中的不确定性分开。
| 状态 | 含义 | 下一步操作 |
|---|---|---|
| 字幕不可用 | 没有可用的公开字幕源 | 判断字幕内容前,先检查字幕是否可用 |
| 提取失败 | 采集未生成所需记录 | 检查 `OUTPUT`;不要据此推断没有字幕 |
| 所需语言不可用 | 没有匹配任何请求的语言 | 保留语言要求,或记录已获接受的范围变更 |
| 声音未确定 | 没有足够证据支持声音描述 | 重播并请求再次核查 |
| 说话人未确定 | 身份不明,或无法确定是否为同一说话人 | 保留临时标签,并记录不确定性 |
| 需要视觉信息 | 声音字幕未提供所需的视觉含义 | 单独编写描述性说明 |
| 核查未完成 | 核查范围内仍有视频片段未经检查 | 完成该范围的检查后,才能声称已完整核查 |
完成所有编辑后,对照音频和画面,从头到尾观看完整的修订字幕轨。只检查改过的条目,可能遗漏衔接处的冲突。记录已核查的范围、未解决项目和最终决定。
视频所有者可以按文档所述,通过 YouTube Studio 的字幕功能处理自己的字幕。其他研究者应保留单独的衍生副本,即根据来源修订的副本。公开字幕数据并不提供对其他所有者的编辑控件或私人账户记录的访问权限。这里描述的是建议读者执行的操作,不是本指南已经完成的操作。
来源和延伸阅读
- W3C WAI:理解预录字幕——2026 年 10 月 25 日核查;针对一项无障碍准则的指导,不是法律合规证明
- W3C WAI:文字稿——2026 年 10 月 25 日核查;区分基本文字稿与描述性文字稿
- YouTube 帮助:使用自动字幕——2026 年 10 月 25 日核查;提供一般核查指导,未测试此视频的字幕
- Chronometrica YouTube Transcript Scraper——2026 年 10 月 25 日核查公开构建版本 0.1.43;仅有数据结构和文档证据,未进行付费运行或运行健康测试
- YouTube 带时间戳的文字稿 JSON 预设——2026 年 10 月 25 日核查;已确认公开页面和预设 ID,未检查已保存的输入或执行情况
- 关于字幕时有时无的公开读者投诉——2026 年 10 月 25 日观察到;发布日期未知,仅为一条投诉,不构成需求证据
作者 Chronometrica · 更新日期
返回顶部 ↑