快照是在某个采集时间保存的读数。观测记录是该读数的存储记录。本指南为已经采集 Instagram 公开指标的开发者提出一种导入方法。此方法保留历史记录,防止重复导入被误算为一次额外检查。
采集程序提供源数据行。导入流程必须实现下文所述的稳定键、存储规则和重启检查。本文未执行采集运行,也未进行导入测试。
明确每条已保存数据行的含义
一位读者在公开提问中表示,希望“每24小时分析一次帖子表现,生成类似 Instagram 新版关键绩效指标的曲线”。这段话说明了重复测量的需求,但没有说明重试方案。本文的安全导入方法是在此基础上提出的设计扩展。读者提问,观察于2026年8月12日;发布日期不可得,未核实是否使用过产品。
仅靠每日定时执行,无法形成可靠的历史记录。你还需要区分两种事件:
- 新采集:程序再次检查帖子。保存一条新的观测记录。
- 重复导入:应用读取已经保存过的数据行。保留现有观测记录。
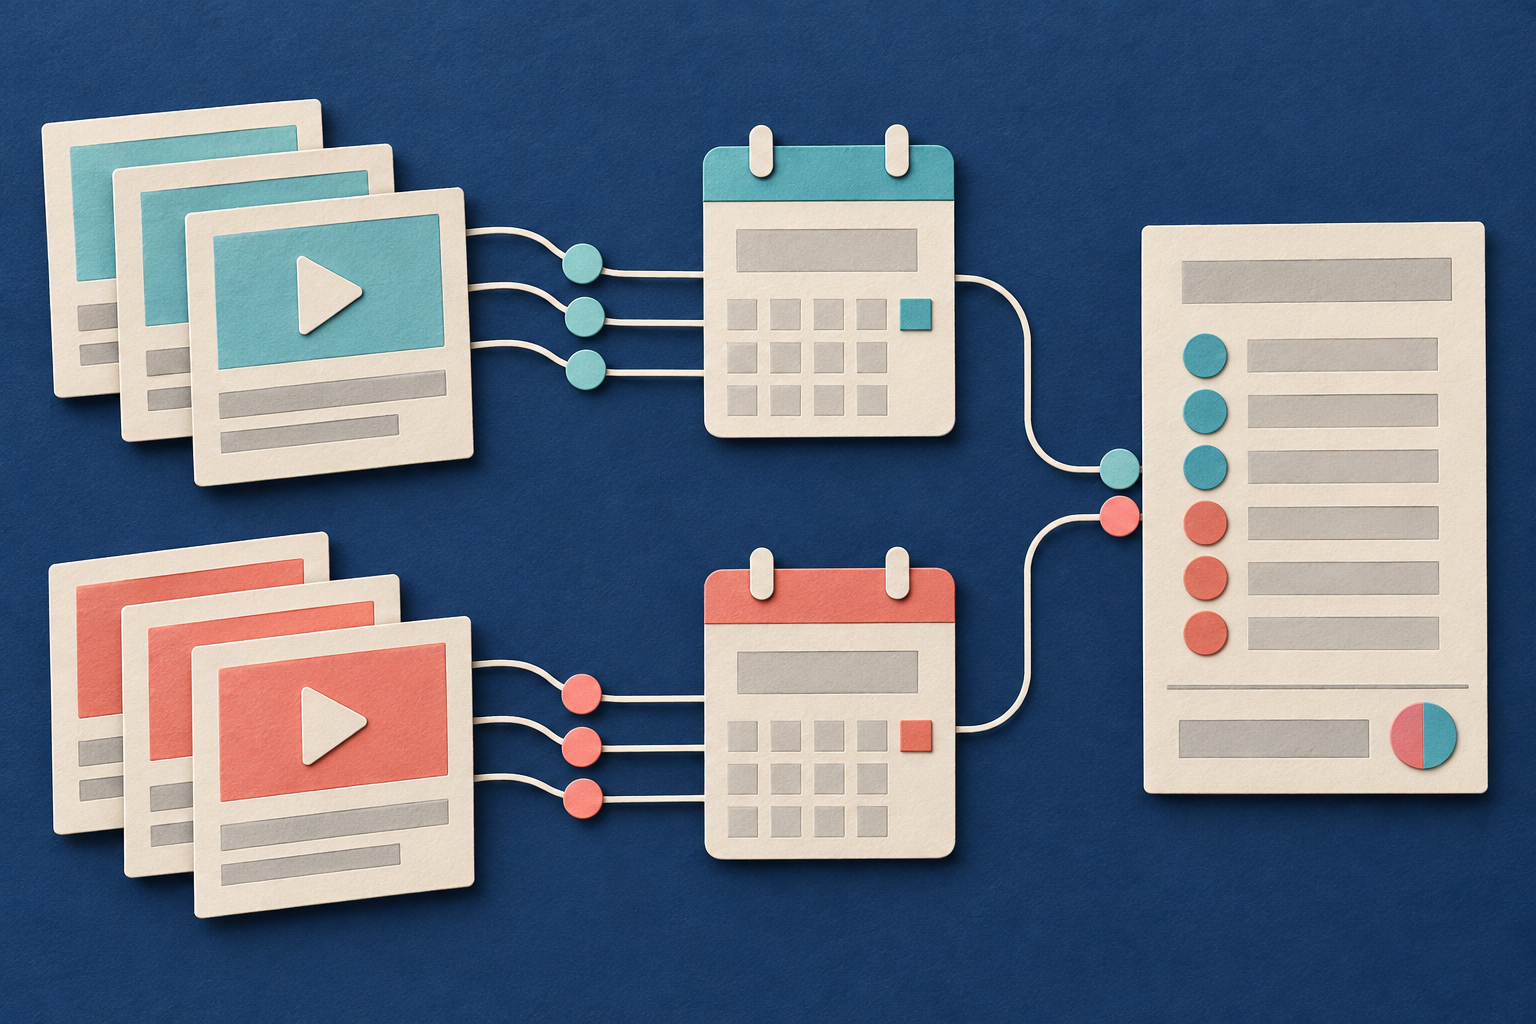
这两种事件中的计数可能完全相同。两次检查都返回100次浏览,仍然是两条观测记录。将同一条采集结果读取两次,仍然只有一条观测记录。
区分次数和人数。公开浏览次数不等于去重后的人数。将 `views`、`plays` 和 `playsInstagram` 保留为独立字段。没有明确的报表规则时,不要将它们相加,也不要用一个字段替代另一个。
此方法针对公开计数。它无法获取账户的非公开 Insights 数据,也无法恢复你未保存的过去计数。仅账户所有者可见的记录需要另行使用已获授权的数据源。已核查的公开接口约定支持采集当前公开指标,不支持恢复历史计数。Instagram Metrics Scraper 接口约定,核查于2026年10月25日;仅检查公开构建版本,未付费运行。
如果你还需要在查找近期帖子和检查已保存的 URL 之间作出选择,请参阅 Instagram 重复采集指南。先作出选择,再设计导入流程。
保留观测表和导入回执
使用两种用途不同的记录。观测表保存采集到的读数。导入回执记录应用如何处理一次源运行。
一次运行是指采集程序执行一次。数据集是该程序返回并存储的数据行列表。保留运行和数据集的标识符,以便追溯已保存观测记录的来源。
以下名称是建议使用的存储字段。`run_id` 和 `item_position` 等字段属于工作流程元数据,即有关采集和导入的信息。它们不是新增的 Actor 输出字段。Actor 是托管运行的采集程序。
| 存储字段 | 保留内容 | 用途 |
|---|---|---|
| `observation_key` | 源数据行的唯一键 | 防止重复插入 |
| `run_id` | 已完成的源运行 ID,以文本存储 | 标识采集运行 |
| `dataset_id` | 源数据集 ID,以文本存储 | 标识源列表 |
| `item_position` | 原始绝对行位置 | 标识更改前的数据行 |
| `postId` | 原始帖子 ID,以文本存储 | 匹配不同运行中的相同内容 |
| `postUrl` | 原始内容 URL | 保留内容引用 |
| `scrapedAt` | 原始采集时间 | 确定读数在历史记录中的时间位置 |
| 计数字段 | 分别保留每个返回的计数字段 | 保留指标含义 |
| 状态字段 | 原始指标状态和数据行状态 | 说明数值缺失或不可用的原因 |
| `original_json` | 完整的原始数据行 | 保留来源证据 |
| `imported_at` | 应用保存数据行的时间 | 单独跟踪导入工作 |
JSON 是一种用于结构化数据的文本格式。在重命名字段、删除字段或将一条源数据行展开为多条记录之前,先保存原始 JSON。
如果返回了 `postMetricStatus`、`status` 和 `statusReason`,请保留这些字段。在原始 JSON 中保留其他返回的状态字段。不要编造状态值,也不要假设存在文档未说明的状态结构。已核查的输出约定包含内容标识、计数、采集时间和状态字段。公开默认构建版本,核查于2026年10月25日;仅依据文档所列字段,未进行运行测试。
每次尝试导入时,都应保存一份回执,记录以下信息:
- 运行 ID、数据集 ID 和源运行的完成状态。
- 固定的导出设置和本次导入的源数据行范围。
- 已接受、重复和已拒绝的数据行。
- 最后一个已完成持久化处理的源位置。
- 导入开始时间、结束时间和完成状态。
- 拒绝数据行的原因。
“已接受”表示已保存一条新的观测记录。“重复”表示同一条源观测记录已经保存。“已拒绝”表示根据你制定的规则,该数据行需要修正或复核。
分别保留每次导入尝试的计数。将多次重试的回执计数相加,得不到去重后的观测记录数。
加载数据行前,先选择观测键
键是用于标识一条记录的值。观测键必须标识源数据行,而不只是 Instagram 帖子。
仅使用 `postId` 会将该帖子的所有后续检查合并。使用导入时间,则会在每次重试时创建一条新的观测记录。帖子说明文字或帖子在创作者主页列表中的位置,也无法标识一条采集到的观测记录。
对于稳定且已完成的数据集,使用运行 ID 和数据项在原始数据集中的位置。将数据集 ID 与该键一并保留。一项实用的存储规则是:让运行 ID、数据集 ID 和数据项位置的组合保持唯一。
唯一性规则可以防止表接受两条具有相同组合的记录。在存储层实施此规则,不要只依赖应用代码在插入前进行检查。
请按以下步骤操作:
- 如果报表规则要求使用稳定且已完成的数据,选择一次已完成的源运行。
- 保存其运行 ID 和数据集 ID。
- 固定原始数据的导出设置,并按源位置升序排列。
- 记录计划导入的源数据范围。
- 在排序、筛选或展开数据行之前,为其分配原始绝对位置。
- 每次重试时,都保持这些位置不变。
绝对位置是指数据行在完整源列表中的位置。如果一页包含位置0至99,下一页就从100开始,不能重新从0开始。请说明位置编号从0还是1开始。
Apify 文档说明,数据集存储采用仅追加方式:可以添加数据项,但不能修改或删除现有数据项。这有助于保留源数据行。但仅凭这一点,不能保证经筛选或重新排序的导出结果能提供可靠的导入标识。Apify 数据集文档,核查于2026年10月25日;说明仅追加存储和数据读取方式,不构成导入保证。
如果无法保留稳定的源位置,可以对原始数据行的一种固定表示形式计算哈希值,并记录所用方法。哈希值是根据内容计算出的标识符。每次重试时,都使用相同的字段、文本表示形式和计算方法。同时保留运行和数据集的引用信息。
使用这种替代方法时需要谨慎。相同的数据行即使位于不同的源位置,也可能产生相同的哈希值。采用此方法前,先明确这些行代表一条还是两条观测记录。如果必须保留每一条返回的数据行,应优先使用稳定的源位置。
如果现有键对应的原始内容与本次不同,请停止并复核冲突。不要在不作提示的情况下覆盖已保存的观测记录,也不要将其视为正常重复。
将数据行和进度作为一个操作保存
重启的主要风险发生在保存数据行和保存进度之间。应用可能在其中一项成功后、另一项完成前停止。
事务将相关更改作为一个操作保存。如果存储工具支持事务,请将已接受的观测记录及对应的进度位置一并提交。相关回执的更改也应与该次提交保持一致。
请按以下顺序导入:
- 读取下一批源数据行及其原始位置。
- 根据接受规则检查每一行。
- 为每行构建观测键。
- 如果键不存在,插入一条新的观测记录。
- 如果已有匹配的观测记录,将其计为重复。
- 记录已拒绝的数据行及原因。
- 只有在数据行和拒绝记录都已持久化后,才保存进度。
持久化是指存储系统已保存更改,导入进程停止后,这些更改仍然保留。
对于其他方面均有效的源数据行,不应仅因某个计数缺失就将其拒绝。该行仍可记录一次采集尝试和其他可用计数。请保留缺失值及其状态。
保留足够的来源信息,以便复核已拒绝的数据行。进度位置越过某条已拒绝的数据行后,不能让该行被遗漏。推进进度前,先保存其拒绝记录,或停在该位置,直到问题解决。
如果存储工具无法将数据行和进度一并提交,请先保存数据行,再推进进度。停止后,使用相同的唯一键重新处理进度不确定的范围。这可能产生重复行,但不得新增多余的观测记录。
重新处理时,不要创建新的 `scrapedAt`。不同尝试之间,`imported_at` 可以变化,采集时间不能变化。
逐步演示一次导入和重启
以下示例为原创虚构示例。它不是 Actor 输出、客户结果或测试结果。所有时间均指同一个虚构日期,采用 UTC,即协调世界时,这是一种通用时间标准。
运行 A 包含两行数据。本例中的源位置从0开始。
| 运行 | 原始位置 | 帖子 | 采集时间 | 浏览次数 |
|---|---|---|---|---|
| A | 0 | P1 | 10:00 UTC | 100 |
| A | 1 | P2 | 10:01 UTC | 缺失 |
| B | 0 | P1 | 11:00 UTC | 120 |
首先,导入运行 A。表中将 P1 和 P2 保存为两条观测记录。P2 没有可用的浏览次数。它仍是一条已保存的观测记录,只是浏览次数缺失。
现在,重新导入运行 A。两个源数据行的键都已存在。此次导入不新增观测记录,并报告两行重复。
接着,导入运行 B。其中 P1 所在行的运行标识不同。即使表中已有 P1,也应将其保存为一条新的观测记录。
| 导入尝试 | 新增观测记录数 | 重复行数 | 已保存观测记录总数 |
|---|---|---|---|
| 首次导入 A | 2 | 0 | 2 |
| 重新导入 A | 0 | 2 | 2 |
| 首次导入 B | 1 | 0 | 3 |
计算如下:
- 首次导入:0条观测记录 + 2条新增观测记录 = 2条观测记录。
- 重新导入:2条观测记录 + 0条新增观测记录 = 2条观测记录。
- 新运行:2条观测记录 + 1条新增观测记录 = 3条观测记录。
两次运行共产生三条观测记录。三次导入尝试共处理数据行五次,但这不代表有五条观测记录。P2 的浏览次数仍然缺失,不会变为零。
现在,考虑同一原创虚构示例中的另一种重启情形。首次导入 A 时,程序在保存 P1 后停止,尚未保存 P2。
如果已保存的进度可靠,从 P2 重新开始。这次重启新增一条观测记录。最终,表中有两条来自 A 的观测记录。
如果进度不确定,从头重新导入 A。P1 计为一行重复,P2 则新增一条观测记录。最终,表中仍有两条来自 A 的观测记录。
导入 B 后,两种重启方式都会得到相同的三条已保存观测记录。重试检查应验证这一结果。
保留历史记录,单独显示最新读数
视图是根据已保存记录组合而成的结果。请建立最新读数视图,不要替换旧的观测记录。
根据 `scrapedAt` 对有效的观测时间排序,不要根据导入时间排序。今天导入昨天已完成的运行,不能让昨天的计数看起来比今天采集的读数更新。
为每个帖子分别显示以下两项信息:
- 最新保存的采集尝试。
- 每个所需计数字段的最新可用读数,以及该读数的原始时间。
较新的数据行可能缺少浏览次数,而较旧的数据行有可用的浏览次数。可以保留旧值供参考,但必须显示其较早的时间,同时显示较新记录中的缺失结果。不要将旧值显示为新的测量结果。
不同计数字段的“最新可用”记录可能不同。具有可用点赞次数的最新行,可能不是具有可用浏览次数的最新行。请分别保留它们的时间。
发布前,请记录以下排序情况的处理规则:
- 采集时间相同:保留两条源观测记录。显示时间相同的情况,或采用已说明的显示规则。显示规则不能证明哪一个读数产生得更晚。
- 采集时间缺失:保留源数据行,但在复核前,不将其纳入按时间排序的结果。
- 采集时间无效:记录问题。没有明确标注时,不要用导入时间替代。
- 没有返回数据行:单独记录采集缺口。不要编造观测记录,也不要填入零计数。
后续计算请参阅 Instagram 月度报表指南。此导入方法能保留观测记录,但不能补出缺失的月度边界读数。指标历史记录指南也解释了检查存在间隔缺口时,实际观测时间为何重要。
先使用小规模采集输入,再检查导入
Chronometrica 的 Instagram Metrics Scraper 文档说明了直接内容输入方式,以及本存储方案所需的字段。文档表明适用,并不意味着该工具会为你建立历史记录表,或强制执行导入键规则。
Task 是为 Actor 保存的输入预设。公开的 Instagram Post Metrics Tracker Task 可作为起点。所提供的页面检查仅确认该预设公开存在,未在登录认证后核实已保存的设置,也未运行该预设。Instagram Post Metrics Tracker,核查于2026年10月25日;仅确认公开页面存在,未在登录认证后检查输入,也未付费运行。
使用以下提供的小规模输入:
{"maxItems":1,"mode":"contentUrls","startUrls":["https://www.instagram.com/reel/DIwcCZgxVZP/"]}`mode` 用于选择 Actor 处理输入的方式。`contentUrls` 用于选择直接检查内容。`startUrls` 包含目标内容的 URL。`maxItems` 限制返回的指标数据行数。
将示例 URL 替换为一个已知的公开帖子或 Reel 的 URL。Reel 是 Instagram 的一种视频格式。请替换示例列表,不要将自己的 URL 添加到示例 URL 旁边。使用前,检查已保存的设置。
此输入已通过静态结构校验。该校验依据所提供的公开结构定义,确认输入格式是否符合要求。它不确认当前内容是否可用,也不确认采集能否成功。公开输入结构定义,核查于2026年10月25日;仅进行静态校验,未付费运行。
以下是建议读者执行的检查:
- 采集一个目标公开内容项,并保留已完成运行及其数据集的引用信息。
- 导入其数据行,记录已接受、重复和已拒绝的数量。
- 再次导入同一来源。确认新增观测记录为零。
- 中途停止一次导入,然后重新开始。确认最终的源数据行键与完整导入的结果一致。
- 为同一内容项执行一次新的采集运行。确认它会创建一条新的观测记录。
- 确认所有已保存的 `scrapedAt` 值均与源数据行一致。
- 确认缺失的计数仍然缺失,且较早的可用计数仍保留其原始时间。
运行完成,不代表每个请求的内容项都有可用计数。请对照目标内容列表与返回的数据行,单独记录缺口。
来源和延伸阅读
- Instagram Metrics Scraper 公开接口约定,核查于2026年10月25日;依据文档所列的公开输入和输出,未付费运行,也未测试当前运行健康状态
- 公开默认构建版本1.0.35,核查于2026年10月25日;提供结构定义及文档所列字段的证据,不是运行行为的实测结果
- Apify 数据集文档,核查于2026年10月25日;提供仅追加存储和数据读取的证据,稳定的导入标识仍需固定源顺序
- Instagram Post Metrics Tracker Task,核查于2026年10月25日;仅确认公开预设存在,未在登录认证后核实已保存的设置,也未付费运行
- 关于重复测量的提问,观察于2026年8月12日;发布日期不可得,仅为一条公开提问,不构成市场需求或产品使用的证据
作者 Chronometrica · 更新日期
返回顶部 ↑