如果反复扫描个人主页就能满足需求,可以选择 WebDataLabs Instagram Posts and Reels Scraper。其文档说明,通过个人主页发现内容时,可以获取 Reel 观看次数和媒体链接。文档也指出,直接提供帖子或 Reel 链接无法获取 Reel 观看次数。WebDataLabs Actor
有一项主要限制会影响选择:Chronometrica 也不保证能通过已保存的内容 URL 获取观看次数。如果观看次数是必需项,而直接链接方式未能返回该值,就应先测试从个人主页发现内容的方式或其他来源,再决定是否采用这套流程。Chronometrica Actor
对于 Replit 应用,一个实用的初始方案是定时采集,再通过 API 更新应用。API 让一个程序能够向另一个程序请求执行工作或获取数据。关键在于确定每次采集要检查什么:创作者的近期内容,还是已保存的帖子列表。
先明确应用的定期更新需求
一则关于网红追踪应用的公开讨论提出了这样的问题:如何将定期采集接入 Replit,包括应该使用 webhook,还是定时 API 轮询。相关需求是更新其他网红所发布帖子的公开指标。这是一个有用的集成问题。但它不是对供应商的推荐,也不是经过验证的产品测试。读者讨论
本次对比涵盖的指标是公开点赞数、评论数,以及可获取的观看次数或播放次数。所提方案不涵盖非公开的投资回报数据、转化数据、触达人数、收藏数、分享数或创作者的完整历史内容。
该读者没有明确要求使用固定的内容 URL 列表。保存这些 URL 是本文为定期更新提出的一种方案。如果创作者发布新帖子后,应用仍需持续检查原有帖子,这种方案就适用。
选择 Actor 前,先用一句话定义应用要做的工作。例如:“每次计划检查都必须更新营销活动中已保存帖子的公开计数。”这一要求适合使用直接内容输入。如果要求是查找创作者最新发布的帖子,就适合从个人主页发现内容。
这种区别比产品是否接受 Instagram URL 更重要。个人主页 URL 和内容 URL 要求采集程序完成的工作不同。
选择发现新内容,还是检查已保存的内容列表
从个人主页发现内容,是指从创作者的个人主页出发查找内容。这种方式适合需要展示新发布帖子的动态信息流。每次发现任务回答的问题类似于:“现在能找到这位创作者的哪些近期帖子?”
直接内容检查从已有的帖子或 Reel URL 开始。这种方式适合需要在多次检查之间保持条目不变的营销活动列表。每次运行回答的问题是:“现在能获取这些已保存帖子的哪些公开计数?”
随着创作者发布更多内容,某个帖子可能不再出现在最新帖子范围内。如果应用必须保留这个帖子,保存其 URL 就能为下次检查提供明确目标。已保存的 URL 用于识别内容,但不保证每项指标都可获取。
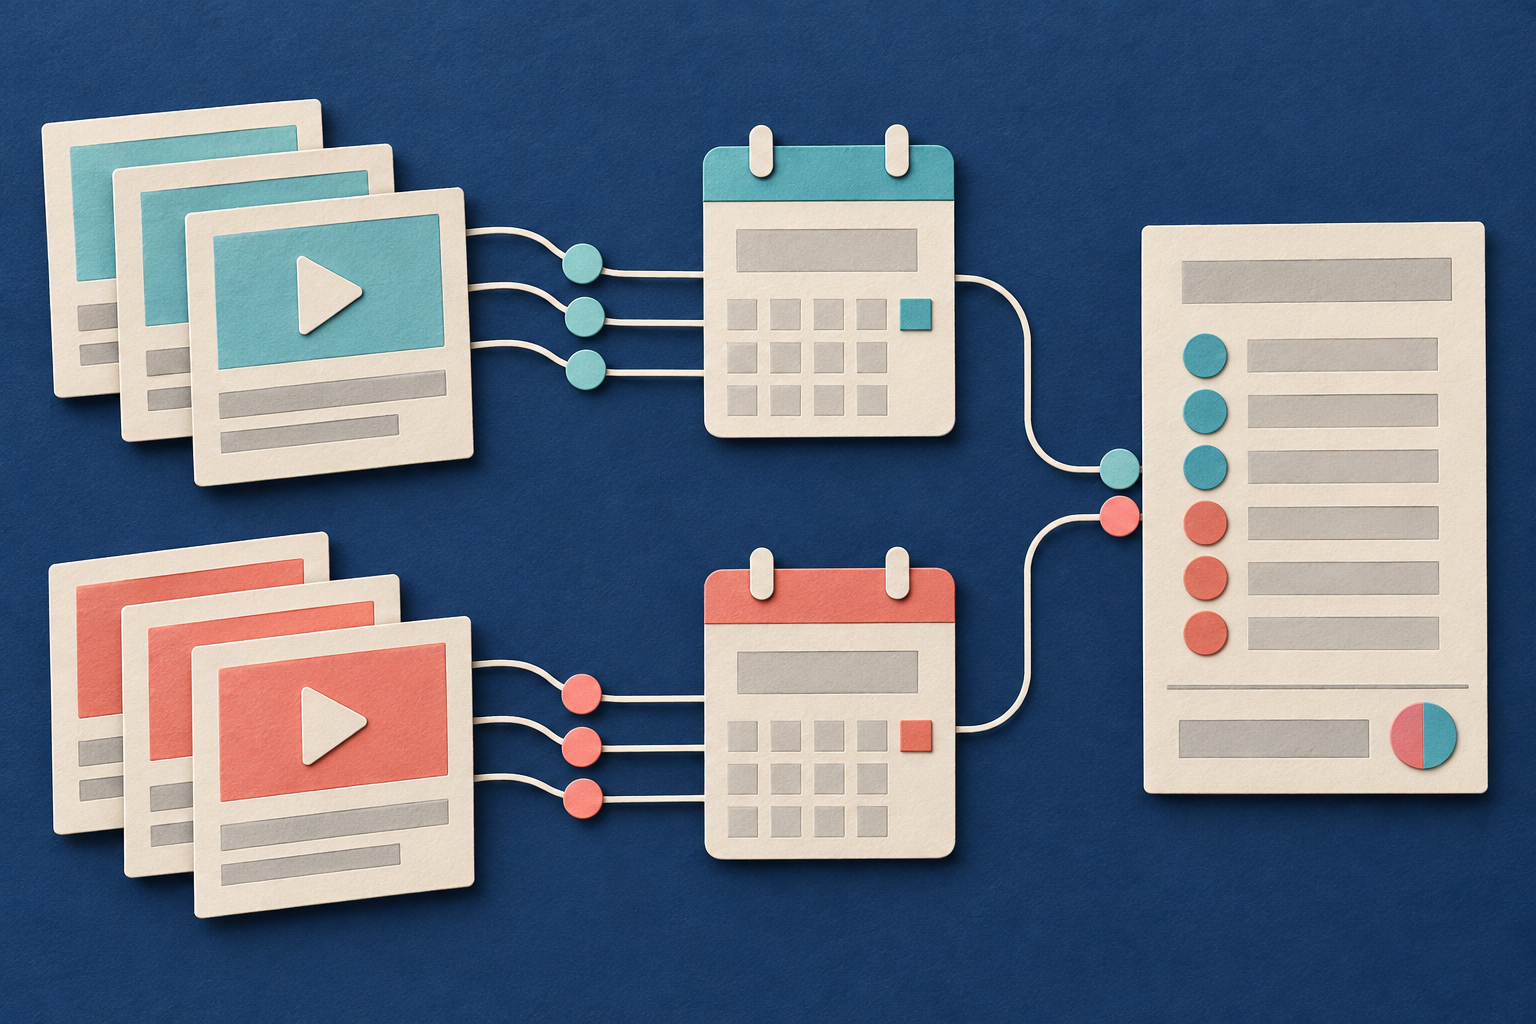
你可以在一套拟议流程中同时使用这 2 种方式。先运行发现任务来查找新内容。然后审核并保存应用需要追踪的内容。后续检查使用这份已保存的列表。将发现哪些内容的决定与指标结果分开处理。
Chronometrica 同时支持从个人主页发现内容和直接内容输入。因此,它适合这套拟议流程,但仍需检查实际输出是否包含所需计数。Chronometrica Actor
比较采集程序的输入输出约定
采集程序的输入输出约定说明它接受哪些输入,以及文档列出了哪些输出。这有助于选择采集方式,但不能证明它在目标数据源上的实际表现。
| 决策要点 | Chronometrica Instagram Metrics Scraper | WebDataLabs Instagram Posts and Reels Scraper |
|---|---|---|
| 所需输入 | 用个人主页发现内容;用内容 URL 做后续检查 | 文档所述的 Reel 观看次数采集方式需要个人主页 |
| 所需输出单位 | 某次采集时对单项内容的一条观测记录 | 通过个人主页发现的 Reel 观测记录 |
| 所需字段 | 内容标识、`scrapedAt`、所需计数,以及每项计数是否可用 | 所需的 Reel 观看次数和媒体链接 |
| 缺失数据处理规则 | 无法获取的计数保留为缺失状态 | 文档说明,直接链接无法提供 Reel 观看次数 |
| 主要限制 | 直接内容输入不保证能获取观看次数 | 直接链接不提供 Reel 观看次数 |
| 会改变选择的条件 | 所选方式无法获取所需计数 | 反复扫描个人主页已能满足应用需求 |
上述产品信息来自已核查的公开输入输出约定。两款产品都支持定时运行和 API 调用。仅凭自动化能力无法决定本次对比的选择。Chronometrica 输入输出约定、WebDataLabs 输入输出约定
请仔细阅读输出单位这一行。返回的一行内容数据可以帮助识别帖子并更新部分计数,但同一行数据仍可能无法满足观看次数的要求。在将观测记录用于图表之前,先确定什么样的记录才有用。
用简单的定期流程将采集接入 Replit
对于这类需求,定时 API 轮询是一个合理的初始方案。轮询是指重复发送请求来检查结果。以下步骤描述的是拟议的集成方案,并不表示本文测试过 Replit 连接。
- 根据应用的报告需求设置采集计划。确定定时任务是查找新帖子、检查已保存的帖子,还是将两者分成独立任务执行。
- 将选定的输入发送给 Actor。保留本次请求的内容列表,以便应用比较请求条目与返回条目。
- 等待采集完成后再接受输出。发出启动采集的请求,并不等于已经完成指标采集。
- 通过 API 读取已完成的输出。检查内容标识、采集时间、所需字段,以及计数是否可用。
- 将每条通过验收的观测记录连同采集时间一起保存。根据这些已保存的记录更新应用。
- 在存储和应用中明确保留计数的缺失状态。显示数值不可用,不要显示为 0。
webhook 是事件发生时,一个服务向另一个服务发送的消息。所提供的证据无法确认本次对比中的 webhook 配置。拟议的轮询方案可以回答集成问题,而且不依赖尚未核查的消息发送功能。
分别记录最近一次采集尝试和最近一条通过验收的观测记录。如果某次检查失败,或未返回可用计数,应用可以保留较早的观测记录及其原始时间。但不能将旧值显示为新采集的结果。
还要确定应用是否需要历史记录。覆盖上一行数据可以支持显示最新计数。要比较计数随时间的变化,就必须保留较早的观测记录。当前运行无法补出过去没有采集的观测记录。
设置定期运行前,先检查一个有代表性的样本
首次验收检查应使用能够代表应用实际工作的内容。请选择你打算追踪的公开来源。如果应用追踪已保存的 Reels,就检查这些直接 URL。如果应用用于查找近期帖子,就测试从个人主页发现内容的采集方式。
先检查内容标识。将每个返回条目与目标帖子匹配。保存内容的规范 URL,也就是在多次检查中始终用于识别同一内容的统一 URL。不要用帖子在个人主页列表中的位置作为标识,因为这个位置可能变化。
接着检查采集时间。Chronometrica 提供 `scrapedAt`。将该值与观测记录一起保存,让后续阅读者能够知道采集发生的时间。将发布时间与采集时间分开保存。帖子可能发布已久,但采集到的计数仍是当前值。Chronometrica 输出约定
然后检查所需计数。Chronometrica 分别提供 `views`、`plays` 和 `playsInstagram` 字段,并说明每项计数是否可用。存储时要分别保留这些字段。在没有明确报告规则的情况下,不要假定它们含义相同,不要将它们相加,也不要相互替代。Chronometrica 输出约定
为每项计数定义成功标准。如果应用需要观看次数,就只有在所需观看次数值可用时,才能将其接受为有效的观看次数观测记录。一行数据中的点赞数和评论数可能有用,能够满足对应要求,但仍无法满足观看次数要求。
缺失值需要单独处理。0 表示计数为 0。缺失表示计数未知或不可用。将缺失值改为 0 会改变证据,并可能使总数、平均值和排名失真。
最后,检查应用如何展示不完整的结果。创作者页面应明确显示哪些计数缺失。如果部分已保存帖子没有有效的观看次数观测记录,汇总结果就不应让人以为所有帖子都提供了有效数据。应保留足够的信息,以说明显示的结果由哪些观测记录支持。
采集到观测记录后,如需制作报告,请参阅如何在 Instagram 月度观看次数报告中区分新旧帖子。该指南介绍统计核算方法。本次对比讨论的是定期检查应使用哪些输入。
虚构示例:需要后续检查的 10 个帖子
以下示例为虚构内容。它不是测试、客户成果,也不是实际测量的成本对比。
某个应用先发现了创作者的 10 个公开帖子。应用负责人审核列表后,决定追踪这 10 个帖子。应用保存了它们的内容 URL,以及首批通过验收的观测记录的采集时间。
下次定时检查前,创作者又发布了新帖子。应用仍然需要更新原来的 10 个帖子。扫描最新帖子可能会改变发现结果中出现的内容。已保存的列表可以明确保留目标内容集合。
应用提交已保存的 10 个 URL,执行直接内容检查。它使用与首个样本相同的验收规则评估每一行返回数据。它不会因为一次运行完成,就认为所有必需指标都已采集。
假设后续返回的一行数据包含有用的点赞数和评论数,但观看次数不可用。应用可以接受点赞数和评论数,但必须将观看次数保留为缺失状态。即使这行数据对应用的其他部分有用,它也不是有效的观看次数观测记录。
如果每个被追踪条目都必须有观看次数,下一步就应测试能否通过个人主页发现内容的方式获取缺失计数。如果这种方式也无法满足要求,应用就需要其他来源,或缩小报告承诺的范围。
这个示例说明了为什么 Chronometrica 可以适用于已保存列表的工作流程。其直接输入方式解决的是要检查哪些内容。验收检查决定的是应用可以使用哪些指标。这是 2 个不同的决定。
以已保存的 Task 作为初始预设
Task 是为 Actor 保存的输入预设。公开的 Instagram Reels 表现追踪 Task 可以作为起点。
页面检查确认该 Task 页面可以访问,且标题符合预期。但这不能证明当前保存的输入是什么,也不能证明示例 Reel 仍然可用。运行前,请应用下方符合当前输入架构的输入:
{
  "mode": "contentUrls",
  "startUrls": [
    "https://www.instagram.com/reel/DIwcCZgxVZP/"
  ]
}这份输入已根据所提供的公开输入架构通过静态检查。静态检查会检查输入的形式,例如字段名和允许值。它不会采集实时数据。本文没有执行任何采集运行。
将示例 URL 替换为你计划检查的公开内容 URL。在这里,`mode` 用于选择直接内容检查,`startUrls` 用于提供内容列表。文档列出的模式选项为 `auto`、`contentUrls` 和 `profileUrls`。Chronometrica 输入架构
重复执行任务前,先用初始样本检查输出。保存通过验收的内容标识、采集时间、计数,以及每项计数是否可用。然后在下次计划检查时,再次提交已保存的 URL。更新应用前,先比较返回内容与请求列表。
根据所需观测记录做出最终选择
选择能够生成应用所需观测记录的方式。连接成功只能证明程序之间能够交换请求和结果,不能证明所需的公开计数一定存在。
对于已保存的内容列表,本次对比建议从 Chronometrica 开始,因为已核查的输入输出约定支持直接输入,并明确提供计数可用状态。但这项建议有条件:样本必须满足你对所需字段的要求。Chronometrica Actor
如果所需观看次数缺失,就更换采集方式或测试其他来源。不要为了让集成看起来已完成而取消这项验收规则。同样,如果从个人主页发现近期内容已经能回答应用的问题,就不必增加固定列表流程。
有用的决策必须明确:每次运行必须复查哪些内容,必须返回哪项计数,以及该计数缺失时应用应如何处理?
来源和延伸阅读
- Chronometrica Instagram Metrics Scraper:公开输入输出约定于 2026 年 10 月 20 日核查;支持个人主页和直接内容输入,但不保证能通过直接 URL 获取观看次数;未进行新的对比运行。
- WebDataLabs Instagram Posts and Reels Scraper:公开输入输出约定于 2026 年 10 月 20 日核查;文档说明,通过个人主页发现内容可获取 Reel 观看次数和媒体链接,而直接链接不提供 Reel 观看次数;未进行新的对比运行。
- Replit 网红追踪应用讨论:关于定期接入公开指标的问题;背景资料于 2026 年 10 月 20 日提供,未报告另行进行在线核查;不是对供应商的推荐,也不是经过验证的产品测试。
- Instagram Reels Performance Tracker Task:初始预设页面;2026 年 10 月 20 日提供的页面检查证据确认页面可以访问,且标题符合预期,但未确认当前保存的输入或示例 Reel 是否可用;未执行采集运行。
- 《如何在 Instagram 月度观看次数报告中区分新旧帖子》:用于采集到观测记录后的分析;指南范围说明于 2026 年 10 月 20 日提供,未报告新的页面检查;用于已有快照后的报告统计核算。
作者 Chronometrica · 更新日期
返回顶部 ↑