- 先从已知的主页名册开始,并保留你的原始输入。Actor 接受已知主页,不能按年龄、地点或粉丝数搜索全部主页。必须先有一份人工名单。
- 先运行一个公开主页,以测试你的设置。对照公开来源检查它的规范 channelUrl、handle、channelId、status、statusReason 和 observedAt。有用的行可能只是部分结果,仅凭名称匹配并不能纠正错误的目标。
- 把标识符存为文本字符串,并把命名空间定义为 instagram:channelId。不要只因为数字相同,就把 Instagram 的 channelId 与其他平台 ID 混在一起。fbid 字段是与 Meta 关联的标识符,不是 Facebook 公共主页 ID。
- 用安全的主页 URL 和 @handles 建立规范化的输入别名表,同时保留原始输入。为比较去掉普通的结尾斜杠和查询标记,但不要把 story 或 login 路由变成主页身份。别名规范化与 Actor 按精确字符串折叠重复项是分开的。
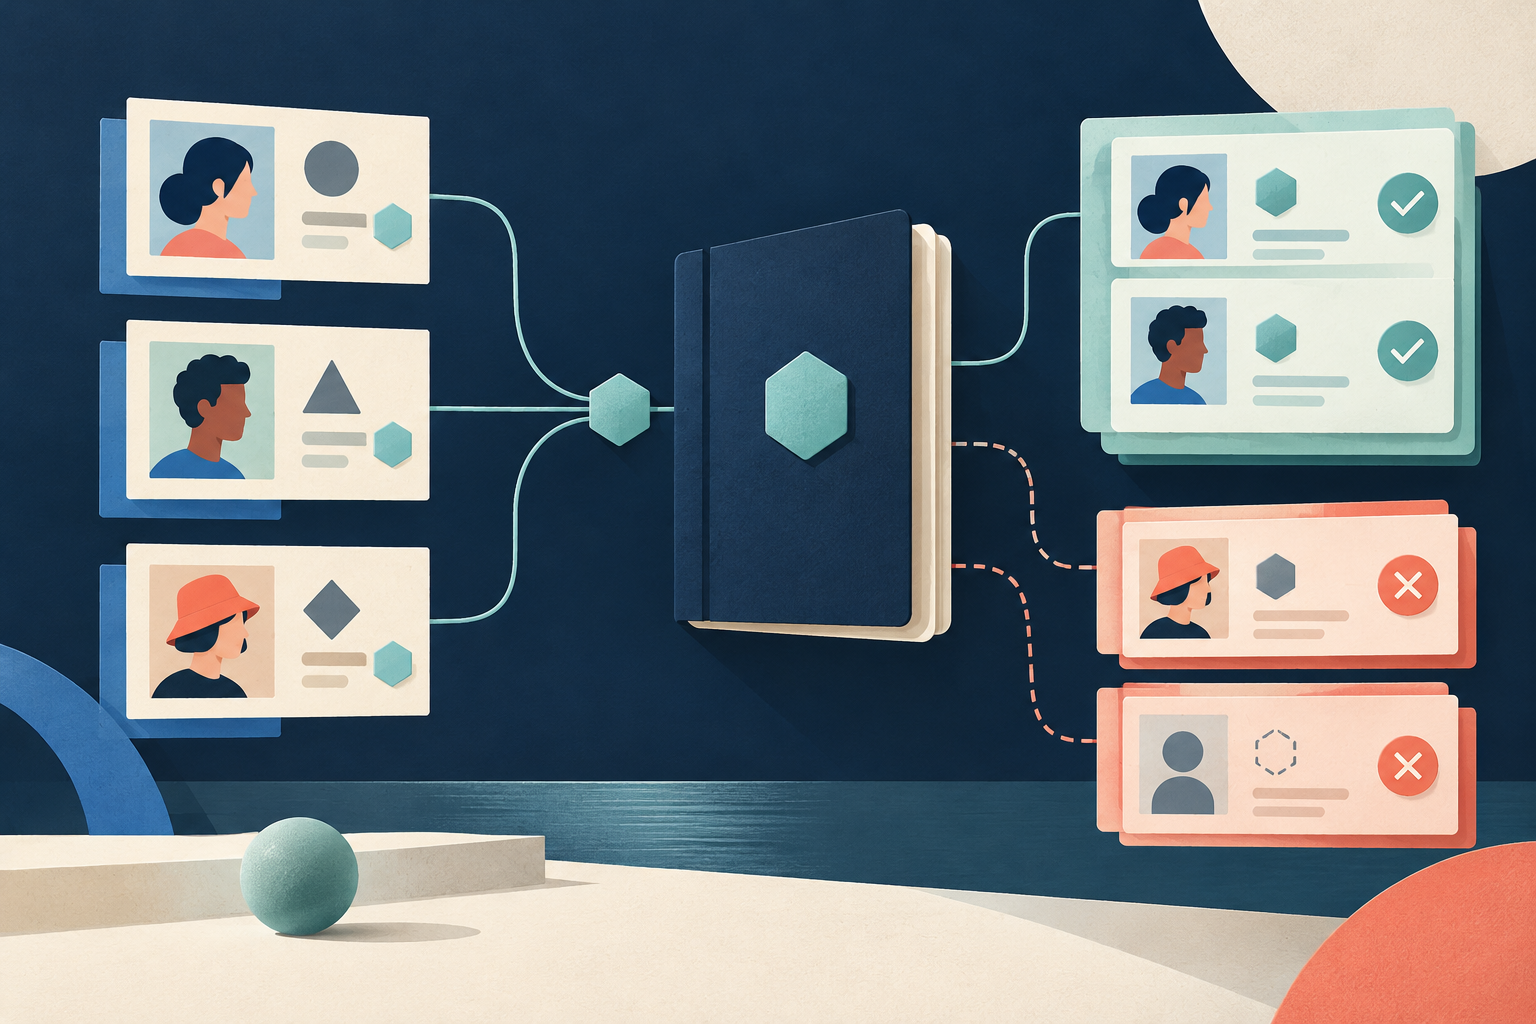
- 按非空白的 channelId 值对当前观察分组。保留从输入到 channelId 的边,以及规范 channelUrl 值。当同一个 handle 在不同观察时间对应不同的 channelId 值时,保留两条记录,并检查公开来源,不要盲目覆盖旧数据。缺失的历史不能说明冲突为什么发生。
- 若 channelId 值缺失,则把规范 channelUrl 或 handle 保留为较弱的临时证据。绝不要仅按显示名称合并账号。把 blocked、private 或 parser_miss 行留在已验证身份表之外。本地临时键是用于跟踪的元数据,不是编造的稳定身份。
- 把结果分成已验证身份、输入别名、未解决的观察和冲突。已知身份要与输入行、有用行和观察到的 handle 分开计数。在加入额外事实之前,先解释来源状态与已采集数据之间的任何差距。
- 为以后的刷新追加一条带有 observedAt 的新观察。Actor 不会自动返回历史变化,因此在比较计数或随时间变化的链接列表之前,你必须先检查身份。
演算示例与表格
以下表格展示原创虚构内容,用来说明此方法如何运作。
名册到 ID 的别名表
| 名册行 | 原始输入 | 原始来源 channelId | 状态 | 规范 channelUrl | observedAt | 复核状态 |
|---|---|---|---|---|---|---|
| R1 | @greenstudio | 10001 | ok | https://www.instagram.com/greenstudio | 2026-03-01 | 已验证别名 |
| R2 | https://www.instagram.com/greenstudio/?ref=sheet | 10001 | ok | https://www.instagram.com/greenstudio | 2026-03-01 | 已验证别名 |
| R3 | @green_studio | 20002 | ok | https://www.instagram.com/green_studio | 2026-03-01 | 已验证别名 |
| R4 | @summerlab | null | partial | https://www.instagram.com/summerlab | 2026-03-01 | 临时 |
| R5 | @private_notes | null | private | null | 2026-03-01 | 未解决 |
两个已知 ID 登记表
| channelId | 关联的别名 / 输入 | 状态摘要 | 复核状态 |
|---|---|---|---|
| 10001 | @greenstudio, https://www.instagram.com/greenstudio/?ref=sheet | ok | 已验证身份 |
| 20002 | @green_studio | ok | 已验证身份 |
冲突与复核行
| 原始输入 | 原始来源 channelId | 状态 | observedAt | 复核状态 |
|---|---|---|---|---|
| @greenstudio | 30003 | ok | 2026-06-01 | 与 10001 冲突(没有更名或出售的证明) |
已验证的表里有两个互不相同的已知身份,不是五个身份,也不是按一个显示名称计成的一个身份。行 R1 和 R2 是 channelId 10001 的两个输入别名。行 R4 是临时的,因为它缺少 channelId;行 R5 未解决,因为它是 private。在后来的一条虚构观察中,@greenstudio 对应 channelId 30003。把这存为带有 observedAt 时间戳的身份冲突。它不能证明更名、账号出售或冒充。在合并任何相互冲突的行之前,你必须检查边表和来源事实。
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑