収集の設定
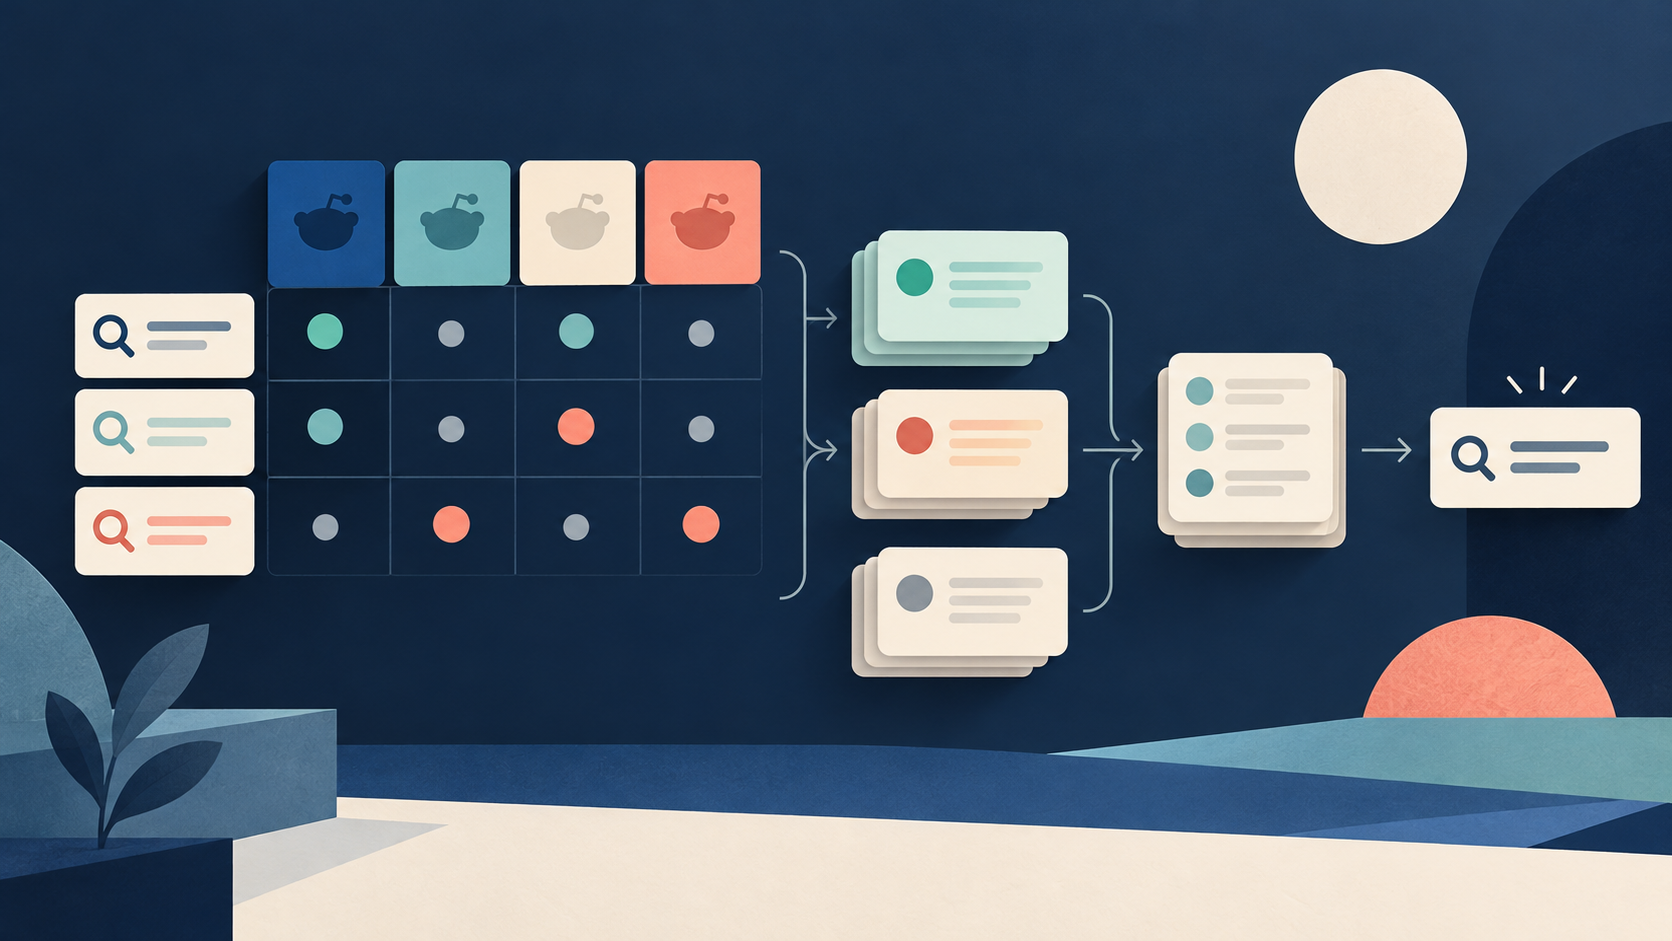
Reddit Search ScraperのActorと、Reddit Brand Mention SnapshotのTaskを開いてください。ツールの入力項目は、query、任意のsubreddits、maxResults、sort、timeです。現在のプリセットでは、queryに`"Brand Name"`、maxResultsに100、sortにnew、timeにmonthを使っています。queryを調査に関連する自分のフレーズに置き換え、まずはmaxResultsを3にしてください。MaxResultsは全体で共有する上限であり、サブレディットごとの割り当てではありません。
データセットの各行には、inputQuery、requestedSubreddit、matchedSubreddit、sort、time、rank、postId、canonicalPostUrl、title、body、createdAt、status、statusReason、unavailableFields、observedAtというフィールドがそのまま保持されます。取得元の順位は並び順を示すもので、関連性を示すものではありません。本文や文脈が取得できない場合は、判定保留のままにします。
検証したlearnpythonの対照テストは、3行で上限に達しました。これは、読者が実行するたびに上限に達すると予測するものでも、読者の検索クエリの関連性を検証するものでもありません。実行全体のisCompleteがtrueであることは処理の結果を示し、取得元の母集団全体を取得したことを意味しません。行のrequestedSubredditやmatchedSubredditは、サマリーのsubredditと異なる場合があります。
出力のsearchResultsの各項目には、query、subreddit、status、reason、candidatesFound、rowsSaved、duplicatesSkipped、endReason、source、sourceUrlが含まれます。実行サマリーには、status、statusReason、isComplete、query、searchesPlanned、searchesSucceeded、candidatesFound、usefulRows、rowsSaved、billableRows、freeRows、duplicatesSkipped、stopReason、observedAtが含まれます。対照テストのsearchResults[0]では、subredditはlearnpython、statusはok、rowsSavedは3、endReasonはmax_results_reached、sourceはreddit_rssでした。
調査手順の全体
- 検索する前に、調査したい問題と、結果を調査対象に含める基準を明確にしてください。対象の製品またはテーマと、その文脈を具体的に示します。スポーツや動物の名前にもなる語には、明確な文脈が必要です。
- 最初の検索クエリを、通常の形式または引用符で囲んだ形式で保存し、並べ替え方法、対象期間、上限も記録してください。取得元の投稿をすべて確認できるように、少数の結果を1回分だけ取得します。行を変更せず、入力と出力もそのまま保持してください。
- タイトルと本文を読み、必要に応じて取得元の議論も確認してください。各結果を「関連あり」「関連なし」「判定保留」に分類し、明確な理由を付けます。本文で自社ブランドに言及しているからといって、その製品について質問しているとは限りません。取得できない本文を「関連なし」に分類しないでください。
- 無関係な結果が一致した理由を列挙してください。複数の意味を持つ名前、供給業者の宣伝、求人、無関係な用法、調査の問いと異なる質問、確認できない文脈がないかを調べます。これらの理由が、検索クエリを改善する手掛かりになります。
- 1回に1つの要素を変更してください。問題を表す語を追加する、より明確なフレーズを使う、または根拠のあるコミュニティに検索範囲を限定するといった変更が考えられます。比較できるように、変更前と変更後の範囲を記録してください。
- 同じ判定基準で小規模なテストを繰り返してください。「関連あり」の件数と「判定保留」の件数は分けて報告します。検討に使う比率の横に、収集した総件数と判定保留の件数をすべて示してください。小規模なサンプルは、精密な比較基準にはなりません。
- 意図した種類の問題を引き続き捉えられる場合に限り、より明確な検索クエリを選んでください。絞り込みすぎると、ほかの有用な表現を見落とす可能性があります。必要に応じて、補完的なフレーズもテストしてください。
- 入力、範囲、取得元ID、ラベル、理由、次に使うと決めた検索クエリを、検索クエリのテストシートに保存してください。定期的な収集とスケジュール設定は、その後に行います。変更内容を確認できるようにしておいてください。
架空のテスト例
ここに示す検索結果と製品名は、すべて架空のものです。製品Orbitは、プロジェクト用のツールです。Orbitという広い検索クエリでは、6件の投稿が返されます。2件はプロジェクトのセットアップに関するもの、2件は天文学に関するもの、1件はユーザーの問題を含まない供給業者の宣伝で、1件は本文を取得できません。分類結果は「関連あり」が2件、「関連なし」が3件、「判定保留」が1件です。収集した全投稿では、6件中2件、つまり33.3パーセントが「関連あり」です。判定できた5件の投稿では、5件中2件、つまり40パーセントが「関連あり」です。どちらの数値も、実際のツールの精度を主張するものではありません。
プロジェクトのセットアップを対象に修正したフレーズでは、4件の投稿が得られます。関連するセットアップの議論が3件あり、本文にアクセスできず判定保留となるものが1件あります。収集した全投稿に占める「関連あり」の割合は、4件中3件、つまり75パーセントです。判定できた投稿に限ると、3件中3件、つまり100パーセントであり、判定できない1件も明示します。セットアップのフレーズでは見落とす移行の問題を確認するため、補完的な移行用クエリで、別の一群の結果を取得することを提案します。
以下の検索クエリのテストシートには、架空の検索結果への出現10件と、そのラベルを記載しています。1つの取得元IDが両方の取得結果群に現れます。調査データを統合する際は、検索結果への出現は2件のまま記録し、取得元としては同一の1件として扱います。
| 取得結果群 | 取得元ID | 使用した検索クエリ | ラベル | 理由 |
|---|---|---|---|---|
| 広い検索 | src_01 | Orbit | 関連あり | プロジェクトのセットアップに関する議論 |
| 広い検索 | src_02 | Orbit | 関連あり | プロジェクトのセットアップに関する議論 |
| 広い検索 | src_03 | Orbit | 関連なし | 天文学に関する議論 |
| 広い検索 | src_04 | Orbit | 関連なし | 天文学に関する議論 |
| 広い検索 | src_05 | Orbit | 関連なし | 供給業者の宣伝 |
| 広い検索 | src_06 | Orbit | 判定保留 | 本文を取得できない |
| 修正後 | src_02 | "Orbit" project setup | 関連あり | セットアップに関する質問が解決 |
| 修正後 | src_07 | "Orbit" project setup | 関連あり | セットアップの不具合修正 |
| 修正後 | src_08 | "Orbit" project setup | 関連あり | セットアップの設定 |
| 修正後 | src_09 | "Orbit" project setup | 判定保留 | 本文を取得できない |
この判定に基づき、セットアップに関する質問にはセットアップのフレーズを選び、移行については検索範囲のテストが引き続き必要とし、取得できない本文は判定保留のままにします。この後に、返信や感情分析の結果を出力することはありません。
出典と参考資料
著者 Chronometrica · 更新日
ページの先頭へ ↑