収集の設定
まず、ActorとTaskを関連付けて設定を始めます。現在のプリセットは、queryが"customer feedback"、subredditsが"SaaS"、"Entrepreneur"、"smallbusiness"、maxResultsが150、sortが"relevance"、timeが"year"です。これらは汎用的な初期設定であり、最適なコミュニティであると実証されたものではありません。選定理由を説明できる収集元の候補に置き換えてください。
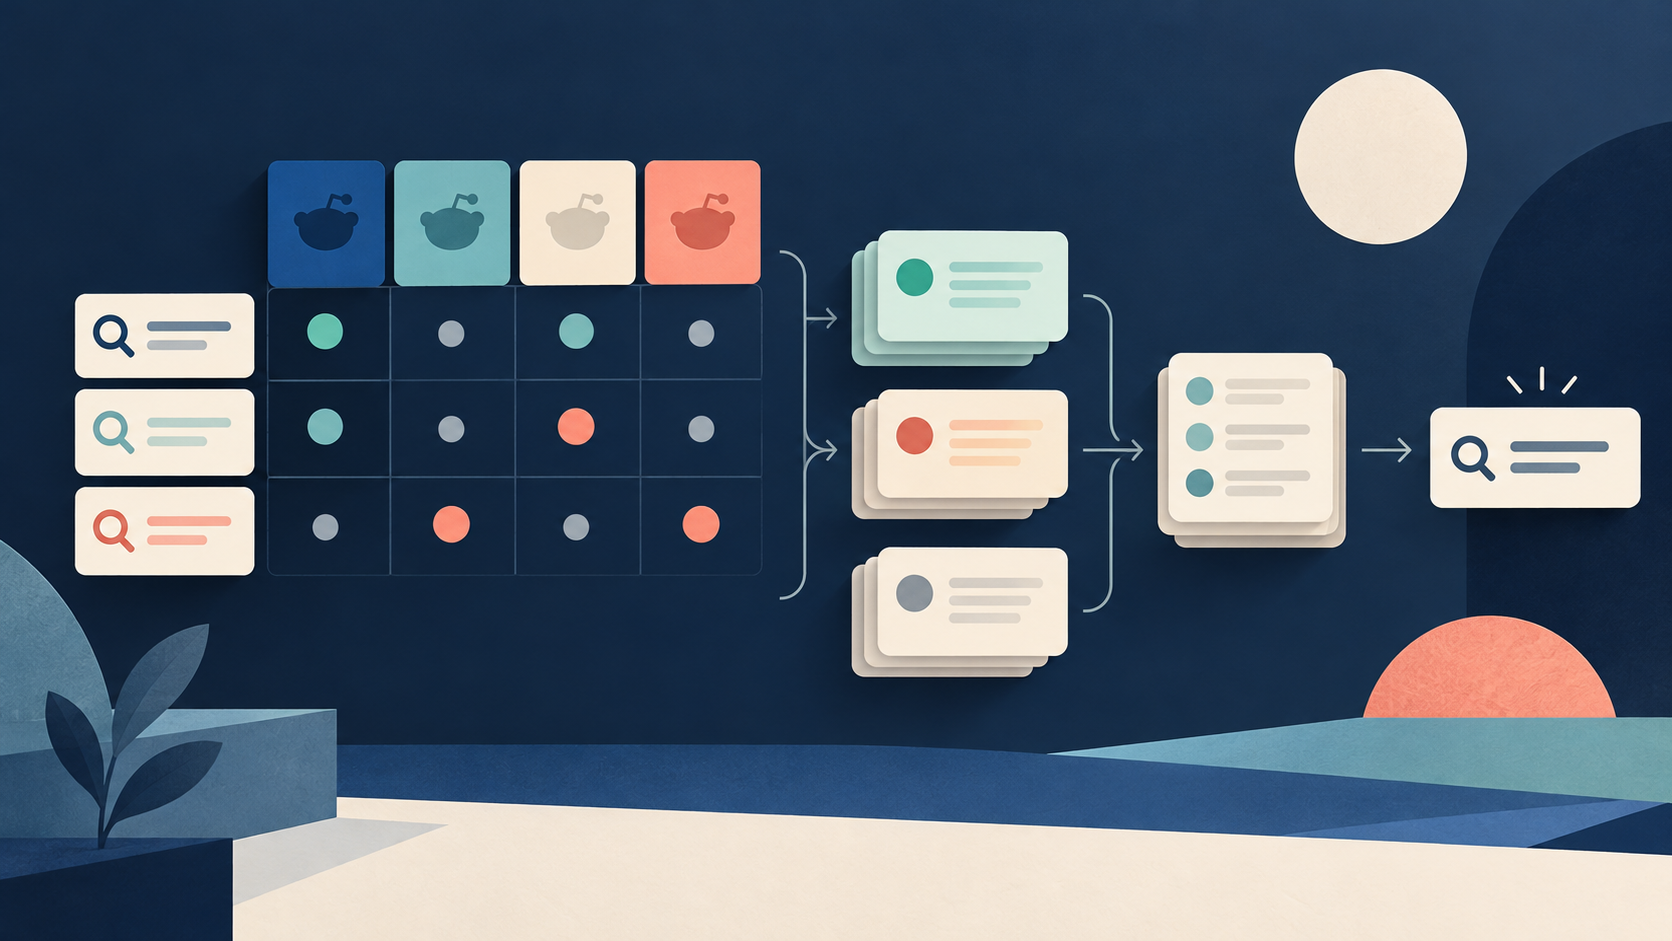
同じ検索語句、並び順、対象期間を使い、1回の実行につき投稿3件を上限として、個別に実行した結果を比較します。複数の収集元をまとめて1回で実行すると、すべての収集元でmaxResultsを共有するため、大規模な収集元1つだけで早い段階に上限に達することがあります。主要な出力フィールドであるinputQuery、requestedSubreddit、matchedSubreddit、postId、canonicalPostUrl、title、body、createdAt、rank、status、unavailableFields、observedAtを保持してください。
本文が欠けていて文脈を把握できない投稿は、未確認のままにします。検索結果での順位が低くても、それは検索の表示順を示すもので、投稿の質を示すものではありません。投稿IDが表すのは見つかった投稿であり、個々の顧客ではありません。
出力の各searchResultsエントリには、query、subreddit、status、reason、candidatesFound、rowsSaved、duplicatesSkipped、endReason、source、sourceUrlが含まれます。実行サマリーには、status、statusReason、isComplete、query、searchesPlanned、searchesSucceeded、candidatesFound、usefulRows、rowsSaved、duplicatesSkipped、stopReason、observedAtが含まれます。監査に必要な収集の診断情報を使い、内部コストのフィールドは省いてください。
最近の対照実行では、searchResults[0]にsubreddit=learnpython、status=ok、rowsSaved=3、endReason=max_results_reached、source=reddit_rssが記録されました。全体の状態を示すisComplete=trueは、処理が完了したことを確認するものであり、コミュニティの母集団全体を網羅したことを意味しません。行単位のrequestedSubredditとmatchedSubredditは、サマリーのsubredditフィールドと異なる場合があることに注意してください。
収集元の範囲を段階的に定める
- 顧客が置かれた状況、行う判断、必要な情報を明記します。収集元の役割として、ユーザーコミュニティ、専門実務者のコミュニティ、製品サポートのコミュニティ、創業者による一般的な議論の場を区別します。
- 対象の話題について実際に交わされている議論から、公開コミュニティの候補を探します。その目的、ルール、最近の関連スレッドを読みます。コミュニティ名だけから、メンバーが購入者であると推測しないでください。
- 各コミュニティを含める理由、または除外する理由を書きます。メンバー数の多さだけでなく、異なる視点を得られる収集元を選びます。収集元の文脈を尊重し、調査を行うことを宣伝の許可と解釈しないでください。
- 選んだ各コミュニティで、同じ小規模な検索を個別に実行します。件数上限、並び順、対象期間、観測日時を比較可能な条件にそろえます。対象範囲外の結果を確認できるよう、指定したサブレディットと実際に一致したサブレディットを保存します。
- 返された投稿を調べ、初心者、経験豊富なユーザー、管理者の状況なのか、あるいは販売業者による主張なのかなど、記述されている状況を特定します。ユーザー名から人物像を推測せず、不確実な点は不確実なままにします。課題が本人の直接体験に基づくものか、伝聞なのかを判断できるだけの文脈を読みます。
- 視点ごとにどこまで把握できたかを比較し、意思決定に関わるどの条件が現れ、どの条件が欠けているかを確認します。件数が示すのは観測した標本であり、市場全体でその課題がどの程度一般的かは分かりません。検索結果が得られなくても、顧客ニーズがないのではなく、その検索では見つかりにくいだけかもしれません。
- 少数で多様な収集元からなる標本抽出枠を選び、把握できていない層の声を記録します。新しい視点が得られる場合に限り、別の収集元を追加します。際限なく収集しないでください。
- 収集元の選定表、検索語句と件数上限の設定一覧、まだ把握できていない視点の一覧を成果物としてまとめます。その後のコーディングや製品に関する判断は、別の作業です。
架空の具体例で手順を確認する
コミュニティ名、投稿、顧客の状況は、すべて架空です。小規模なチームがバックアップの作業手順をどのように選ぶか、という調査課題を考えてみましょう。候補となる4つの収集元を、それぞれ小さい件数上限と並び順、対象期間のパラメーターを設定して個別に実行し、検証します。
- BeginnerFiles:確認済みの投稿は3件です。2件は設定時に本人が経験した戸惑いを示し、1件は無関係です。収集元としての役割は、初心者による設定の把握です。導入時の課題を把握するために含めます。
- AdminPractice:投稿は3件です。2件は復旧とテストに関する議論で、1件は販売業者からの告知です。収集元としての役割は、経験豊富な実務者による運用の把握です。障害と復旧の条件を把握するために含めます。
- ToolQSupport:投稿は3件です。2件は特定のツールのエラーについて述べており、1件は本文が欠けています。収集元としての役割は、現在の製品のトラブル対応の把握です。用途を限定して含め、1行は未確認のまま保持します。
- FounderChat:投稿は3件です。1件は予算の制約を示し、2件は宣伝上の主張です。収集元としての役割は、予算に関する背景の把握です。補助的な収集元として保持し、技術的な信頼性を判断する主な収集元にはしません。
これらの収集で得られる投稿は合計12件です。本人の直接体験に基づき、調査に関連する状況を示す行が7行あります。内訳はBeginnerFilesが2行、AdminPracticeが2行、ToolQSupportが2行、FounderChatが1行です。除外した行は4行で、同じ順に1行、1行、0行、2行です。未確認の行は1行あります。
関連する投稿が7件あっても、重複を除いた顧客が7人いることにはなりません。同じ投稿者による複数の投稿や、クロスポストが含まれる可能性があるためです。それぞれ3行という小さな標本から、母集団の相対的な規模は判断できません。
完成した標本抽出枠では、BeginnerFiles、AdminPractice、ToolQSupportを互いに補完する主な収集元として選び、FounderChatを予算に関する背景を補う任意の収集元とします。把握できていない声には、公開の場に投稿しないチームや、助けを求めずに復旧に成功した所有者の声があります。FounderChatの検索語句を変える場合は、別の補助標本として明記し、その比率を元の固定した検索語句による比較に混ぜないでください。
| コミュニティ | 目的 | 含める理由 | 除外する理由 | 検索範囲 | 不明な点 |
|---|---|---|---|---|---|
| BeginnerFiles | 初心者による設定 | 導入時の課題を把握する | 無関係な投稿 | 検索語句を固定、上限3件、年間を対象 | 初心者の実数 |
| AdminPractice | 運用 | 復旧の条件を把握する | 販売業者からの告知 | 検索語句を固定、上限3件、年間を対象 | 障害の発生頻度 |
| ToolQSupport | トラブル対応 | ツールのエラーを追跡する | なし(本文が欠けている投稿は未確認) | 検索語句を固定、上限3件、年間を対象 | 未確認のエラー発生率 |
| FounderChat | 予算に関する背景 | 費用の制約を把握する | 宣伝上の主張 | 検索語句を固定、上限3件、年間を対象 | 購入者の予算総額 |
出典と参考資料
著者 Chronometrica · 更新日
ページの先頭へ ↑