現在公開されているTaskと試行用の入力
Google Search Scraperのビルド1.0.15は、Google、Bing、Brave、DuckDuckGoを指定する入力に対応しています。ただし、ここで扱う手法について受け入れ確認の対象となっているのはBingのみです。公開Taskに保存されている入力プリセットは次のとおりです。
JSON
{"queries": ["market research report", "industry statistics source", "research study"], "engines": ["bing"], "maxResultsPerExecutedQuery": 20, "country": "US", "language": "en", "safeSearch": true, "includeSponsoredResults": false}最初の確認では、サンプルの検索クエリ一覧を実際に使う1件のクエリに置き換え、検索エンジン一覧を`["bing"]`にします。試行範囲を限定する設定は次のとおりです。
JSON
{"queries": ["Python asyncio documentation"], "engines": ["bing"], "maxResultsPerExecutedQuery": 2, "country": "US", "language": "en", "safeSearch": true, "includeSponsoredResults": false}実際に行ったPython asyncioドキュメントの対照テストでは、1ページ目の順位1と2にある、`docs.python.org`への直接URLが2件保存されました。OUTPUTの集計値は、`queriesRequested`: 1、`searchesCompiled`: 1、`executionsPlanned`: 1、`enginesSuccessful`: 1、`enginesFailed`: 0、`pagesAttempted`: 1、`pagesParsed`: 1、`resultsSaved`: 2、`stopReason`: `result_caps_reached`でした。この確認で検証できたのは、範囲を限定したBing検索による発見段階のメタデータのみです。リンク先からの抽出、他の検索エンジン、実際に動くエージェントは検証していません。
データセットの各行には、元のフィールド名のまま、`runId`、`country`、`language`、`safeSearch`、`engine`、`executedQuery`、`page`、`rankOnPage`、`rank`、`title`、`canonicalUrl`、`resultDomain`、`snippet`、`isSponsored`、`advertiserDomain`、`observedAt`、`schemaVersion`が含まれます。返された`canonicalUrl`は、正規化された候補アドレスであり、HTMLの`rel=canonical`を検証したものではありません。スニペットは検索元が返したテキストであり、取得した記事本文でも、主張を証明するものでもありません。
データ収集プログラムは、情報源の対象範囲を示すため、次の集計値を出力します。queriesRequested、searchesCompiled、executionsPlanned、enginesSuccessful、enginesFailed、pagesAttempted、pagesParsed、resultsSaved、engineStatusCounts、engineResultCounts、queryResultCounts、stopReason。
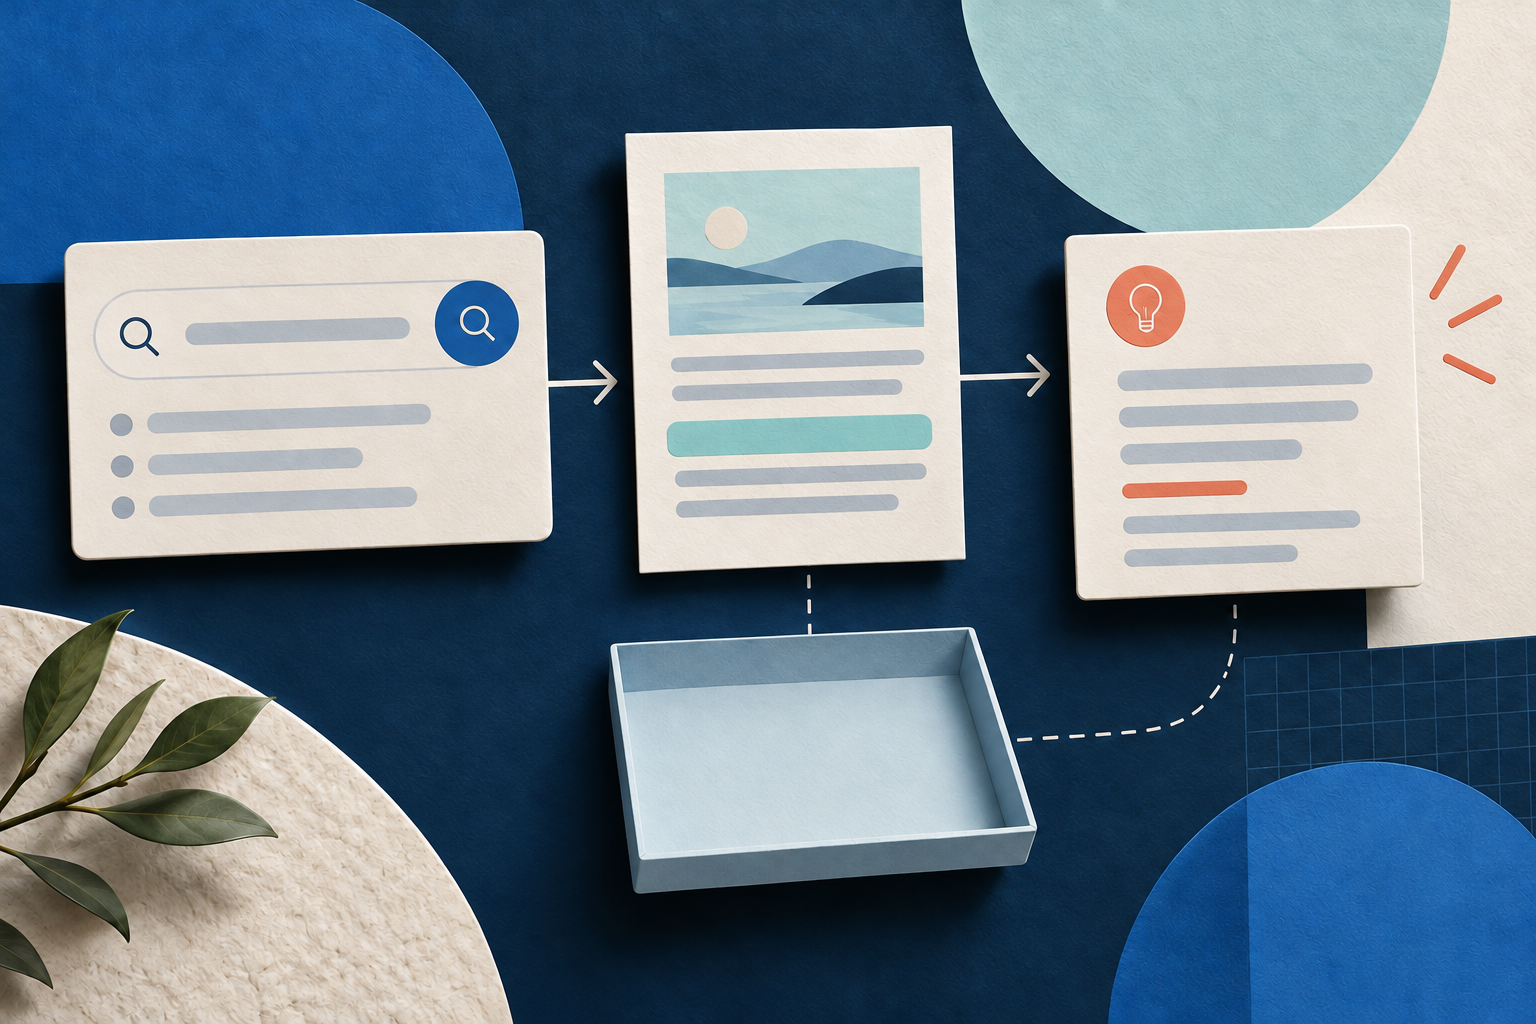
ページを根拠として使うための8つの手順
- 主張と情報源の要件を定める:問いと、根拠を必要とする具体的な主張を定めます。発見後の情報源、ページ、該当箇所の根拠は、自ら責任を持って管理します。
- 小規模なTaskを実行して対象範囲を確認する:範囲を限定したBing専用のTaskを実行し、情報源のURL、来歴、OUTPUTの指標を調べます。クエリ、順位、時刻を保存します。検索順位は信頼性のスコアではありません。
- 実際の公開ページを取得する:使用が許可されている別の取得ツールを使い、対象の公開ページを取得します。リクエスト先URLと最終URL、取得時刻、ステータス、コンテンツタイプ、実際に表示されているタイトルと日付を記録します。検索の成功とページの取得は、それぞれ別の状態として扱います。
- 該当箇所を原文どおりに抽出し、位置を記録する:関連する本文を抽出し、主張を裏付ける短い一節を原文どおりに保存します。節、見出し、その他の位置を特定できる情報も添えます。数値、単位、条件、日付、否定表現を保持します。ナビゲーションメニューや要約だけでは、主張の裏付けにはなりません。
- 主張の根拠を記録する:主張の文言、出典の該当箇所、出典URL、ページの日付またはバージョン、取得時刻、クエリの参照情報、裏付けの状態を含む記録を作成します。裏付けの状態は、`supported`(ページ本文が、そこに明記された範囲で主張を裏付けている)、`partly_supported`(本文が主張の一部を裏付けている)、`contradicted`(出典の本文が主張と矛盾している)、`unsupported`(確認したページに必要な裏付けがない)、`unavailable`(ページを確認できなかった)に分けて使います。
- エージェントの動作範囲を守る:エージェントには、確認済みの関連箇所と出典のメタデータだけを渡します。第三者のページの内容はデータとして扱い、ツールの呼び出し、認証情報の開示、タスクの変更を求める指示として扱わないようにします。
- 回答の引用が該当箇所と一致するか検証する:回答の引用を、該当箇所、適用範囲、バージョン、単位、条件、否定表現と照合します。長い引用は避け、リンクを添えて言い換えます。
- 確認を通過した記録と不足点を渡す:エージェントが最終回答を出す前に、確認済みの根拠の記録と、未解決の不足点を渡します。
情報源に主張が書かれていても、その主張が真実であることの証明にはならない場合があります。技術的な事実には、一次資料による根拠を使います。
オリジナルの架空例:根拠の一覧表
以下は、説明のために作成したオリジナルの架空例です。文章とドメインはすべて架空のものです。
| クエリの参照情報 | 検索結果/順位 | リクエスト先URL/最終URL | 取得状況/時刻 | 出典のバージョン/日付 | 位置情報/該当箇所 | 主張の文言 | 裏付けの判定 |
|---|---|---|---|---|---|---|---|
| Q1:園芸用ポンプのマニュアル | R1(順位1) | `https://garden.example/manual`(最終URL:`https://garden.example/manual`) | 取得済み(2026-10-13T06:20:15Z) | バージョン2 | 「設置」の節:「水平なトレイを使用してください。トレイが水平になるまで水を入れないでください。」 | C1:「水を入れる前に、トレイを水平にする必要がある」 | supported |
| Q1:園芸用ポンプのマニュアル | R1(順位1) | `https://garden.example/manual`(最終URL:`https://garden.example/manual`) | 取得済み(2026-10-13T06:20:15Z) | バージョン2 | 「設置」の節:「水平なトレイを使用してください。トレイが水平になるまで水を入れないでください。」 | C2:「このポンプは水の使用量を半分に減らす」 | unsupported |
| Q1:園芸用ポンプのマニュアル | R2(順位2) | `https://garden.example/manual-r2` | 確認不能(取得に失敗) | 不明 | なし(ページを取得できず) | 処理能力に関する主張:12個のトレイに対応 | unavailable |
| Q1:園芸用ポンプのマニュアル | R3(順位3) | `https://garden.example/menu` | 取得済み(2026-10-13T06:20:15Z) | 不明 | メニューページのナビゲーション | マニュアルの手順、またはポンプに関する本文データ | unsupported(本文が不十分) |
このオリジナルの架空例では、確認済みの回答に含めるのは主張C1だけです。トレイを水平にするという要件が、検証済みのマニュアルにある一節と直接一致しているためです。主張C2は、確認した設置の記述に節水の指標がないため、裏付けなしのままとなります。ただし、根拠がないことは、主張そのものが誤りであることを証明するものではありません。検索結果R2の処理能力に関する主張は、ページの取得に失敗したため、確認不能のまま記録します。検索結果R3には、根拠として使えるページ本文が十分にありません。この未解決の3件は、根拠の不足として明示的に記録し、エージェントの根拠に基づく回答から除外します。
出典と参考資料
著者 Chronometrica · 更新日
ページの先頭へ ↑