Configuration de la collecte
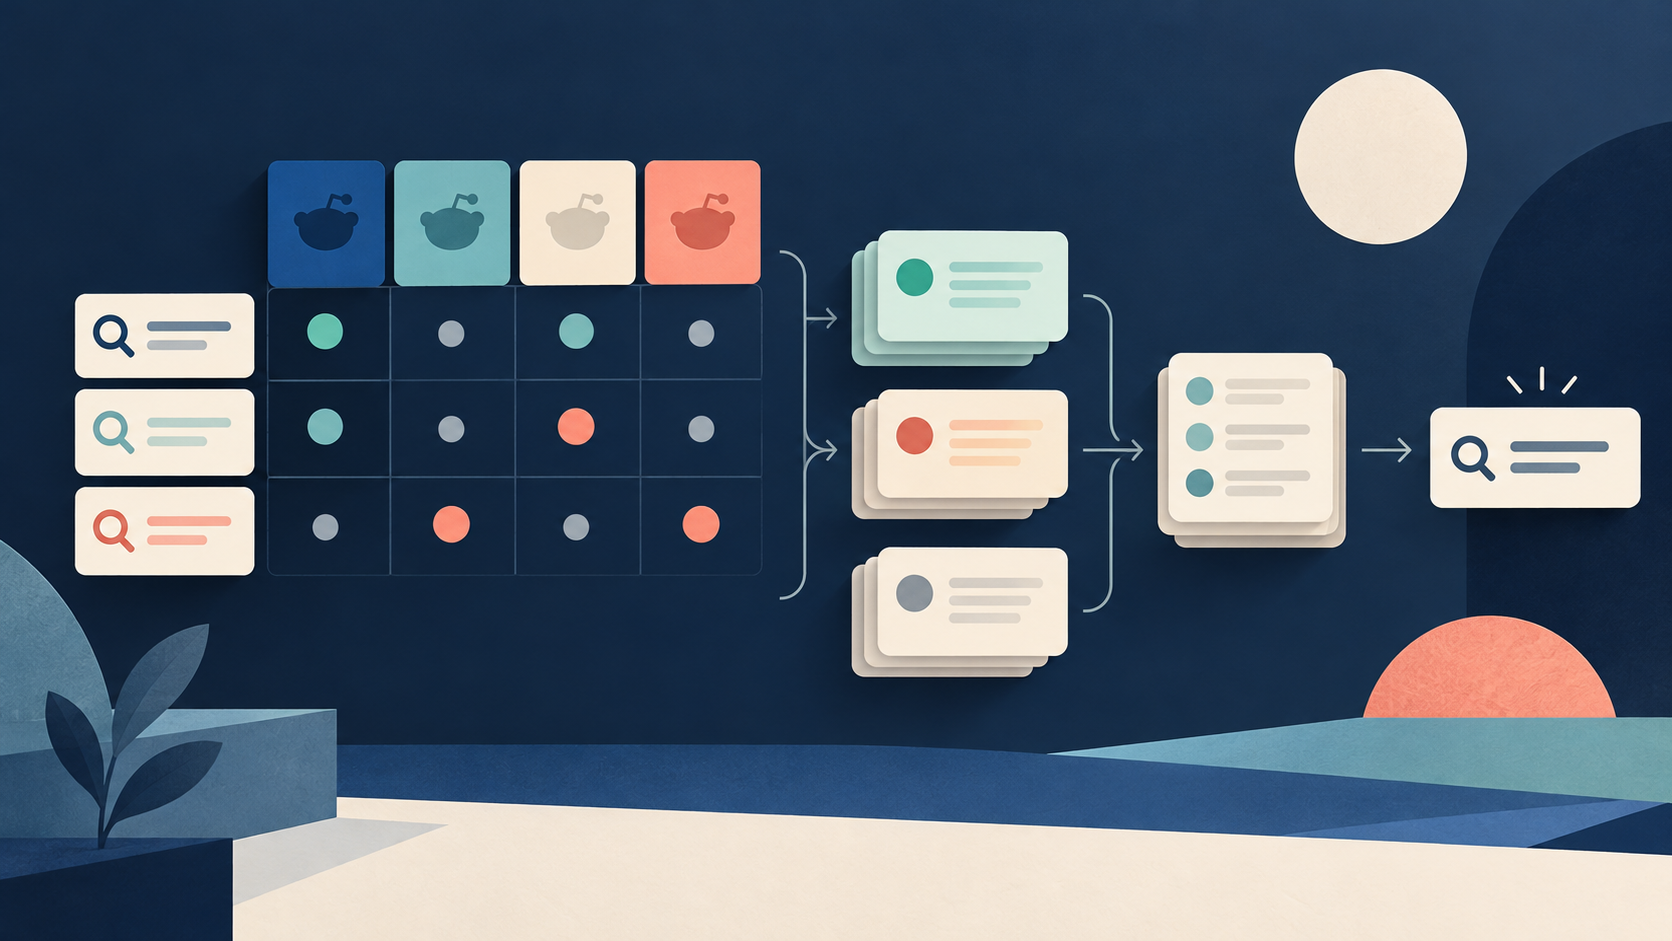
Commencez la configuration en reliant l'Actor et la Task. Le préréglage actuel utilise la requête "customer feedback", les subreddits "SaaS", "Entrepreneur" et "smallbusiness", maxResults 150, sort "relevance" et time "year". Rien ne montre que ces communautés génériques par défaut sont les meilleurs choix. Remplacez-les par des sources candidates justifiées.
Comparez des exécutions séparées qui utilisent la même requête, le même tri, la même période et un plafond de 3 publications par exécution. Une exécution mixte partage maxResults entre toutes les sources, ce qui permet à une grande source de consommer le plafond tôt. Conservez les champs de sortie essentiels : inputQuery, requestedSubreddit, matchedSubreddit, postId, canonicalPostUrl, title, body, createdAt, rank, status, unavailableFields et observedAt.
Une publication dont le contexte du corps manque reste non examinée. Un rang de source plus bas indique l'ordre de recherche, pas la qualité de la publication. Les identifiants de publication représentent les publications découvertes, pas des clients individuels.
Chaque entrée searchResults de la sortie contient query, subreddit, status, reason, candidatesFound, rowsSaved, duplicatesSkipped, endReason, source et sourceUrl. Le résumé de l'exécution comprend status, statusReason, isComplete, query, searchesPlanned, searchesSucceeded, candidatesFound, usefulRows, rowsSaved, duplicatesSkipped, stopReason et observedAt. Utilisez les diagnostics de collecte utiles à votre audit, et ignorez les champs de coût internes.
Lors d'une exécution de contrôle récente, searchResults[0] a enregistré subreddit=learnpython, status=ok, rowsSaved=3, endReason=max_results_reached et source=reddit_rss. Un statut global isComplete=true confirme un traitement terminé, pas une couverture complète de la population de la communauté. Notez que les champs de ligne requestedSubreddit et matchedSubreddit peuvent différer du champ subreddit du résumé.
Construire un cadre de sources étape par étape
- Nommez la situation du client, la décision et l'information nécessaire. Traitez comme des rôles de source distincts les communautés d'utilisateurs, les communautés de praticiens professionnels, les communautés d'assistance produit et les discussions générales de fondateurs.
- Trouvez des communautés publiques candidates à partir de discussions réelles sur le sujet. Lisez leur objectif, leurs règles et les fils récents pertinents. N'inférez pas le statut d'acheteur à partir du seul nom de la communauté.
- Écrivez une raison d'inclusion ou d'exclusion pour chaque communauté. Choisissez des sources pour des perspectives différentes, pas seulement pour un grand nombre de membres. Respectez le contexte de la source et n'utilisez pas la recherche comme une autorisation de promouvoir.
- Exécutez la même petite requête séparément dans chaque communauté choisie. Gardez les plafonds, le tri, la fenêtre et les heures d'observation comparables. Enregistrez les subreddits demandés et appariés pour examiner tout résultat hors périmètre.
- Examinez les publications renvoyées pour identifier la situation décrite, par exemple un débutant, un utilisateur expérimenté, un administrateur ou une affirmation de fournisseur. Conservez l'incertitude au lieu de deviner l'identité à partir des noms d'utilisateur. Lisez assez de contexte pour savoir si le problème est vécu directement ou s'il s'agit d'un ouï-dire.
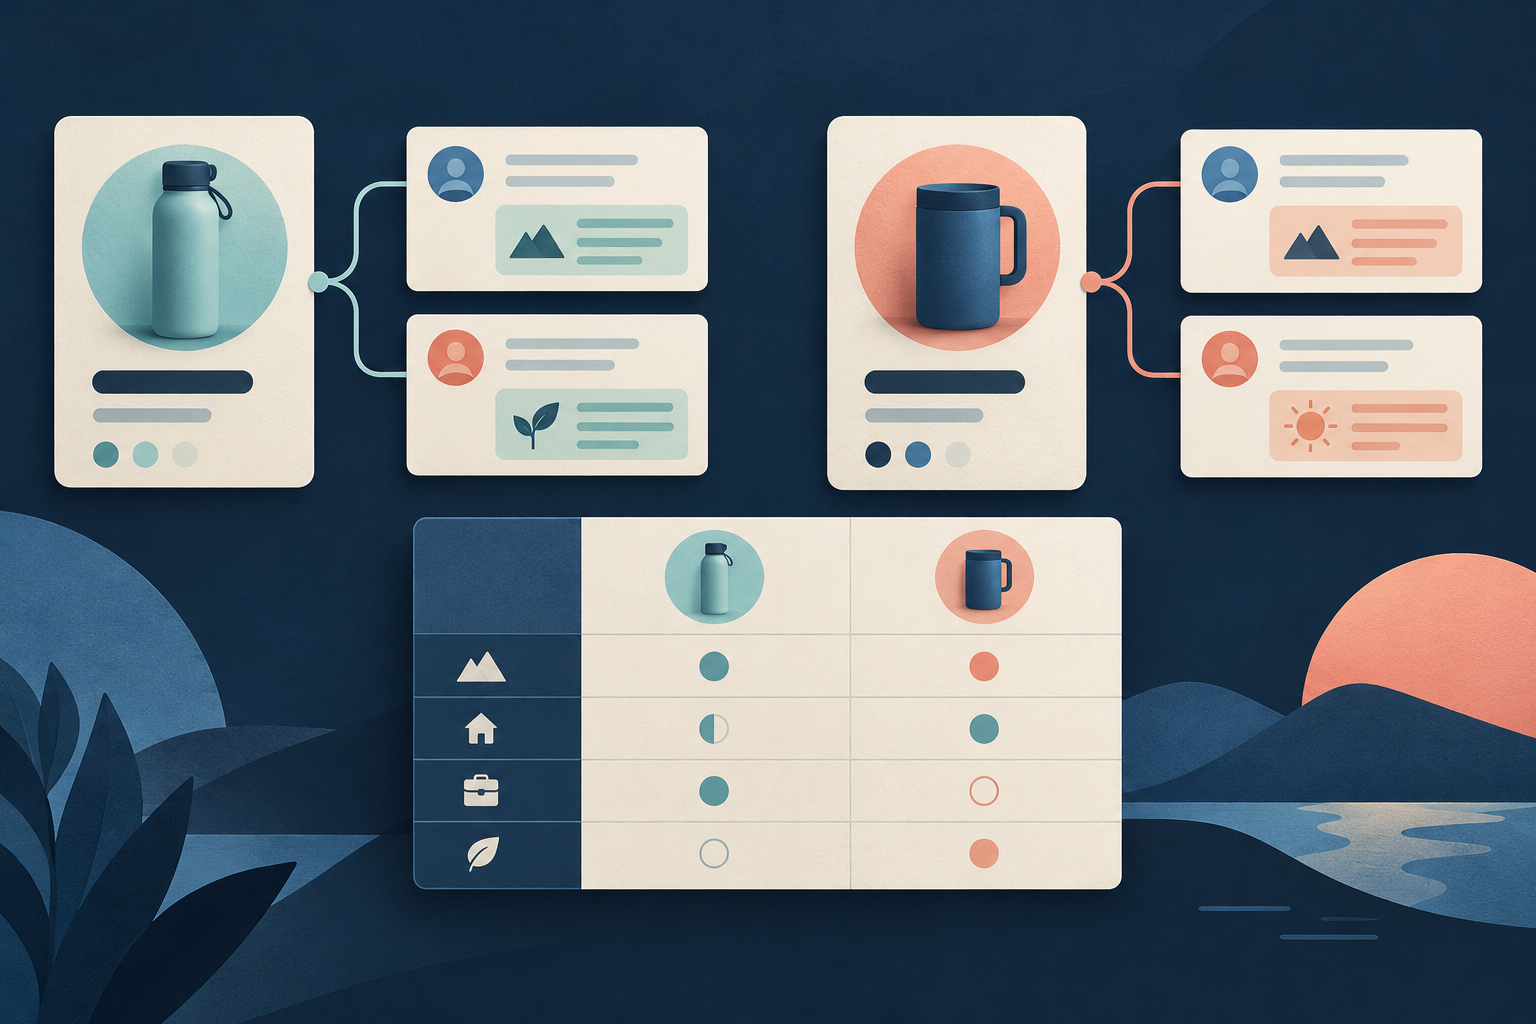
- Comparez la couverture par perspective pour voir quelles conditions de décision apparaissent et lesquelles manquent. Les dénombrements indiquent votre échantillon observé, mais ils ne peuvent pas vous dire à quel point un problème est courant sur l'ensemble du marché. Un résultat vide peut signifier une faible visibilité de la requête plutôt qu'une absence de besoin client.
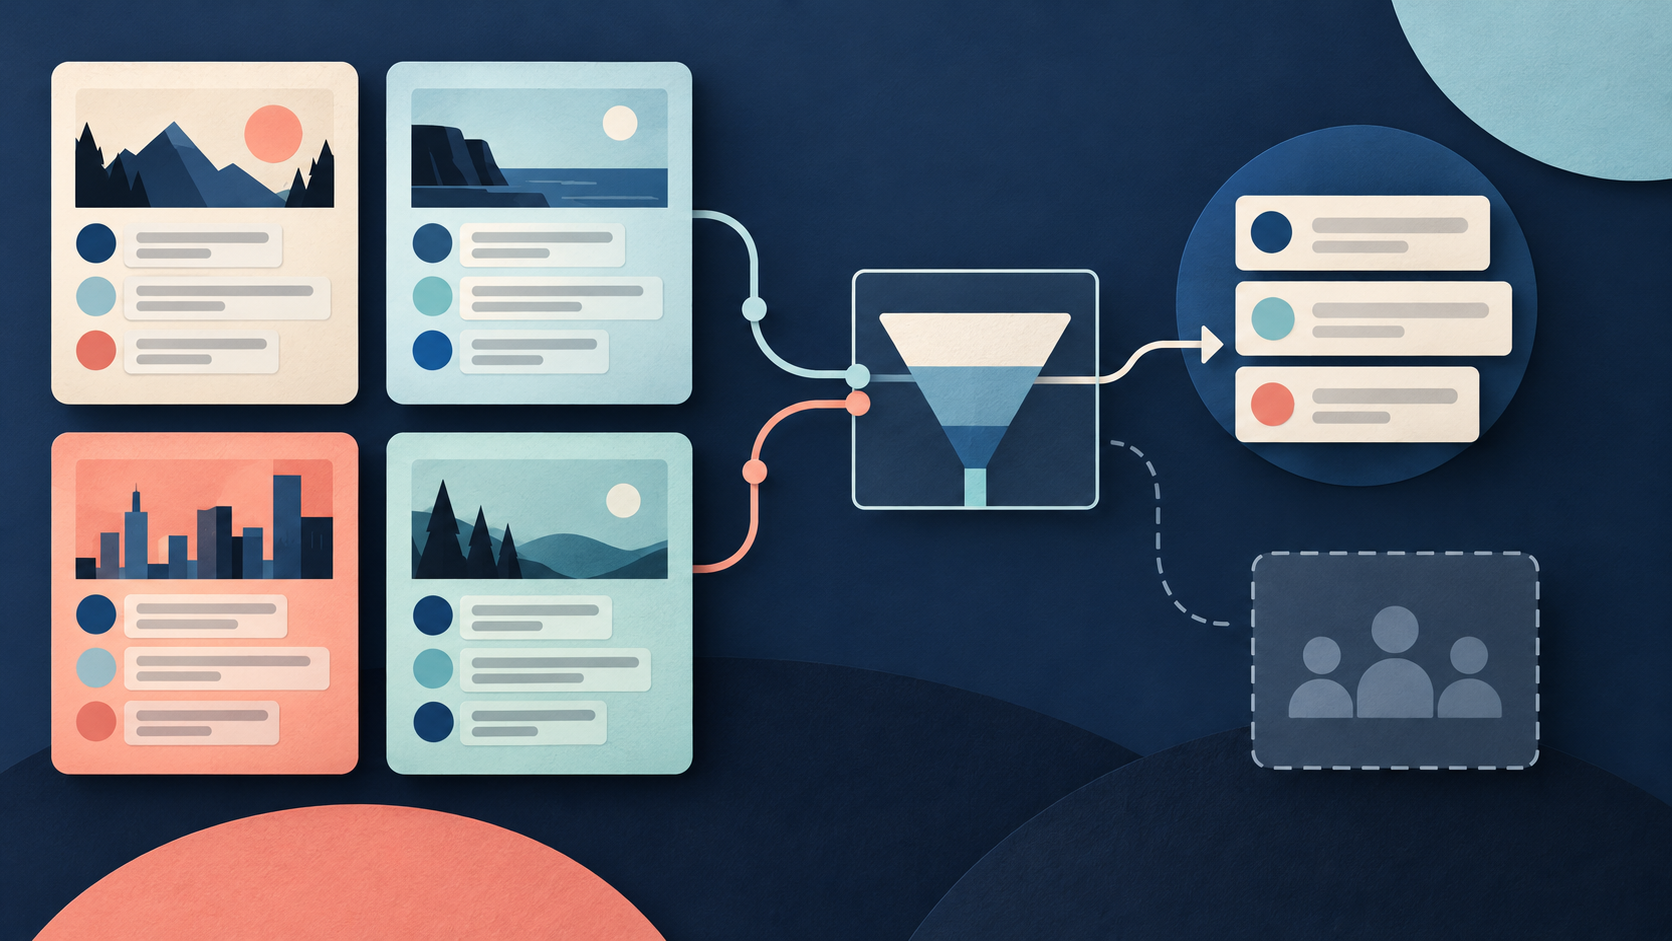
- Sélectionnez un cadre petit et varié, et documentez les voix manquantes. Ajoutez une autre source seulement lorsqu'elle apporte une nouvelle perspective. Évitez une collecte sans fin.
- Livrez un tableau de choix de sources, un manifeste des plafonds de requête et une liste des perspectives sans réponse. Le codage en aval et les choix de produit sont un travail distinct.
Exemple résolu fictif
Tous les noms de communautés, les publications et les situations client sont inventés. Imaginez une question de recherche sur la façon dont les petites équipes choisissent un flux de travail de sauvegarde. Quatre sources candidates sont testées au moyen d'exécutions séparées, avec de petits plafonds et des paramètres de tri et de période :
- BeginnerFiles : trois publications examinées ; deux montrent une confusion de configuration vécue directement et une est sans rapport. Le rôle de source est la configuration débutant ; incluez cette source pour les problèmes de prise en main.
- AdminPractice : trois publications ; deux portent sur des discussions de reprise et de test, et une est une annonce de fournisseur. Le rôle de source est la perspective de praticiens expérimentés des opérations ; incluez cette source pour les conditions de défaillance et de reprise.
- ToolQSupport : trois publications ; deux décrivent des erreurs d'outil précises et une a un corps manquant. Le rôle de source est le dépannage du produit actuel ; n'incluez cette source que dans un périmètre limité et conservez une ligne non examinée.
- FounderChat : trois publications ; une montre une contrainte de budget et deux sont des affirmations promotionnelles. Le rôle de source est le contexte budgétaire ; conservez cette source comme source complémentaire, pas comme source principale pour la fiabilité technique.
Ces collectes produisent douze publications collectées au total. Elles comprennent sept lignes de situation vécues directement et pertinentes (deux de BeginnerFiles, deux d'AdminPractice, deux de ToolQSupport et une de FounderChat), quatre lignes exclues (une, une, zéro et deux) et une ligne non examinée.
Sept publications pertinentes ne correspondent pas à sept clients distincts, car des auteurs répétés ou des publications croisées peuvent exister. Aucune taille relative de population ne découle de ces petits échantillons de trois lignes.
Le cadre terminé sélectionne BeginnerFiles, AdminPractice et ToolQSupport comme sources principales complémentaires, et FounderChat comme contexte budgétaire facultatif. Les voix manquantes comprennent les équipes qui ne publient pas publiquement et les propriétaires qui ont réussi une reprise sans demander d'aide. Si vous changez la requête pour FounderChat, marquez-la comme un échantillon complémentaire distinct plutôt que de combiner son taux avec la comparaison d'origine à requête fixe.
| Communauté | Objectif | Raison d'inclusion | Raison d'exclusion | Périmètre de la requête | Inconnues |
|---|---|---|---|---|---|
| BeginnerFiles | Configuration débutant | Saisir les problèmes de prise en main | Publications sans rapport | Requête fixe, plafond 3, fenêtre d'un an | Nombre réel de débutants |
| AdminPractice | Opérations | Couvrir les conditions de reprise | Annonces de fournisseurs | Requête fixe, plafond 3, fenêtre d'un an | Fréquence des défaillances |
| ToolQSupport | Dépannage | Suivre les erreurs d'outil | Aucune (la publication au corps manquant est non examinée) | Requête fixe, plafond 3, fenêtre d'un an | Taux d'erreur non examiné |
| FounderChat | Contexte budgétaire | Voir les contraintes de coût | Affirmations promotionnelles | Requête fixe, plafond 3, fenêtre d'un an | Budget total des acheteurs |
Sources et lectures complémentaires
Par Chronometrica · Mis à jour
Retour en haut ↑