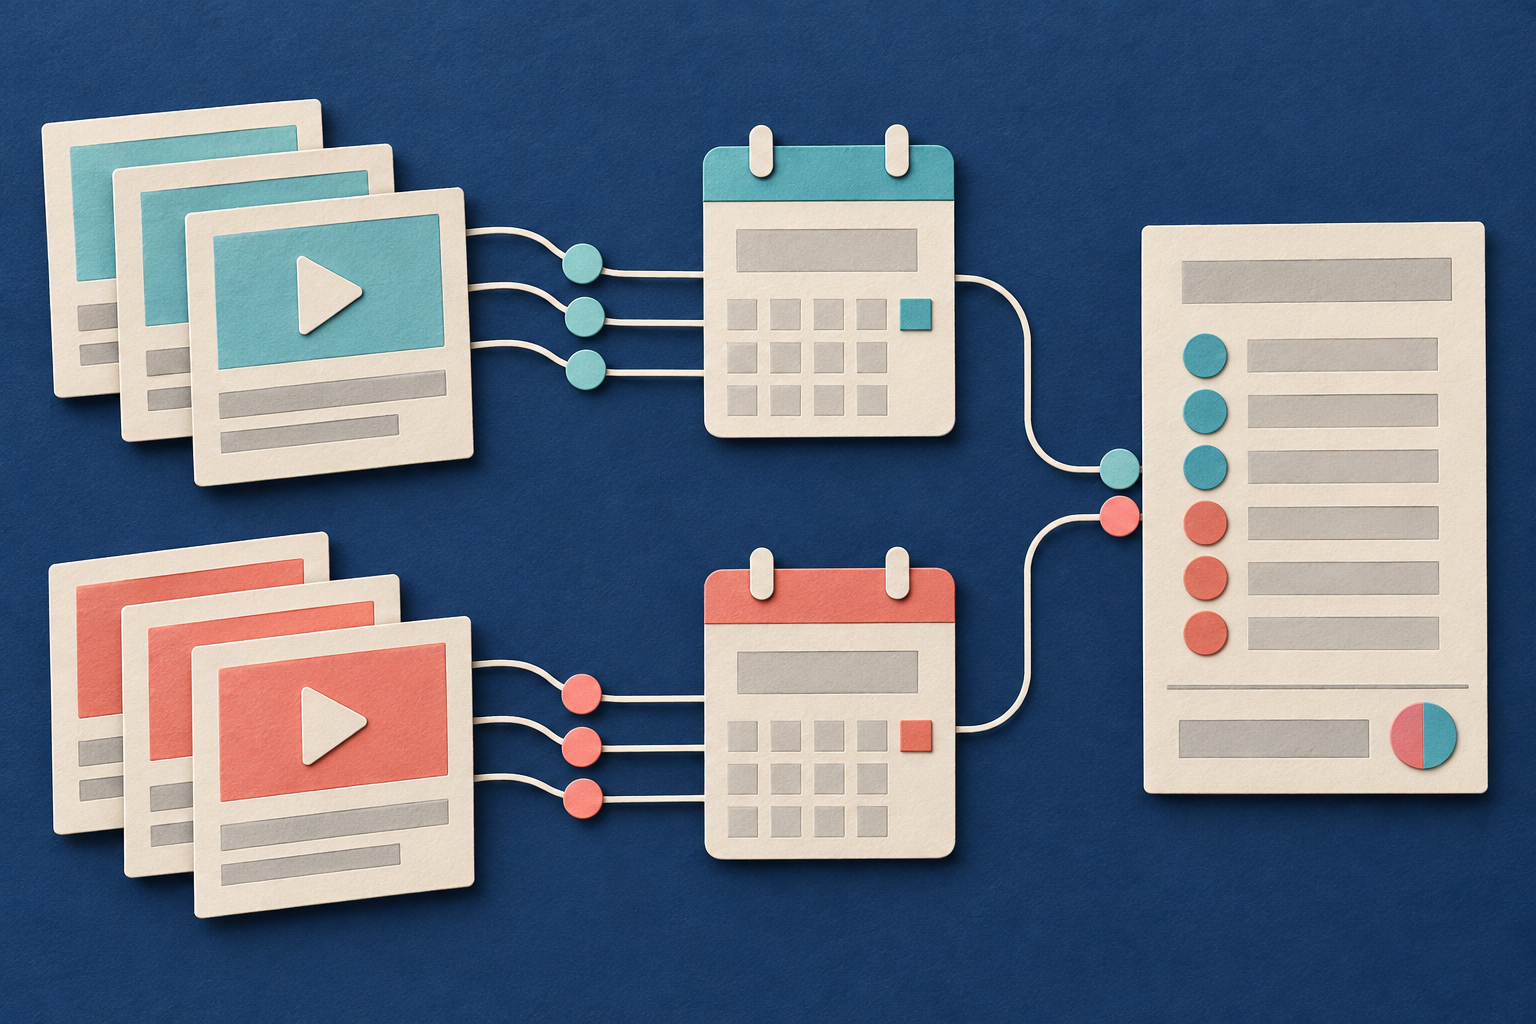
Una instantánea es una lectura guardada en un momento de recopilación. Una observación es el registro almacenado de esa lectura. Esta guía propone un método de importación para desarrolladores que ya recopilan métricas públicas de Instagram. El método conserva el historial e impide que una importación repetida se convierta en una falsa comprobación adicional.
El programa de recopilación proporciona las filas de origen. Tu proceso de importación debe aportar las claves estables, las reglas de almacenamiento y las comprobaciones de reinicio que se describen a continuación. No se realizó ninguna ejecución de recopilación ni prueba de importación para este artículo.
Define qué significa cada fila guardada
Un lector preguntó públicamente por la posibilidad de «analizar el rendimiento de las publicaciones cada 24 horas para crear una curva similar a la de los nuevos indicadores de Instagram». Esa formulación señala una necesidad de mediciones periódicas. No especifica cómo diseñar los reintentos. El método de importación segura que se presenta aquí es una ampliación de diseño propuesta. Pregunta del lector, observada el 12 de agosto de 2026; fecha de publicación no disponible y sin uso verificado del producto.
Una programación diaria no basta para obtener un historial fiable. También debes distinguir dos sucesos:
- Una nueva recopilación: el programa vuelve a comprobar la publicación. Guarda una observación nueva.
- Una importación repetida: tu aplicación lee una fila que ya guardó. Conserva la observación existente.
Estos sucesos pueden contener recuentos idénticos. Dos comprobaciones que indican 100 visualizaciones cada una siguen siendo dos observaciones. Leer dos veces una misma fila recopilada sigue siendo una sola observación.
Distingue los recuentos de las personas. Un recuento público de visualizaciones no es un recuento de personas únicas. Mantén `views`, `plays` y `playsInstagram` como campos separados. No los sumes ni sustituyas uno por otro sin una regla definida para los informes.
Este método se aplica a recuentos públicos. No obtiene las estadísticas privadas de la cuenta, Insights, ni recupera recuentos anteriores que no hayas guardado. Los registros exclusivos del propietario requieren otra fuente autorizada. El contrato público revisado permite recopilar métricas públicas actuales, pero no recuperar recuentos históricos. Contrato de Instagram Metrics Scraper, revisado el 25 de octubre de 2026; solo inspección de la compilación pública, sin ejecución de pago.
Si aún debes elegir entre buscar publicaciones recientes y comprobar URL guardadas, consulta la guía de recopilación periódica de Instagram. Toma esa decisión antes de diseñar la importación.
Mantén una tabla de observaciones y un comprobante de importación
Usa dos registros con funciones distintas. La tabla de observaciones contiene las lecturas recopiladas. El comprobante de importación registra cómo procesó tu aplicación una ejecución de origen.
Una ejecución es una puesta en marcha del programa de recopilación. Un conjunto de datos es la lista almacenada de filas que devuelve ese programa. Conserva ambos identificadores para poder rastrear una observación guardada hasta su origen.
Los siguientes nombres son campos de almacenamiento propuestos. Los campos como `run_id` e `item_position` son metadatos de tu flujo de trabajo: información sobre la recopilación y la importación. No son campos nuevos de salida del Actor. Un Actor es un programa de recopilación alojado en un servicio.
| Campo guardado | Qué conservar | Finalidad |
|---|---|---|
| `observation_key` | Clave única de la fila de origen | Evitar una inserción repetida |
| `run_id` | Identificador de la ejecución de origen finalizada, como texto | Identificar la ejecución de recopilación |
| `dataset_id` | Identificador del conjunto de datos de origen, como texto | Identificar la lista de origen |
| `item_position` | Posición absoluta original de la fila | Identificar la fila antes de los cambios |
| `postId` | Identificador original de la publicación, como texto | Relacionar el mismo contenido entre ejecuciones |
| `postUrl` | URL original del contenido | Conservar la referencia al contenido |
| `scrapedAt` | Fecha y hora originales de recopilación | Situar la lectura en el historial |
| Contadores | Cada contador devuelto por separado | Conservar el significado de la métrica |
| Campos de estado | Estado original de la métrica y de la fila | Explicar los valores ausentes o no utilizables |
| `original_json` | Fila original completa | Conservar la evidencia de origen |
| `imported_at` | Fecha y hora en que tu aplicación guardó la fila | Registrar el trabajo de importación por separado |
JSON es un formato de texto para datos estructurados. Guarda el JSON original antes de cambiar nombres de campos, eliminar campos o convertir una fila de origen en varios registros.
Conserva `postMetricStatus`, `status` y `statusReason` cuando se proporcionen. Conserva los demás campos de estado devueltos en el JSON original. No inventes valores de estado ni supongas una estructura de estados que no esté documentada. El contrato de salida revisado incluye la identidad del contenido, los recuentos, la fecha y hora de recopilación y los campos de estado. Compilación pública predeterminada, revisada el 25 de octubre de 2026; solo campos documentados, sin pruebas de ejecución.
Para cada intento de importación, guarda un comprobante con estos datos:
- Identificador de ejecución, identificador del conjunto de datos y estado de finalización del origen.
- Ajustes de exportación fijos y rango de filas de origen que se importa.
- Filas aceptadas, filas repetidas y filas rechazadas.
- Última posición de origen procesada de forma duradera.
- Fecha y hora de inicio y fin de la importación, y estado de finalización.
- Motivos de rechazo de las filas.
«Aceptada» significa que se guardó una observación nueva. «Repetida» significa que esa misma observación de origen ya estaba guardada. «Rechazada» significa que la fila necesita una corrección o revisión según las reglas que hayas establecido.
Mantén separados los recuentos de cada intento de importación. Sumar los comprobantes de varios reintentos no da el número de observaciones distintas.
Elige la clave de observación antes de cargar las filas
Una clave es un valor que identifica un registro. Tu clave de observación debe identificar la fila de origen, no solo la publicación de Instagram.
Usar solo `postId` fusionaría todas las comprobaciones posteriores de esa publicación. Usar la fecha y hora de importación crearía una observación nueva en cada reintento. El texto de una publicación o su posición en la lista del perfil de un creador tampoco identifica una observación recopilada.
Para un conjunto de datos estable y finalizado, usa el identificador de ejecución y la posición original del elemento en el conjunto de datos. Conserva el identificador del conjunto de datos junto con esa clave. Una regla práctica de almacenamiento exige que la combinación de identificador de ejecución, identificador del conjunto de datos y posición del elemento sea única.
Una regla de unicidad impide que la tabla acepte dos registros con la misma combinación. Aplícala en el sistema de almacenamiento. No dependas solo de una comprobación en el código de la aplicación antes de insertar el registro.
Sigue estos pasos:
- Selecciona una ejecución de origen finalizada cuando tu regla de informes requiera datos estables y finalizados.
- Guarda su identificador de ejecución y su identificador del conjunto de datos.
- Fija los ajustes de exportación de datos sin transformar y el orden ascendente del origen.
- Registra el rango de origen que vas a importar.
- Asigna las posiciones absolutas originales antes de ordenar, filtrar o convertir las filas en varios registros.
- Mantén esas posiciones sin cambios en cada reintento.
La posición absoluta es la posición en la lista de origen completa. Si una página contiene las posiciones de 0 a 99, la siguiente empieza en 100. No vuelve a empezar en 0. Indica si tus posiciones empiezan en 0 o en 1.
Apify documenta que el almacenamiento de conjuntos de datos solo permite añadir elementos: se pueden añadir elementos, pero no modificar ni eliminar los existentes. Esto ayuda a conservar las filas de origen. Por sí solo, no convierte una exportación filtrada o reordenada en una identidad segura para importar. Documentación de conjuntos de datos de Apify, revisada el 25 de octubre de 2026; información sobre almacenamiento que solo permite añadir elementos y sobre recuperación de datos, sin garantía de importación.
Si no puedes conservar posiciones de origen estables, usa un hash documentado de una representación fija de la fila original. Un hash es un identificador calculado a partir del contenido. Usa los mismos campos, representación textual y cálculo en cada reintento. Conserva también las referencias a la ejecución y al conjunto de datos.
Esta alternativa requiere cuidado. Las filas idénticas pueden producir el mismo hash, aunque ocupen posiciones de origen distintas. Define si esas filas representan una observación o dos antes de usar este método. Da preferencia a las posiciones de origen estables cuando debas conservar cada fila devuelta.
Si una clave existente apunta a un contenido original distinto, detén la importación y revisa el conflicto. No sobrescribas la observación guardada sin avisar ni lo clasifiques como una repetición normal.
Guarda las filas y el progreso como una sola operación
El principal riesgo al reiniciar aparece entre guardar una fila y guardar el progreso. Tu aplicación puede detenerse después de completar una de esas acciones y antes de completar la otra.
Una transacción guarda los cambios relacionados como una sola operación. Si tu herramienta de almacenamiento admite transacciones, confirma juntas las observaciones aceptadas y su posición de progreso. Mantén los cambios del comprobante relacionado en consonancia con esa confirmación.
Usa esta secuencia de importación:
- Lee las siguientes filas de origen con sus posiciones originales.
- Comprueba cada fila según tus reglas de aceptación.
- Genera su clave de observación.
- Inserta una observación nueva cuando la clave no exista.
- Cuenta como repetición una observación existente que coincida.
- Registra las filas rechazadas y sus motivos.
- Guarda el progreso solo cuando las filas y los registros de rechazo estén guardados de forma duradera.
«Duradero» significa que el sistema de almacenamiento ha guardado el cambio de modo que se conserve después de detenerse el proceso de importación.
La ausencia de un contador no debe ser, por sí sola, motivo para rechazar una fila de origen válida en los demás aspectos. La fila aún puede registrar un intento de recopilación y otros recuentos disponibles. Conserva la ausencia del valor y su estado.
Conserva suficiente información de origen para revisar las filas rechazadas. Una posición de progreso posterior a una fila rechazada no debe ocultar esa fila. Guarda su registro de rechazo antes de avanzar el progreso, o detente en esa posición hasta resolver el problema.
Si tu herramienta de almacenamiento no puede confirmar juntas las filas y el progreso, guarda las filas antes de avanzar el progreso. Tras una interrupción, vuelve a procesar cualquier rango dudoso con la misma clave única. Esto puede producir repeticiones, pero no debe producir observaciones adicionales.
No crees un nuevo valor de `scrapedAt` al volver a procesar los datos. `imported_at` puede cambiar entre intentos. La fecha y hora de recopilación no pueden cambiar.
Sigue una importación y un reinicio paso a paso
El siguiente ejemplo es una ficción original. No es una salida del Actor, un resultado de un cliente ni un resultado de una prueba. Todas las horas corresponden al mismo día ficticio en UTC, una referencia horaria común.
La ejecución A contiene dos filas. En este ejemplo, las posiciones de origen empiezan en 0.
| Ejecución | Posición original | Publicación | Hora de recopilación | Visualizaciones |
|---|---|---|---|---|
| A | 0 | P1 | 10:00 UTC | 100 |
| A | 1 | P2 | 10:01 UTC | Sin dato |
| B | 0 | P1 | 11:00 UTC | 120 |
Primero, importa la ejecución A. La tabla guarda P1 y P2 como dos observaciones. P2 no tiene un recuento de visualizaciones disponible. Se conserva como una observación guardada sin dato de visualizaciones.
Ahora vuelve a importar la ejecución A. Las dos claves de fila de origen ya existen. La importación no añade observaciones e informa de dos repeticiones.
Después, importa la ejecución B. Su fila de P1 tiene una identidad de ejecución distinta. Guárdala como una observación nueva, aunque P1 ya exista en la tabla.
| Intento de importación | Observaciones nuevas | Filas repetidas | Total de observaciones guardadas |
|---|---|---|---|
| Primera importación de A | 2 | 0 | 2 |
| Importación repetida de A | 0 | 2 | 2 |
| Primera importación de B | 1 | 0 | 3 |
El cálculo es el siguiente:
- Primera importación: 0 observaciones + 2 observaciones nuevas = 2 observaciones.
- Importación repetida: 2 observaciones + 0 observaciones nuevas = 2 observaciones.
- Nueva ejecución: 2 observaciones + 1 observación nueva = 3 observaciones.
Hay tres observaciones de dos ejecuciones. A lo largo de los tres intentos se procesan filas cinco veces, pero eso no representa cinco observaciones. P2 sigue sin dato. No pasa a tener un valor de cero.
Considera ahora un caso alternativo de reinicio dentro de esta misma ficción original. La primera importación de A se detiene después de guardar P1. Todavía no ha guardado P2.
Si el progreso guardado es fiable, reinicia en P2. Ese reinicio añade una observación. La tabla termina con dos observaciones de A.
Si el progreso es dudoso, vuelve a importar A desde el principio. P1 cuenta como una repetición y P2 como una observación nueva. La tabla sigue terminando con dos observaciones de A.
Tras importar B, cualquiera de las dos formas de reinicio produce las mismas tres observaciones guardadas. Este es el resultado que debe verificar tu comprobación del reintento.
Crea la vista más reciente sin cambiar el historial
Una vista es un resultado elaborado a partir de registros guardados. Crea una vista de las lecturas más recientes en lugar de sustituir las observaciones antiguas.
Ordena las observaciones con fechas y horas válidas según `scrapedAt`, no según el momento de importación. Importar hoy la ejecución finalizada de ayer no debe hacer que el recuento de ayer parezca más reciente que una lectura recopilada hoy.
Muestra por separado dos datos de cada publicación:
- El intento de recopilación guardado más reciente.
- La lectura utilizable más reciente de cada contador necesario, con su fecha y hora originales.
Una fila más reciente puede carecer de visualizaciones mientras que una anterior tiene un valor utilizable. Puedes conservar el valor anterior como referencia, pero muestra su fecha y hora anteriores y el resultado más reciente sin dato. No muestres el valor anterior como una medición nueva.
La lectura «utilizable más reciente» puede variar según el contador. La fila más reciente con un recuento utilizable de Me gusta puede ser distinta de la fila más reciente con un recuento utilizable de visualizaciones. Mantén sus fechas y horas separadas.
Documenta estos casos de ordenación antes de publicar la aplicación:
- Fechas y horas de recopilación iguales: conserva ambas observaciones de origen. Muestra que coinciden en el tiempo o aplica una regla de visualización explícita. Una regla de visualización no demuestra qué lectura ocurrió después.
- Fecha y hora de recopilación ausentes: conserva la fila de origen, pero exclúyela de la ordenación temporal hasta que se revise.
- Fecha y hora de recopilación no válidas: registra el problema. No las sustituyas por la fecha y hora de importación sin indicarlo claramente.
- Ninguna fila devuelta: registra por separado la falta de datos en la recopilación. No inventes una observación ni un recuento de cero.
Para los cálculos posteriores, usa la guía de informes mensuales de Instagram. Este método de importación conserva las observaciones; no proporciona las lecturas que falten en los límites del mes. La guía del historial de métricas también explica por qué importan las fechas y horas reales de observación cuando hay intervalos sin comprobaciones.
Usa una entrada de recopilación pequeña y comprueba después la importación
Instagram Metrics Scraper de Chronometrica documenta las entradas directas de contenido y los campos necesarios para este método de almacenamiento propuesto. Su idoneidad documentada no significa que cree tu tabla de historial ni que haga cumplir tus claves de importación.
Una Task es una configuración de entrada guardada para un Actor. La Task pública Instagram Post Metrics Tracker ofrece un punto de partida. La revisión de la página aportada solo confirmó su presencia pública. No verificó los ajustes guardados mediante acceso autenticado ni ejecutó la configuración. Instagram Post Metrics Tracker, revisado el 25 de octubre de 2026; solo presencia de la página pública, sin comprobación autenticada de la entrada ni ejecución de pago.
Usa esta pequeña entrada proporcionada:
{"maxItems":1,"mode":"contentUrls","startUrls":["https://www.instagram.com/reel/DIwcCZgxVZP/"]}`mode` selecciona cómo gestiona el Actor las entradas. `contentUrls` selecciona las comprobaciones directas de contenido. `startUrls` contiene las URL del contenido previsto. `maxItems` limita el número de filas de métricas devueltas.
Sustituye la URL de ejemplo por la URL conocida de una publicación pública o de un Reel público. Un Reel es un formato de vídeo de Instagram. Sustituye la lista de ejemplo en vez de añadir tu URL junto a ella. Revisa los ajustes guardados antes de usarlos.
Esta entrada superó una comprobación estática del esquema. Esa comprobación verifica la estructura de la entrada frente al esquema público proporcionado. No confirma la disponibilidad actual del contenido ni que la recopilación tenga éxito. Esquema público de entrada, revisado el 25 de octubre de 2026; solo validación estática, sin ejecución de pago.
Se proponen las siguientes comprobaciones para el lector:
- Recopila un elemento público previsto y conserva las referencias a la ejecución finalizada y al conjunto de datos.
- Importa sus filas y registra los recuentos de filas aceptadas, repetidas y rechazadas.
- Vuelve a importar el mismo origen. Confirma que hay cero observaciones nuevas.
- Detén una importación antes de que termine y reiníciala. Confirma que las claves finales de las filas de origen coinciden con las de una importación completa.
- Realiza una nueva ejecución de recopilación para el mismo elemento. Confirma que crea una observación nueva.
- Confirma que todos los valores guardados de `scrapedAt` coinciden con los de sus filas de origen.
- Confirma que los contadores ausentes siguen ausentes y que los recuentos utilizables anteriores conservan sus fechas y horas originales.
Una ejecución finalizada no demuestra que cada elemento solicitado tenga un contador utilizable. Compara la lista de contenido previsto con las filas devueltas y registra las faltas de datos por separado.
Fuentes y lecturas adicionales
- Contrato público de Instagram Metrics Scraper, revisado el 25 de octubre de 2026; entradas y salidas públicas documentadas, sin ejecución de pago ni prueba del estado operativo actual
- Compilación pública predeterminada 1.0.35, revisada el 25 de octubre de 2026; evidencia del esquema y de los campos documentados, sin medición del comportamiento durante la ejecución
- Documentación de conjuntos de datos de Apify, revisada el 25 de octubre de 2026; evidencia sobre almacenamiento que solo permite añadir elementos y sobre recuperación de datos; una identidad estable para importar sigue requiriendo un orden de origen fijo
- Task Instagram Post Metrics Tracker, revisada el 25 de octubre de 2026; solo presencia pública de la configuración, sin verificación autenticada de los ajustes guardados ni ejecución de pago
- Pregunta sobre mediciones periódicas, observada el 12 de agosto de 2026; fecha de publicación no disponible; una sola pregunta pública, no evidencia de demanda ni de uso del producto
Por Chronometrica · Actualizado
Volver arriba ↑