Configuración de la recolección
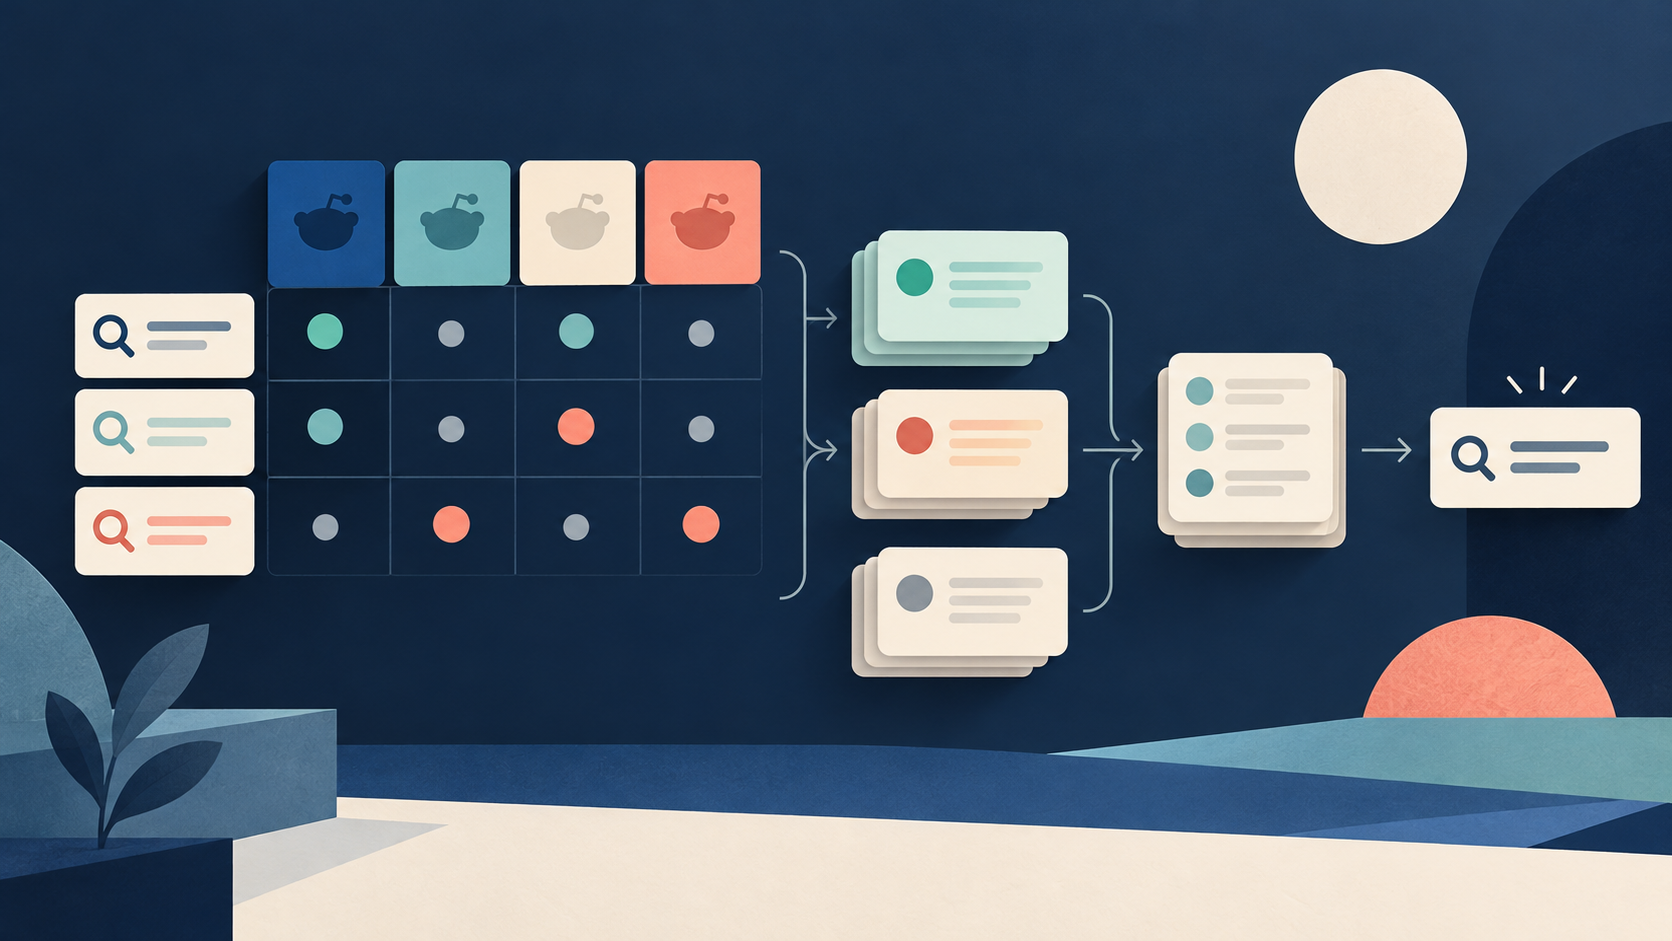
Empieza la configuración al vincular el Actor y la Task. El ajuste actual usa query "customer feedback", subreddits "SaaS", "Entrepreneur" y "smallbusiness", maxResults 150, sort "relevance" y time "year". Estos valores genéricos predeterminados no están demostrados como las mejores comunidades. Reemplázalos por fuentes candidatas justificadas.
Compara corridas separadas con la misma consulta, el mismo orden, el mismo período y un límite de 3 publicaciones por corrida. Una corrida mixta reparte maxResults entre todas las fuentes, y eso permite que una fuente grande consuma el límite pronto. Conserva los campos clave de salida: inputQuery, requestedSubreddit, matchedSubreddit, postId, canonicalPostUrl, title, body, createdAt, rank, status, unavailableFields y observedAt.
Una publicación sin contexto del cuerpo queda sin revisar. Un rango de fuente más bajo muestra el orden de la búsqueda, no la calidad de la publicación. Los identificadores de publicación representan publicaciones descubiertas, no clientes individuales.
Cada entrada de searchResults en la salida contiene query, subreddit, status, reason, candidatesFound, rowsSaved, duplicatesSkipped, endReason, source y sourceUrl. El resumen de la corrida incluye status, statusReason, isComplete, query, searchesPlanned, searchesSucceeded, candidatesFound, usefulRows, rowsSaved, duplicatesSkipped, stopReason y observedAt. Usa los diagnósticos de recolección que sean relevantes para tu auditoría y omite los campos internos de costo.
En una corrida de control reciente, searchResults[0] registró subreddit=learnpython, status=ok, rowsSaved=3, endReason=max_results_reached y source=reddit_rss. Un estado global de isComplete=true confirma un resultado de procesamiento terminado, no la cobertura de toda la población de la comunidad. Ten en cuenta que los campos de fila requestedSubreddit y matchedSubreddit pueden diferir del campo subreddit del resumen.
Arma un marco de fuentes paso a paso
- Nombra la situación del cliente, la decisión y la información necesaria. Separa, como roles de fuente, las comunidades de usuarios, las comunidades de profesionales en ejercicio, las comunidades de soporte del producto y los debates generales de personas fundadoras.
- Encuentra comunidades públicas candidatas a partir de debates reales sobre el tema. Lee su propósito, sus reglas y los hilos recientes relevantes. No infieras la condición de comprador solo a partir del nombre de una comunidad.
- Escribe un motivo de inclusión o de exclusión para cada comunidad. Elige fuentes por perspectivas distintas, no solo por una gran cantidad de miembros. Respeta el contexto de la fuente y no uses la investigación como permiso para promocionar.
- Ejecuta la misma consulta pequeña en cada comunidad elegida por separado. Mantén comparables los límites, el orden, la ventana y los tiempos de observación. Guarda los subreddits solicitados y los emparejados para revisar cualquier resultado fuera de alcance.
- Revisa las publicaciones devueltas para identificar la situación descrita, como un principiante, un usuario con experiencia, un administrador o una afirmación de un proveedor. Conserva la incertidumbre en lugar de adivinar la identidad a partir de los nombres de usuario. Lee contexto suficiente para saber si el problema es de primera mano o de oídas.
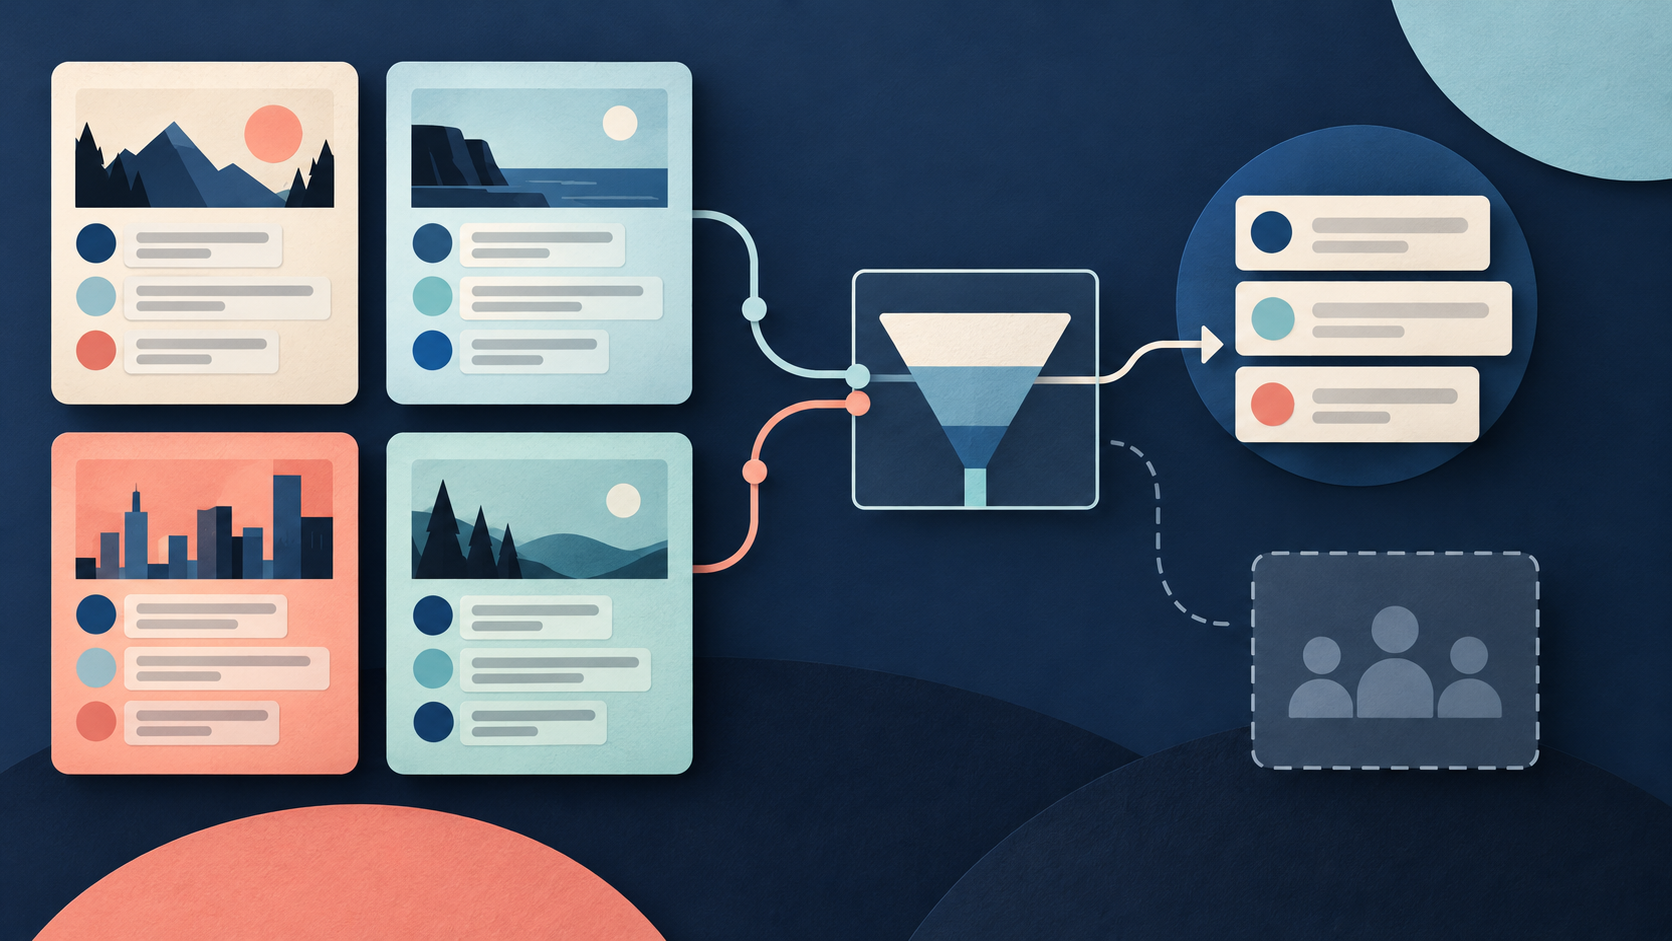
- Compara la cobertura por perspectiva para ver qué condiciones de la decisión aparecen y cuáles faltan. Los conteos muestran tu muestra observada, pero no pueden decirte qué tan común es un problema en todo el mercado. Un resultado vacío puede significar baja visibilidad de la consulta, y no una falta de necesidad del cliente.
- Selecciona un marco pequeño y variado, y documenta las voces ausentes. Agrega otra fuente solo cuando aporte una perspectiva nueva. Evita la recolección sin fin.
- Entrega una tabla de elección de fuentes, un manifiesto de la consulta y del límite, y una lista de perspectivas sin respuesta. La codificación posterior, entendida como clasificación de la investigación, y las decisiones de producto son un trabajo aparte.
Ejemplo resuelto ficticio
Todos los nombres de comunidades, las publicaciones y las situaciones de clientes son inventados. Imagina una pregunta de investigación sobre cómo los equipos pequeños eligen un flujo de trabajo de copias de respaldo. Se prueban 4 fuentes candidatas con corridas separadas y con límites pequeños y parámetros de orden y de tiempo:
- BeginnerFiles: 3 publicaciones revisadas; 2 muestran confusión de configuración de primera mano y 1 no está relacionada. El rol de fuente es la configuración de principiantes; incluye esta fuente por los problemas de incorporación.
- AdminPractice: 3 publicaciones; 2 tratan debates de recuperación y de pruebas, y 1 es un anuncio de un proveedor. El rol de fuente es operaciones con experiencia; incluye esta fuente por las condiciones de falla y de recuperación.
- ToolQSupport: 3 publicaciones; 2 describen errores específicos de la herramienta y 1 tiene el cuerpo ausente. El rol de fuente es la resolución de problemas del producto actual; incluye esta fuente de forma acotada y conserva 1 fila sin revisar.
- FounderChat: 3 publicaciones; 1 muestra una restricción de presupuesto y 2 son afirmaciones promocionales. El rol de fuente es el contexto de presupuesto; conserva esta fuente como fuente suplementaria, no como fuente principal de confiabilidad técnica.
Estas recolecciones dan 12 publicaciones recolectadas en total. Incluyen 7 filas de situación de primera mano y relevantes (2 de BeginnerFiles, 2 de AdminPractice, 2 de ToolQSupport y 1 de FounderChat), 4 filas excluidas (1, 1, 0 y 2) y 1 fila sin revisar.
7 publicaciones relevantes no equivalen a 7 clientes distintos, porque puede haber autores repetidos o publicaciones cruzadas. De estas muestras pequeñas de 3 filas no se sigue ningún tamaño relativo de la población.
El marco completado selecciona BeginnerFiles, AdminPractice y ToolQSupport como fuentes principales complementarias, y FounderChat como contexto opcional de presupuesto. Las voces ausentes incluyen equipos que no publican en espacios públicos y propietarios que se recuperaron con éxito sin pedir ayuda. Si cambias la consulta de FounderChat, márcala como una muestra suplementaria separada, en lugar de combinar su tasa con la comparación original de consulta fija.
| Comunidad | Propósito | Motivo de inclusión | Motivo de exclusión | Alcance de la consulta | Incógnitas |
|---|---|---|---|---|---|
| BeginnerFiles | Configuración de principiantes | Registrar problemas de incorporación | Publicaciones no relacionadas | Consulta fija, límite 3, ventana de un año | Cantidad real de principiantes |
| AdminPractice | Operaciones | Cubrir condiciones de recuperación | Anuncios de proveedores | Consulta fija, límite 3, ventana de un año | Frecuencia de las fallas |
| ToolQSupport | Resolución de problemas | Seguir errores de la herramienta | Ninguno (la publicación sin cuerpo queda sin revisar) | Consulta fija, límite 3, ventana de un año | Tasa de error sin revisar |
| FounderChat | Contexto de presupuesto | Ver restricciones de costo | Afirmaciones promocionales | Consulta fija, límite 3, ventana de un año | Presupuesto total de compradores |
Fuentes y lecturas adicionales
Por Chronometrica · Actualizado
Volver arriba ↑