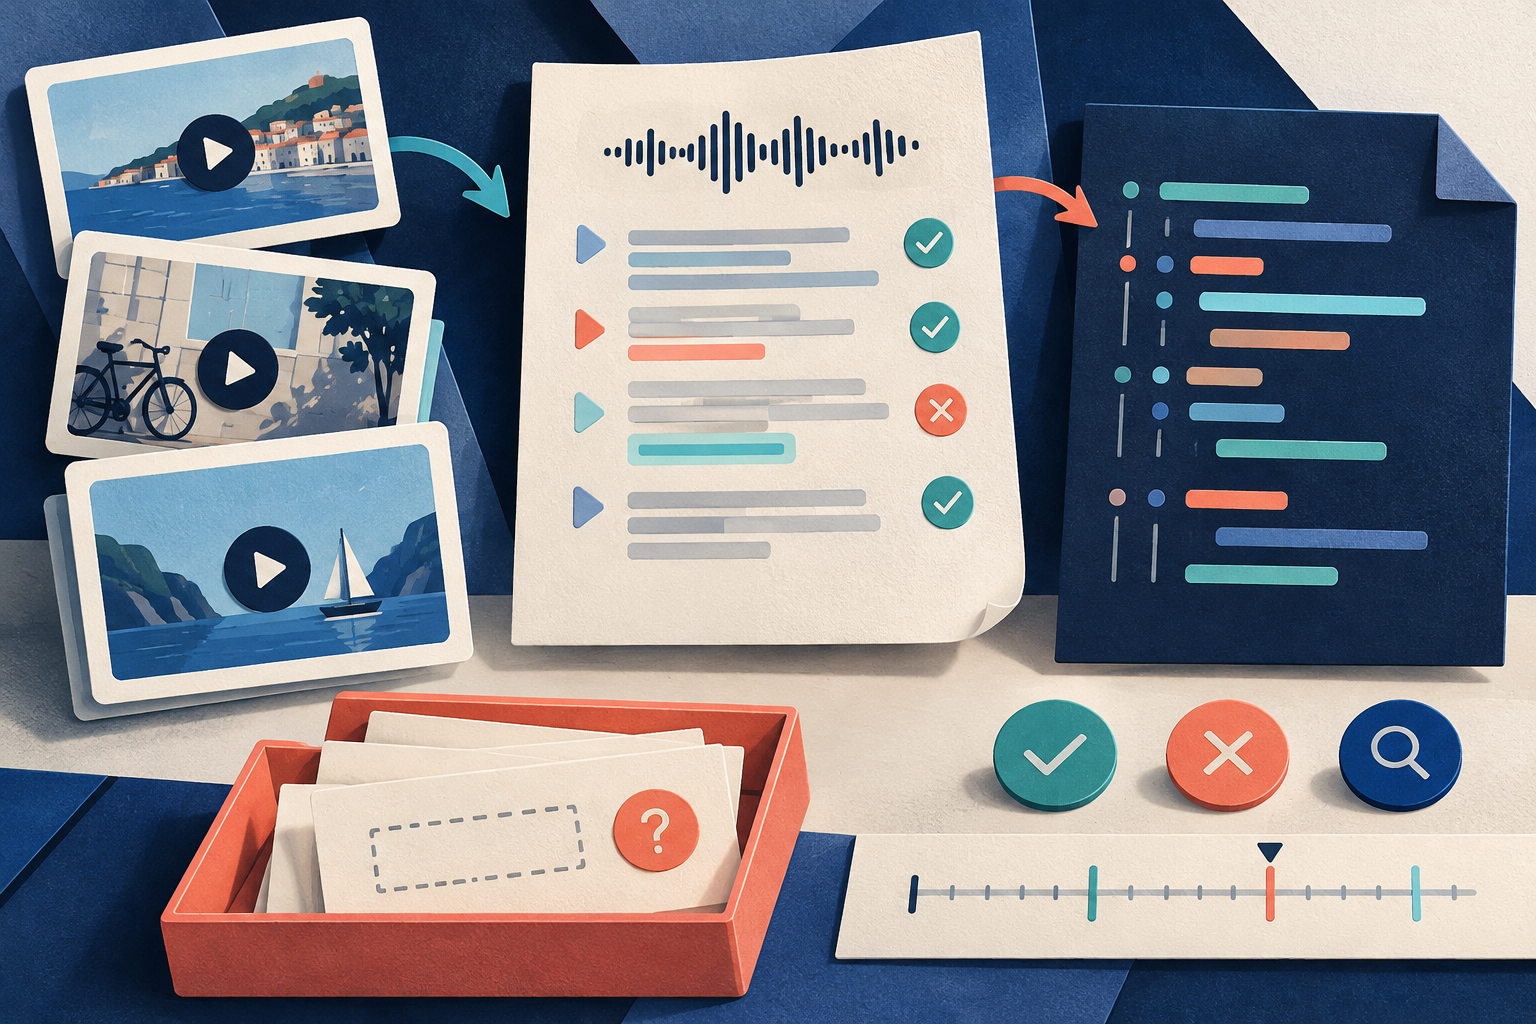
actor 是托管的数据采集程序,task 是已保存的输入预设。二元编码为每条视频赋值 0 或 1。
工具限制与原生字段
TikTok Transcript 当前公开构建 0.1.36 接受 startUrls,其中可包含 1 到 100 个已知的公开视频 URL、短链接或数字视频 ID。它不搜索主页、关键词或声音页面。preferredLanguages 按优先顺序选择已有的公开轨道,空列表则使用第一条公开轨道。它不翻译、不转写尚未采集的音频、不收集评论,也不推断内容编码。
数据集中每一行代表一条已提交的输入,包括不计费的状态结果。确切字段包括 inputIndex、inputUrl、videoId、videoUrl、authorHandle、durationSeconds、languageCode、text、含 startSeconds、endSeconds 与 text 的 segments、status、statusReason、isBillable 以及 scrapedAt。把视频 ID 保留为字符串。字幕语言可能使用地区值,例如 eng-US。失败状态下的 null 或空转写,并不能证明该视频没有语音。
状态包括 succeeded、no_public_captions、language_unavailable、duplicate_input、not_tiktok、invalid_input、unsupported_url、video_unavailable、not_public、blocked_or_challenged,以及提取失败或字幕失败。成功要求 text 非空。isBillable 为 true 表示一次成功的原生转写结果事件,但其他行仍然是证据。平台使用量与结果事件是分开的,因此不要把整次运行称为免费。OUTPUT 字段 inputsReceived、resultRows、billableTranscriptRows、nonBillableResultRows、duplicateVideosSkipped 与 statusCounts 是运行记账,不是样本代表性。
当前的单视频英语对照已成功:视频 ID 恰好是所请求的 ID,text 非空,并且有十二条 segments,其时间结构符合已核对的形式。这只证明该来源上存在一条公开字幕路径,不能证明全部视频都如此、转写与实际说出的词完全一致,或编码效度。把整个样本列表替换为一条预定的已知视频。仅在英语研究中把 preferredLanguages 设为 `["en"]`,否则留空以使用第一条公开轨道。
为缺失数据划定界限的八个步骤
- 从选定视频台账开始,包含每一条预定的已知视频。对已知视频 ID 去重,但不要丢弃输入结果的证据。计算之前声明目标总体,并为每条视频声明一个二元内容编码。
- 保持这些结果彼此区分:已验证的合格字幕、字幕不存在、所请求的语言不可用、暂时性失败或来源访问失败、不支持的输入、重复,以及验证未解决。来源失败并不是该视频没有字幕的证据。按已声明的规则排除确实无效或超出范围的输入;不要把它们混入范围内的缺失结果。
- 把 N 定义为合格的已选不重复视频数,K 定义为其中已有经核实编码结果的视频数,P 定义为经核实的正编码数,M 定义为合格的未知结果数,等于 N 减 K。核对这些数字。把失败或空字幕当作未知编码,而不是负编码。验证错误也可以使结果成为未知。
- 仅当 K 大于 0 时,报告观察到的成功子集分数,即 P 除以 K。并按此标注。仅当 N 大于 0 时,报告缺失分数,即 M 除以 N。这是不同的分母。如果没有任何结果经过核实,不要除以 0,也不要提出关于内容的主张。
- 为选定的合格样本计算不预设缺失机制的二元界限:下限 P/N 假设每个未知都是编码 0,上限 (P+M)/N 假设每个未知都是编码 1。说明这些是这个选定样本的逻辑范围,不是置信区间、某一结果或主张为真的概率,也不是对全部 TikTok 的估计。置信区间在某一模型下描述抽样不确定性;这个区间描述的是未知结果。
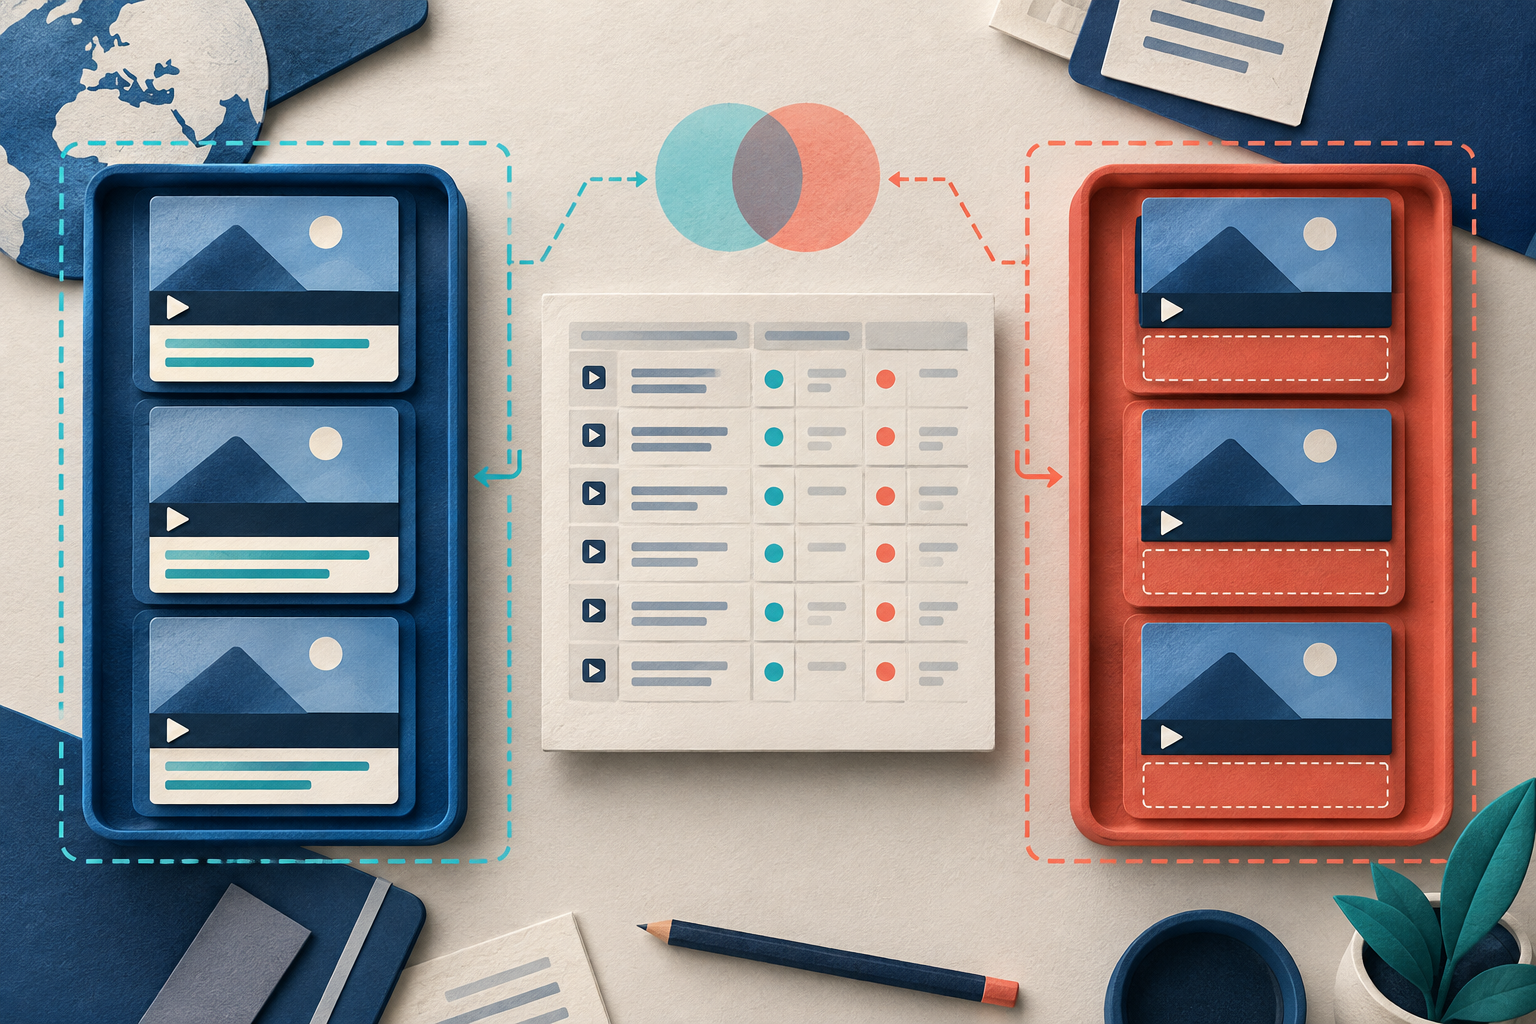
- 对于计划中的组间比较,用同一方法为每一组分别计算各自的台账计数和界限。如果范围重叠,缺失结果可能颠倒或消除表面上的次序;仅有重叠并不是统计显著性检验。记录在所有允许赋值下仍然成立的主张,并与依赖假设才成立的主张分开。
- 如果这些来源属性已知,按已声明的语言、创作者或时期检查可得性。差异是描述性信号,不是某种机制的证明。在范围受到限定的流程下修正无效输入,并检查来源失败。不要在未改变并记录测量方法的情况下,用翻译文本或生成文本替换不可得的视频内容。
- 在得到支持的范围内陈述研究结论。如果界限对这项研究决策来说过宽,应寻求已验证的结果,或收窄问题。不要只选取容易成功取得字幕的视频,从而在不加说明的情况下扩大数据集。
原创虚构演算示例
下面所有示例都使用原创虚构数据,并非来自真实的 TikTok 来源。
一项虚构研究选定二十条合格的不重复视频。十二条有已验证的编码结果,其中七条为正。八条结果因彼此不同的字幕、访问或验证原因仍为未知。
观察到的分数是 7/12=58.3%。缺失分数是 8/20=40%。选定样本界限是 7/20=35% 与 (7+8)/20=75%。因此,35% 到 75% 是未知结果可任意取值时的逻辑编码比例范围,不是估计出来的准确度区间。不要把 58.3% 报告为已核实的整个选定样本比例。
虚构台账与分组界限
| 组别 | 选定 N | 已知 K | 正例 P | 未知 M | 已知分数 | 下限 | 上限 |
|---|---|---|---|---|---|---|---|
| 组 A | 10 | 8 | 5 | 2 | 62.5% | 50% | 70% |
| 组 B | 10 | 4 | 2 | 6 | 50.0% | 20% | 80% |
| 合计 | 20 | 12 | 7 | 8 | 58.3% | 35% | 75% |
只根据已知结果得出的“组 A 大于组 B”这一次序并不稳健。把组 A 的未知结果赋为负、组 B 的未知结果赋为正,得到 50% 对 80%。相反的赋值得到 70% 对 20%。核对组 A 加组 B:选定二十、已知十二、正例七、未知八。
缺失原因台账
| 组别 | 原生状态 | 人工验证 | 合格样本成员身份 | 未知数量 |
|---|---|---|---|---|
| A | no_public_captions | 未知 | 合格 | 1 |
| A | blocked_or_challenged | 未知 | 合格 | 1 |
| B | no_public_captions | 未知 | 合格 | 2 |
| B | language_unavailable | 未知 | 合格 | 2 |
| B | blocked_or_challenged | 未知 | 合格 | 1 |
| B | succeeded | 验证未解决 | 合格 | 1 |
无效或超出范围的输入以及重复观察位于合格且不重复的 N 之外,并不是额外的未知视频。
来源和延伸阅读
作者 Chronometrica · 更新日期
返回顶部 ↑