Actorは、ホスト環境で動くデータ収集プログラムです。両製品ともApify Actorです。私たちはChronometricaの提供元であり、この記事で扱う、対象を絞った投稿検索に推奨しています。この比較には、2026年10月20日に取得した製品情報を使っています。同じ条件で行った新たなテスト、実測した速度差、価格面の優位性を報告するものではありません。
利用を検討する人の疑問は具体的です。選んだ複数のサブレディットから、キーワードに一致する投稿をどう集めるか、という疑問です。Redditの公開質問でも、この目的に合うツールを尋ねています。Reddit全体の完全なアーカイブを求めているわけではありません。また、この質問は、返された一致結果がすべて役立つことを示すものでもありません。
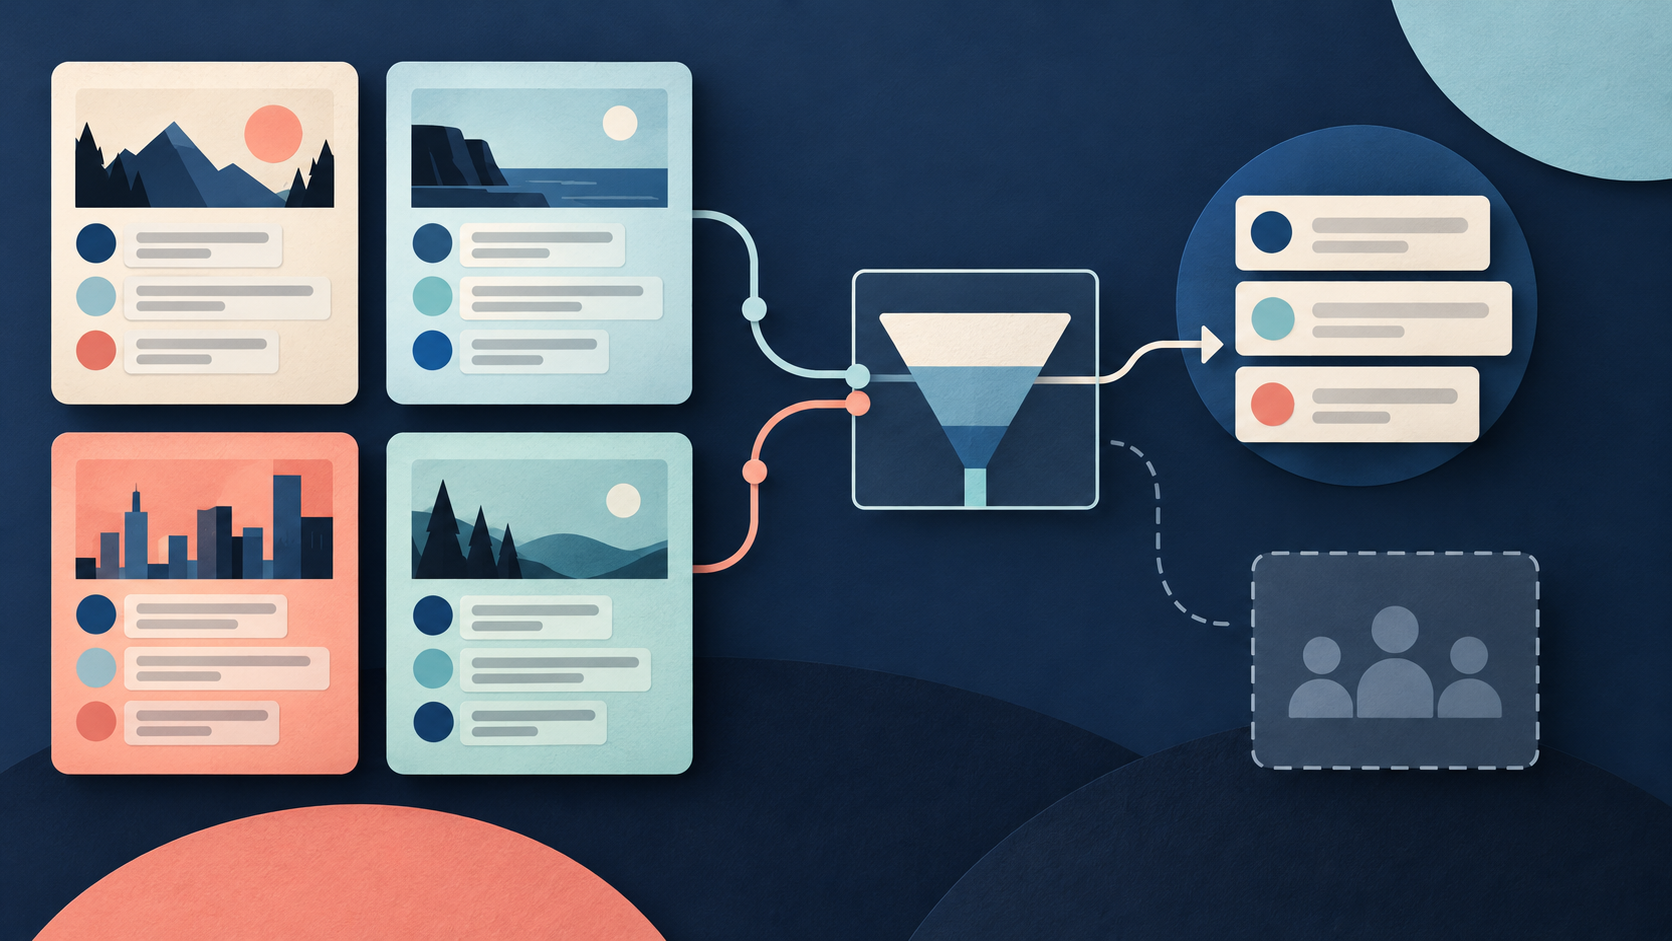
!検索クエリのカードから、確認済みの一致結果と、ノイズ用・不明用に分かれたトレイへ線がつながっている。
まず必要なレコードを選ぶ
キーワード調査では、出力要件を明確にする必要があります。必要なレコードの種類と、各レコードに必要な情報を文書にするということです。
対象を絞った調査なら、次のように定められます。1つのクエリで、指定した2つのコミュニティから投稿を集め、情報源の詳細を保持し、内容を確認する。検索で指定したコミュニティ、各投稿が実際に掲載されたコミュニティ、結果が不完全だった検索を把握する必要があります。
より広い範囲を収集する作業では、異なる種類のレコードが必要です。Trudaxのドキュメントには、投稿、コメント、コミュニティ、ユーザーに加え、サブレディット検索、並べ替え、日付フィルターが記載されています。この対応範囲の広さが、複数の収集作業をまとめる際にTrudaxを選ぶ主な理由です。Trudaxのドキュメント。
| 必要な作業 | 推奨する製品 | 選ぶ理由 |
|---|---|---|
| 指定した複数のコミュニティから、重複のない一致投稿を確認する | Chronometrica | 指定したサブレディットと一致したサブレディットのフィールド、クエリ情報、個別の検索処理結果 |
| 投稿検索と、コミュニティやユーザーの詳細、または既知のスレッドのコメント収集を組み合わせる | Trudax Reddit Scraper Lite | ドキュメントに記載された収集モードの範囲が広い |
出典:Chronometrica、Trudax。
どちらのツールも、設定する前に必要なレコードの種類を書き出してください。各投稿に付いたコメントが必要な問いには、投稿の一覧だけでは答えられません。また、判断に必要なのが確認済みの少数の事例なら、大量の収集は不要です。
この記事では、収集ツールの選び方と出力の定め方を説明します。クエリの関連性を高める方法は、ノイズを減らしてRedditのキーワードを追跡する方法を参照してください。
Chronometricaが明示する情報
Chronometricaのドキュメントには、5つの検索設定が記載されています。`query`、任意の`subreddits`、`maxResults`、`sort`、`time`です。サブレディットを指定する場合、入力できる数は1〜20です。この少数の設定項目は、対象を絞った投稿検索に適しています。Chronometricaのドキュメント。
返される行には、`inputQuery`、`requestedSubreddit`、`matchedSubreddit`、`canonicalPostUrl`、`postId`と、情報源の利用可否を示すフィールドが保持されます。`OUTPUT`では、該当なし、一部取得、失敗など、検索の処理結果も区別されます。これらの情報から、保存した各投稿の情報源と、各検索の状態を確認できます。Chronometricaのドキュメント。
指定したコミュニティと一致したコミュニティは、それぞれ異なる問いに答えます。`requestedSubreddit`は、検索に使ったコミュニティを記録します。`matchedSubreddit`は、返された一致結果に関連するコミュニティを記録します。確認時に両者を比較してください。追加の確認が必要なレコードは、疑問が解決するまで、その点を明示したままにしてください。
後で異なる検索の結果を比較するときには、クエリ情報が重要です。1つの投稿が複数の調査用データに含まれていても、どの検索で見つかったかを明確にする必要があります。ファイル名や記憶に頼らず、出力された`inputQuery`を保持してください。
調査記録では、`postId`を使って投稿を識別してください。確認する人が情報源に戻れるよう、`canonicalPostUrl`も保持してください。利用可否の情報は、情報源を確認できるかどうかの記録に役立ちます。値が欠けている場合や取得できない場合は、その状態を保持してください。0に置き換えないでください。
これらのフィールドは、調査で選んだコミュニティと検索設定の組み合わせを確認するのに役立ちます。ただし、投稿に関連性があることを示すものではありません。その判断には、調査の問いに照らして投稿を読む必要があります。
実行前に合計上限を理解する
上限とは、1回の実行で保存できるレコードの最大数です。Chronometricaの`maxResults`は、実行全体で保存する、重複のない投稿の合計上限です。サブレディットごとに別々の件数が割り当てられるわけではありません。確認したスキーマでは、1〜10,000の値が許可されています。Chronometricaのドキュメントとスキーマ。
2つのサブレディットを指定し、`maxResults`を`12`に設定した場合、保存できる重複のない投稿は合計で最大12件として計画してください。24件として計画してはいけません。また、各コミュニティから6件ずつ集まるとも考えないでください。
この違いは調査設計に影響します。合計上限は、関連する事例を最初に確認する用途に適している場合があります。ただし、コミュニティ間で同じサンプル数を保証するものではありません。同じ件数が必要なら、収集前にその要件を定め、収集計画で満たせるか確認してください。
一致するすべての投稿が必要で、1回の実行で想定される重複のない投稿数が10,000件を超える場合、Chronometricaはその1回の実行に関する要件を満たしません。また、Redditを完全に網羅することも約束していません。上限に達した場合、保存した投稿は、入手可能な証拠のすべてではなく、上限付きのサンプルとして扱う必要があります。Chronometricaのドキュメント。
結果が少ないことは、ほかに関連する投稿が存在しない証拠にはなりません。検索の処理結果、情報源の利用可否、選んだクエリ、コミュニティの一覧は、どれも結論に影響します。
確認済みの小規模な入力から始める
公開されているSearch Posts in Subreddits Taskには、開始用のプリセットがあります。Taskは、保存された入力プリセットです。実行前に入力を確認してください。公開ページが存在するだけでは、現在保存されている設定が正しいと確認されたことにはなりません。
この例では、確認済みのフィールド名と値を使っています。
{
  "query": "open source AI",
  "subreddits": [
    "LocalLLaMA",
    "MachineLearning"
  ],
  "maxResults": 12,
  "sort": "new",
  "time": "month"
}提示した入力は、取得済みの公開JSON Schemaとの照合に合格しました。JSON Schemaは、入力で許可されるフィールドと値を定義するものです。この確認で分かるのは、入力の構造が正しいことです。実際の検索で投稿が返されることを証明するものではありません。この比較では、収集を実行していません。Chronometricaの入力スキーマ。
クエリとコミュニティ名を、調査対象の公開情報源に合わせて置き換えてください。対応している期間設定と並べ替え設定から、調査に合うものを選んでください。収集前にそれらを記録し、どのような検索を意図したかを別の確認者が理解できるようにしてください。
例えば、最近の議論を調べるなら、期間を定める必要があります。有用な事例を調べるなら、関連性の基準を文書にする必要があります。収集用の入力が小規模でも、こうした選択は調査計画に含めてください。
架空の例:12件を保存し、9件を採用
次の例は架空のものです。Actorのテスト、実際のデータセット、顧客の実測結果ではありません。
ある分析担当者が、指定した2つのサブレディットで、オープンソースAIに関する議論を調べます。重複のない投稿の合計上限を12件に設定します。この調査では、オープンソースAIモデルの利用に関する実務上の選択を論じている投稿を、関連する投稿とします。その語句に軽く触れているだけの投稿は対象に含めません。
この架空の検索では、一方のコミュニティから7件、もう一方から5件の、重複のない投稿が保存されます。
`7 + 5 = 12 unique saved posts`
分析担当者は、`requestedSubreddit`と`matchedSubreddit`を照合し、各`postId`を保持します。その後、12件すべての投稿を読みます。3件には検索語句が含まれていますが、調査の問いには答えていません。9件が基準を満たします。
`12 saved posts − 3 irrelevant posts = 9 accepted posts`
12件すべてが有効な検索結果でも、有用な証拠になるのは9件だけということがあります。収集の成功と調査上の関連性は、別々に確認する必要があります。
この例は、合計上限を慎重に理解する必要がある理由も示しています。上限は、両コミュニティを合わせて12件でした。`12 × 2 = 24`ではありません。7件と5件に分かれたことは、一方のコミュニティのほうが、その話題を頻繁に議論している証拠にはなりません。示しているのは、保存したサンプルの内訳だけです。
分析担当者は、採用した9件の投稿を使って、そこに含まれる疑問や懸念を調べられます。ただし、この小規模なキーワードサンプルだけで、それらの懸念がReddit全体でどの程度広がっているかを推定することはできません。
5段階の採用判定方法を使う
1. 調査の問いと情報源の組み合わせを定める
キーワード、サブレディット、使う予定の期間設定と並べ替え設定を明記してください。次に、関連する投稿の条件を1文で定義してください。
有用な関連性の基準では、対象と必要な証拠を明確にします。「指定のキーワードを含む」は収集の基準です。「その製品カテゴリに関する実務上の問題を説明している」は、調査の基準に近いものです。判断の目的に合う基準を選んでください。
自分の調査ノートに検索管理表を作ってください。クエリ、指定したコミュニティ、使う予定の設定、合計上限、収集日を記録します。この表は、収集ツールに何を求めたかを説明します。また、条件が定まっていない検索を、後で読む人が完全な調査として扱うことも防ぎます。
2. 収集モードを選ぶ
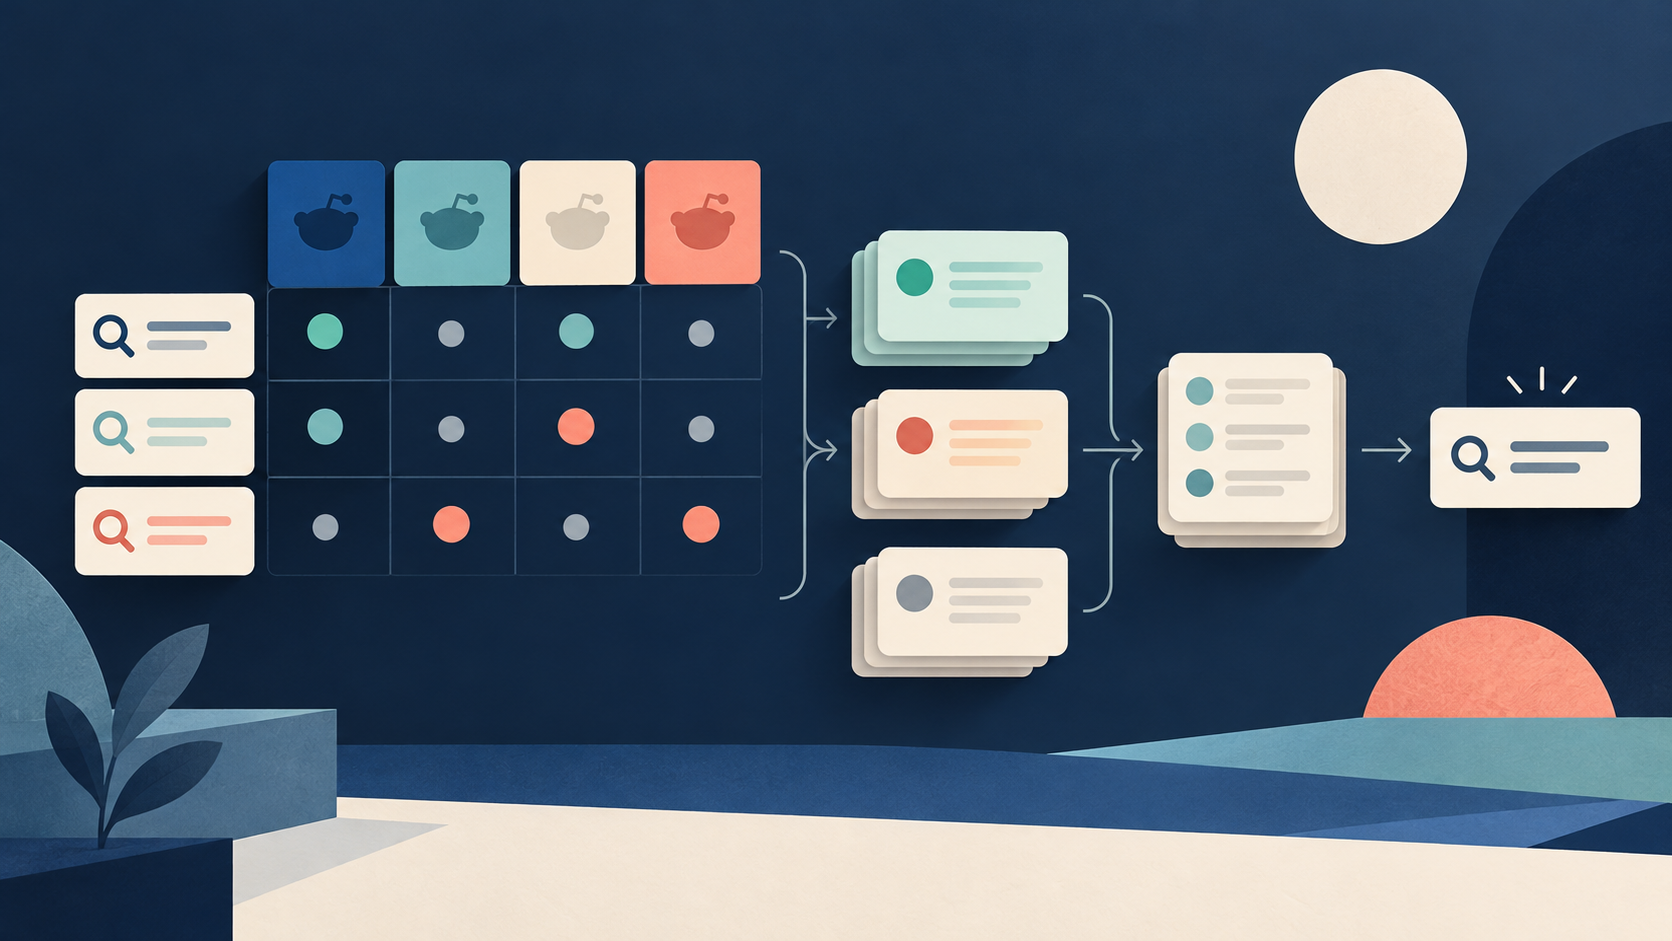
必要なレコードの種類に基づいて製品を選んでください。対象を絞った投稿検索のデータセットなら、Chronometricaのドキュメントに記載されたフィールドと検索の処理結果が、この採用判定方法に適しています。Chronometricaのドキュメント。
Trudaxの検索モードでは、`startUrls`を空にするか、意図した検索URLを使ってください。READMEには、`startUrls`が検索設定より優先されると記載されています。Trudaxのドキュメント。
開始前に実際の入力を確認してください。適切な製品でも、入力が意図した作業を表していなければ、目的に合わないデータが収集される場合があります。
3. 上限を設定し、重複のない調査記録を保持する
自分で確認できる保存投稿数の合計上限を選んでください。最初の収集は、大きなサンプルを集める前に関連性の基準の曖昧さを見つけられるよう、小規模にしてください。
重複のない投稿1件につき、調査記録を1件保持してください。投稿識別子、情報源のURL、クエリ情報、コミュニティのフィールドを保持します。確認メモは、収集した本文と分けて保存してください。読む人が情報源の内容と自分の判断を区別できるようにするためです。
コミュニティ間で行数が同じになると考えないでください。比較に均等な件数のグループが必要なら、件数が均等であることを明確な採用条件にしてください。収集後、グループを比較する前に確認してください。
4. 処理結果と情報源の詳細を確認する
投稿の行だけでなく、検索ごとの処理結果も読んでください。該当なしの検索、一部取得の検索、失敗した検索は、それぞれ異なる扱いが必要です。Chronometricaのドキュメントでは、これらの状態が区別されています。Chronometricaのドキュメント。
該当なしという結果は、その検索が何を返したかを示します。その話題に関する議論が存在しない証拠にはなりません。一部取得の場合は、結論に制約があることを明示する必要があります。失敗した検索は、評価または再実行できるまで未解決のままです。
指定したコミュニティと一致したコミュニティを比較し、投稿識別子を確認し、利用可否の情報を保持してください。未解決の検索は検索管理表に残してください。削除すると、完了した収集の範囲が、証拠で裏付けられる範囲より広く見えてしまいます。
5. 各投稿を読み、判定を記録する
自分のメモでは、短い採用判定コードを使ってください。例えば、`accept`、`reject`、`unknown`を使えます。これらは分析担当者向けに提案するラベルであり、Actorの出力フィールドについて述べたものではありません。
内容が関連性の基準を満たす投稿は採用してください。明らかに基準を満たさない投稿は除外してください。内容の欠落や意味の不明確さで判断できない場合は、`unknown`を使ってください。別の人が判断を確認できるよう、短い理由を添えてください。
保存した投稿、採用した投稿、除外した投稿、未解決の投稿を分けて報告してください。件数を0と数えるのは、0件だと確認した場合だけにしてください。欠損値や不明な値は、分かる形で残してください。
この方法により、判断を確認できるサンプルを作れます。ただし、検索結果の抜粋や返された投稿が、Reddit全体での広がりを測る指標になるわけではありません。調査範囲の定め方については、Redditでの顧客調査の範囲を参照してください。
サンプルが有用だと確認してから継続監視を加える
キーワード収集を時間の経過に沿って繰り返し、変化に対応するようになると、継続監視になります。この比較では、アラートの自動配信は確認していません。通知が必要なら、定期実行と配信の手順を別途追加してください。
まず、そのクエリで有用な投稿を取得できることを確認してください。次に、収集頻度、確認済みの投稿を識別する方法、採用した結果の受信者を決めてください。`postId`を保持すると、過去の調査記録と照合するための投稿識別子を使えます。その照合は、継続監視の処理で行う必要があります。
定期実行する各検索に、収集の処理結果も残してください。そうしないと、検索の失敗が、投稿の少ない期間のように見える場合があります。同じ理由で、不明な結果も分かる形で残してください。
アラートにも確認の基準を設けてください。キーワードへの言及には、確認する価値があっても、即時通知するほどの価値はない場合があります。適切な基準は、受信者が取れる行動によって決まります。収集量を増やす前に、確認済みの小さなサンプルで、その判断を試してください。
出典と参考資料
著者 Chronometrica · 更新日
ページの先頭へ ↑