Elija Apify Facebook Pages Scraper si su trabajo requiere su mayor variedad de campos de contacto, valoraciones o detalles de la página. Esta es la condición principal que cambia la recomendación. Ambos Actors aceptan páginas y perfiles. Apify Facebook Pages Scraper
Esta comparación utiliza los contratos públicos de los productos revisados el 20 de octubre de 2026. Un contrato es la descripción documentada de las entradas y salidas. Ninguna ejecución nueva de recopilación respalda este artículo. La recomendación se refiere al ajuste entre los campos que necesita y esos contratos.
Empiece por el conjunto de datos de páginas que necesita
Un lector preguntó en una conversación pública por qué plataformas como LinkedIn y Facebook no facilitan el acceso a los datos públicos mediante una API. Una API permite que un programa solicite datos. La conversación incluye datos de páginas de empresas de Facebook y eventos públicos. Muestra un problema amplio de acceso, más que una solicitud de una herramienta de extracción concreta. Conversación de lectores
Un Actor de páginas aborda una parte más pequeña de ese problema: recopilar registros a partir de direcciones conocidas de páginas públicas. Para elegir uno, debe definir con claridad qué resultados necesita. Una lista de nombres y recuentos tiene una finalidad distinta de una lista de contactos o una tabla de horarios comerciales.
Empiece por escribir qué decisión debe permitir tomar el conjunto de datos. Por ejemplo, puede necesitar confirmar qué página pertenece a cada empresa antes de importar un recuento. O puede necesitar datos de contacto para un proyecto de investigación. Estas necesidades requieren reglas de aceptación distintas.
La pregunta original sobre el acceso no demuestra que las etiquetas de precisión sean importantes para todos los compradores. Son importantes si su proceso debe distinguir un recuento preciso de un valor mostrado con menor precisión. Defina este requisito de forma explícita antes de elegir una herramienta.
Compare los contratos de salida
Use esta tabla para decidir qué revisar primero. Cada campo que su trabajo requiera debe tener un lugar claro en el contrato elegido.
| Criterio de decisión | Chronometrica Facebook Channel Scraper | Apify Facebook Pages Scraper |
|---|---|---|
| Entrada necesaria | URL proporcionadas de páginas o perfiles públicos mediante `startUrls` | Entradas de páginas o perfiles; revise su esquema de entrada |
| Unidad de salida necesaria | Una fila de resultados por cada entrada única | Compruebe si su estructura de salida coincide con la unidad que necesita |
| Regla para datos ausentes | Revise `status` y `statusReason`; conserve los valores desconocidos | Defina una regla de aceptación a partir de su salida documentada |
| Campos necesarios | Entrada proporcionada, `channelUrl`, `countPrecision`, `observedAt`, `status` y `statusReason` | Mayor variedad de datos de contacto, valoraciones y detalles de la página |
| Límite principal | Contrato documentado más reducido para los registros de páginas | Confirme que su mayor variedad de campos cumple su requisito concreto |
| Condición que cambia la elección | Un campo necesario queda fuera de lo que garantiza el contrato | Se necesita su mayor variedad de detalles de la página |
Los datos de los productos proceden de la documentación pública de la fecha indicada. Las funciones no documentadas siguen siendo desconocidas. Actor de Chronometrica · Apify Facebook Pages Scraper
Lea la tabla partiendo de la salida que necesita para llegar a la herramienta. Si un campo es esencial y el contrato no lo garantiza, debe realizar más comprobaciones. No necesita deducir que otra herramienta carece de él.
Un contrato más reducido es adecuado si cubre todo el trabajo. Los campos adicionales son útiles si cambian una decisión o evitan un paso posterior de recopilación. Anote esa finalidad para cada campo antes de ampliar el conjunto de datos.
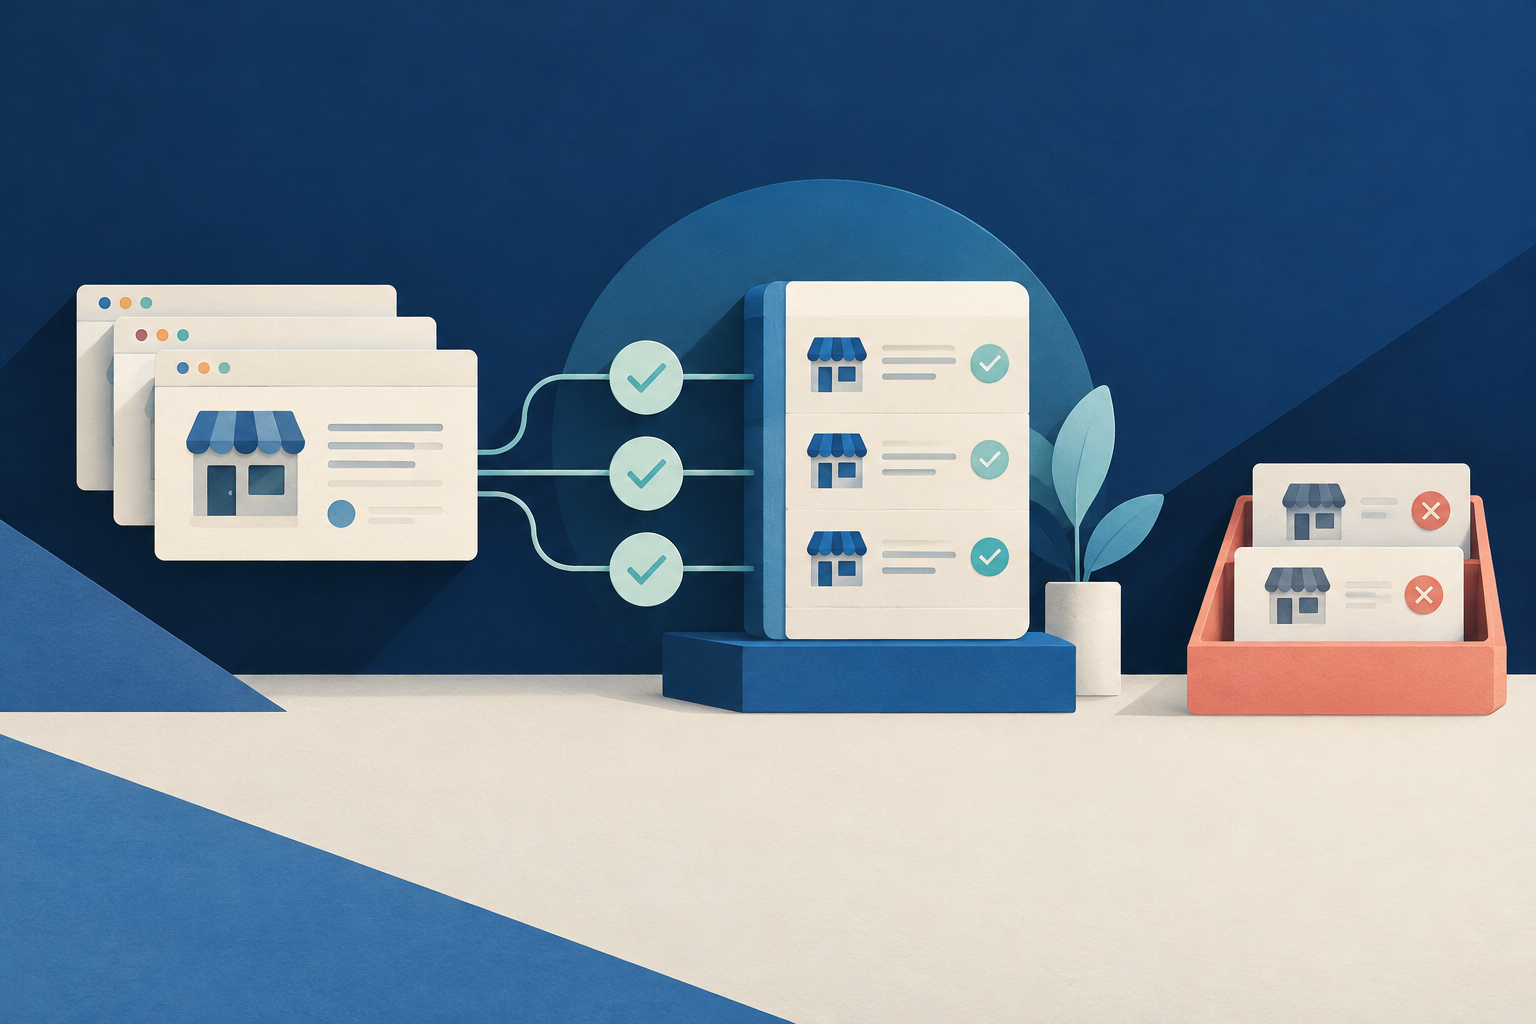
Defina qué debe cumplir un registro de página para aceptarlo
Antes de ejecutar un Actor, escriba una lista breve de campos. Separe los campos necesarios para identificar la página de los necesarios para medirla.
Un campo de identidad ayuda a determinar qué página describe un registro. Un campo de medición contiene un valor observado en esa página. La fecha y hora de observación indican cuándo se recopiló ese valor. El estado del resultado indica si el resultado de la recopilación es apto para su uso.
Para el proceso de verificación de registros, siga estos pasos:
- Indique con qué página proporcionada debe poder relacionarse cada registro.
- Exija una dirección canónica de la página cuando sea posible determinar su identidad.
- Indique qué recuento u otra medición necesita para su tarea.
- Defina qué precisión es aceptable para el uso previsto.
- Establezca una antigüedad aceptable para la observación.
- Defina cómo se enviarán a revisión los resultados incompletos o fallidos.
Una dirección canónica es la dirección estándar que identifica una página en el registro devuelto. Permite comparar registros que partían de distintas direcciones proporcionadas.
Su regla de aceptación debe responder a su tarea. Una lista para una selección preliminar puede admitir un recuento menos preciso. Un cálculo que dependa de diferencias pequeñas puede requerir un valor más preciso. Establezca la regla antes de revisar los resultados. Así evitará cambiarla para adaptarla a los valores que aparezcan.
Distinga también los campos obligatorios de los opcionales. La ausencia de un campo opcional puede permitir que el registro siga siendo útil. Si falta un campo obligatorio, el registro aún no permite tomar la decisión prevista.
Mantenga separadas la entrada proporcionada y la identidad de la página
La dirección que envía y la identidad de la página que acepta tienen finalidades distintas. Mantenga ambas disponibles durante la revisión.
Chronometrica documenta la entrada proporcionada y un `channelUrl` canónico. Su esquema de `startUrls` acepta de 1 a 1.000 URL de páginas o perfiles públicos de Facebook. Las entradas duplicadas se comprueban una sola vez. Cada entrada única genera una fila de resultados y suma consumo. Actor de Chronometrica
Estas reglas describen el tratamiento de las entradas. No demuestran que cada dirección única represente una empresa distinta. Puede ser necesario comprobar la identidad de 2 direcciones distintas antes de tratar sus registros como entidades separadas.
Mantenga separados estos 3 totales:
- El número de direcciones proporcionadas.
- El número de entradas únicas procesadas.
- El número de identidades de páginas aceptadas tras la revisión.
Use el primer total para entender la lista enviada. Use el segundo para comprobar que los resultados de la recopilación corresponden a las entradas. Use el tercero para describir el conjunto de datos que puede utilizar.
Relacione cada fila devuelta con la dirección proporcionada. Después, revise `channelUrl`. Compruebe si esa página corresponde a la entidad prevista mediante los datos de identidad disponibles. Si la correspondencia sigue siendo incierta, mantenga la fila en revisión.
Esta comparación ayuda a elegir un contrato de recopilación antes de crear un conjunto de datos. Para conocer el proceso completo de comprobación de registros de páginas dentro de un directorio existente, consulte Cómo verificar registros de páginas de Facebook en un directorio de empresas locales.
Lea cada recuento junto con su precisión y su fecha y hora
Un recuento necesita contexto antes de usarlo en un cálculo. Chronometrica documenta `countPrecision` y `observedAt` como parte de su contrato de salida. Compruebe ambos junto con la medición que desea utilizar. Actor de Chronometrica
`countPrecision` indica cómo se califica la precisión del recuento devuelto. Use el significado documentado del valor devuelto. No suponga que un valor numérico es exacto solo porque se puede almacenar como número.
`observedAt` indica la fecha y hora de observación. Le ayuda a decidir si el registro es lo bastante reciente para su tarea. No establece un historial de valores anteriores.
Realice 3 comprobaciones:
- Confirme que la medición está presente.
- Confirme que su precisión cumple su regla.
- Confirme que su fecha y hora de observación cumplen su límite de antigüedad.
Mantenga juntos el valor de origen y su indicador de precisión al exportar o importar datos. Si conserva el recuento pero elimina su precisión, otros usuarios pueden atribuirle más certeza de la que permite el registro. Si elimina la fecha y hora de observación, no podrán evaluar su antigüedad.
Conserve los valores ausentes como desconocidos. El 0 es un valor que puede afectar a totales, promedios, clasificaciones y filtros. Use 0 solo cuando la medición devuelta lo respalde. Un recuento vacío o no disponible no permite llegar a esa conclusión.
Para comparar páginas, decida si son aceptables distintas fechas y horas de observación. Su regla puede admitir un intervalo de recopilación, pero debe definirlo con claridad. El Actor aporta datos para decidir si acepta el registro; su tarea determina la regla.
Revise el estado del resultado antes de importar
Una fila devuelta registra un resultado de recopilación. Su mera presencia no demuestra que todos los datos necesarios estén disponibles.
Chronometrica documenta `status` y `statusReason` para revisar los resultados. Interprete el estado devuelto según su significado documentado. Examine el motivo cuando explique un resultado que requiere atención. Actor de Chronometrica
Use 3 grupos internos de revisión. Son etiquetas del proceso de trabajo, no valores de estado que el Actor prometa devolver:
- Aceptar: La identidad es adecuada, los valores obligatorios están presentes y la precisión y la fecha y hora cumplen sus reglas.
- Revisar: La fila necesita una comprobación de identidad, una explicación u otra decisión antes de utilizarla.
- Retener sin importar: Con los datos disponibles, la fila no permite el uso previsto.
Conserve las filas en revisión y las retenidas entre sus registros de trabajo. Explican la diferencia entre la lista enviada y el conjunto de datos aceptado. Si las elimina demasiado pronto, una recopilación incompleta puede parecer completa.
Compruebe que cada entrada única corresponde a una fila de resultados. Después, compruebe que cada fila de resultados tiene una decisión interna de revisión. Investigue cualquier diferencia sin explicar antes de comunicar el total final aceptado.
Si repite la recopilación más adelante, conserve suficiente contexto para distinguir el resultado anterior de la observación posterior. Esta es una regla para gestionar sus propios registros. No añade la recopilación de datos históricos al alcance documentado del Actor.
Ejemplo ficticio: 20 direcciones de páginas
Este ejemplo es ficticio. No es un conjunto de datos real, una prueba del producto, una cita de un comprador ni un resultado de costes medidos.
El equipo de un directorio proporciona 20 direcciones de páginas públicas de Facebook. Antes de importar, necesita una identidad canónica, un recuento observado con precisión adecuada, una fecha y hora de observación y un estado del resultado. No necesita un perfil empresarial más amplio.
El equipo elige Chronometrica porque el contrato documentado para verificar filas cumple esos requisitos. Prepara una hoja de aceptación con un espacio para cada dirección proporcionada y columnas para su decisión de revisión.
Primero, el equipo busca entradas duplicadas en la lista proporcionada. Usa el total resultante de entradas únicas para comprobar la correspondencia de las filas devueltas. No supone que las 20 direcciones proporcionadas se convertirán en 20 entidades aceptadas.
Después, comprueba si cada `channelUrl` corresponde a la empresa prevista. Revisa el recuento necesario, lee `countPrecision` y compara `observedAt` con su regla de antigüedad. Luego revisa `status` y cualquier `statusReason` pertinente.
El equipo conserva los recuentos desconocidos y mantiene en revisión las identidades sin resolver. Solo comunica el número de entidades aceptadas después de estas comprobaciones. Este ejemplo no asigna ninguna tasa de éxito inventada ni un total final de entidades aceptadas.
Si el mismo equipo necesita más adelante horarios comerciales o valoraciones, evalúa la mayor variedad de detalles de páginas de Apify Facebook Pages Scraper antes de elegir el contrato de recopilación. Apify Facebook Pages Scraper
Empiece por la Task y compruebe la entrada
Una Task es una configuración de entrada guardada para un Actor. La Facebook Page Data API Dataset Task publicada ofrece un punto de partida para este proceso.
Se comprobó que la página de la Task estaba disponible. La comprobación registró HTTP 200, una respuesta correcta de la página y el título previsto de la Task. Esa comprobación no confirma su entrada guardada actual. Antes de ejecutar, aplique la entrada que desea utilizar y compruébela con el esquema actual del Actor.
Esta entrada mínima superó las comprobaciones estáticas con el esquema público almacenado en caché:
{
  "startUrls": [
    "https://www.facebook.com/MrBeast/"
  ]
}Las comprobaciones estáticas evalúan la estructura de la entrada. Abarcan los nombres de campos, los campos obligatorios, las opciones permitidas, el tamaño de las listas, los patrones de texto y los límites numéricos, cuando corresponda. No demuestran que la página de ejemplo esté disponible ahora ni que una recopilación devuelva datos aceptables. Sustituya la dirección de ejemplo por la fuente pública que desea utilizar. Actor de Chronometrica
Siga esta breve secuencia práctica:
- Escriba los campos que necesita y las reglas de aceptación.
- Prepare las direcciones conocidas de páginas públicas.
- Compruebe la entrada con el esquema actual.
- Ejecute una recopilación con un conjunto pequeño que represente las fuentes que desea utilizar.
- Revise la identidad, la precisión, la fecha y hora y el estado del resultado.
- Amplíe la recopilación cuando los registros devueltos cumplan sus reglas.
El conjunto pequeño debe ayudarle a evaluar su propio proceso. Registre qué proporcionó, qué recibió y por qué se aceptó o se retuvo cada fila. Una prueba útil responde a estas preguntas antes de que se comprometa con una importación mayor.
Fuentes y lecturas adicionales
- Chronometrica Facebook Channel Scraper: documentación pública y esquema de entrada, revisados el 20 de octubre de 2026; respaldan el contrato de entrada y salida descrito; no se realizó ninguna ejecución nueva de recopilación para esta comparación
- Apify Facebook Pages Scraper: documentación pública y esquema de entrada, revisados el 20 de octubre de 2026; respaldan la comparación sobre su mayor variedad de detalles de páginas; no se realizó ninguna ejecución de rendimiento en condiciones equivalentes
- Facebook Page Data API Dataset Task: la comprobación de disponibilidad registró HTTP 200 y el título previsto; no se proporcionó la fecha de comprobación; la comprobación no confirma la entrada guardada actual ni una ejecución correcta de recopilación
- Conversación de lectores sobre el acceso a datos públicos de plataformas: incluye datos de páginas de empresas de Facebook y eventos públicos; no se proporcionó la fecha de comprobación; aporta contexto de lectores, no una recomendación de un proveedor ni una prueba comparativa verificada
- Cómo verificar registros de páginas de Facebook en un directorio de empresas locales: método más completo de verificación de directorios; no se proporcionó la fecha de comprobación; ofrece orientación relacionada, no pruebas comparativas de productos
Por Chronometrica · Actualizado
Volver arriba ↑